SoulDub是什么
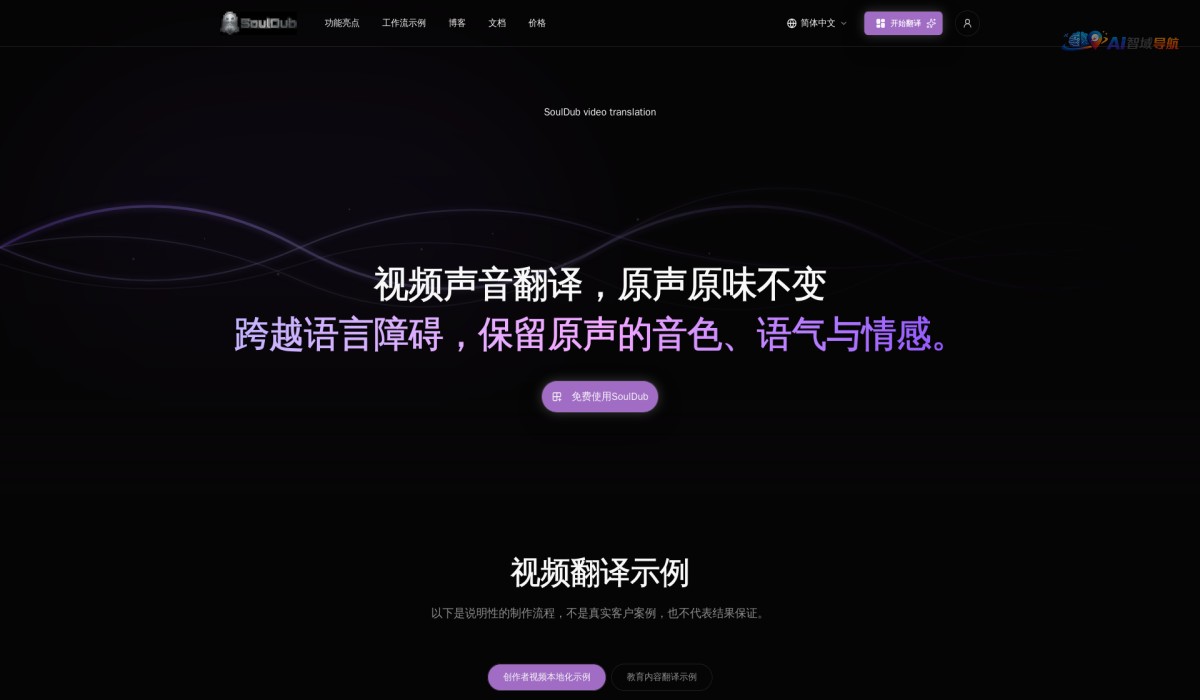
SoulDub是一个面向视频创作者、跨国企业及内容本地化团队的智能平台,核心能力是将任意语言的视频自动翻译为目标语言,并生成与原声音色、语调、情感高度一致的配音。它区别于传统机械式配音,通过声音克隆与语音合成技术,让翻译后的视频听起来仍像原讲话者在“说另一种语言”,从而大幅提升观看体验。
核心功能
- 原声保留配音:提取视频中的说话人音色,在翻译后复用该声纹模型,避免“换人”的突兀感。
- 多语言支持:覆盖主流语种及部分小语种,适用于短视频、课程、纪录片、企业宣传等场景。
- 字幕与口型对齐:自动生成翻译字幕,并可依据音轨时长调整节奏,部分场景支持粗略口型同步。
- 批量处理:支持多视频同时上传,适合规模化内容出海或课程本地化运营。
使用流程
- 上传视频:拖拽或选择本地文件,支持MP4、MOV、MKV等常见格式。
- 选择语言:设置源语言与目标语言,并指定是否需要保留原声。
- 智能处理:系统自动分离音轨、识别语音、翻译文本,并克隆原声进行合成。
- 预览与导出:在线试听翻译效果,可微调字幕措辞或音调后输出成品。
适用场景
| 场景 | 优势 |
|---|---|
| 海外自媒体运营 | 保留个人IP声音,提高粉丝认同感 |
| 企业培训视频 | 统一讲师音色,降低多语言制作成本 |
| 影视解说/纪录片 | 减少真人重新配音费用,加快上线速度 |
| 网课与知识付费 | 让同一位老师“说出”多种语言,扩大受众 |
SoulDub的核心价值在于“用你的声音,讲世界的话”,适合对声音一致性要求较高的视频本地化需求。