AI Humanizer Benchmark

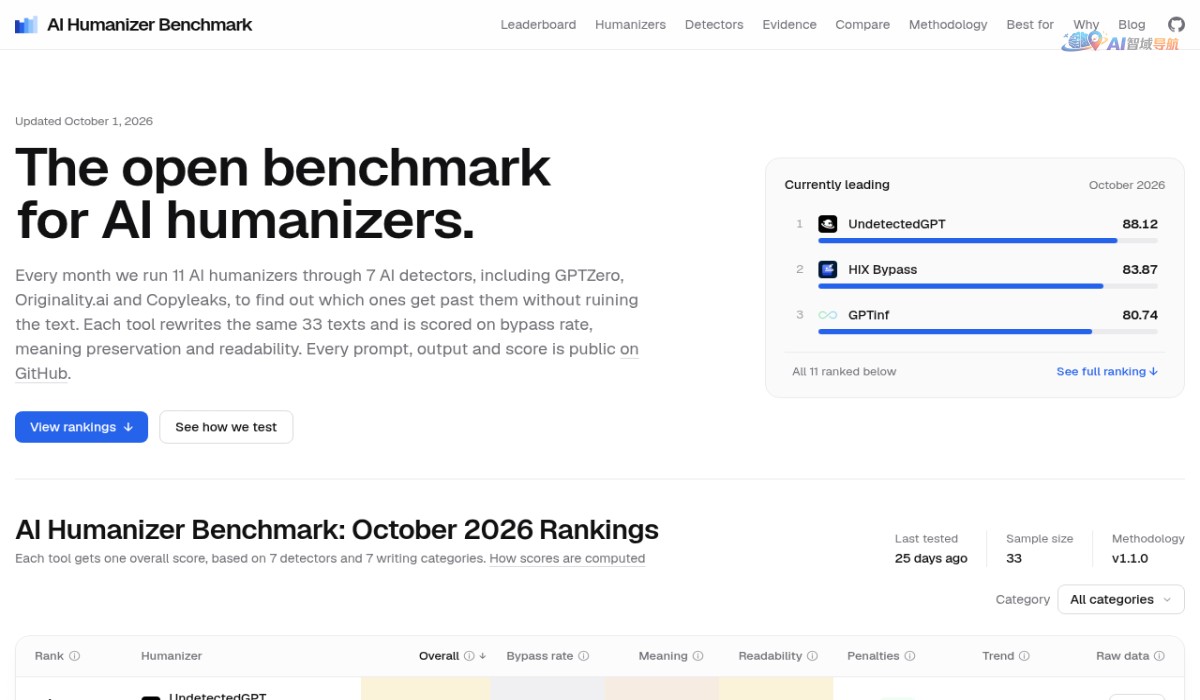
AI Humanizer Benchmark 是一个公开的月度评测平台,通过标准化测试与证据存档,定期发布 AI 去机器化改写工具的性能排名。
访问官方网站
扫码查看

AI Humanizer Benchmark是什么
这是一个专注于评估“AI 拟人化工具”实际效果的公开基准项目。它不像普通评测网站那样只给主观打分,而是每月更新一套可复现的测试结果,记录每种工具在“降低 AI 痕迹”“保留语义准确度”“自然度”等关键维度的表现。所有数据均附带测试样本、提示词和输出证据,方便开发者、内容创作者和研究者横向对比,判断哪款工具真正能让 AI 文本“像人写的”。
核心评测维度
该基准围绕四个核心指标展开:
- 人类倾向分数:文本被识别为 AI 生成的概率,越低越好。
- 语义保留度:改写后原意是否完整,避免过度改写导致信息失真。
- 自然流畅性:句子节奏、用词多样性、语气连贯性,而非机械替换同义词。
- 鲁棒性:面对不同写作风格(学术、营销、故事、对话)时表现的稳定性。
月度排名与证据存档
- 每月初更新上一轮完整排名,包含各工具的平均分和单项分。
- 每个排名后附有测试样本的原始输出摘录,公开可查,确保分数有据可依。
- 历史版本会长期保留,方便追踪各工具的升级迭代轨迹。
评测流程与数据来源
整个评测采用固定测试集和统一评分管线,尽量减少人为误差。
- 收集样本:从真实使用场景中采集覆盖多种文体和主题的原始文本。
- 批量处理:将样本输入候选 AI Humanizer 工具,不进行额外提示优化。
- 双盲评分:由多组独立评估者分别打分,再结合自动检测器交叉验证。
- 汇总发布:整理分数、输出证据和异常案例,形成当月的 benchmark 报告。
适合谁使用
| 人群 | 使用价值 |
|---|---|
| 内容创作者 | 挑选最可靠的改写工具,避免内容被平台标记为 AI |
| 开发者 | 参考评测数据选择 API 或自研模型优化方向 |
| 研究者 | 获取标准化证据,分析不同算法的拟人化策略差异 |
| 企业决策者 | 根据长期排名评估工具稳定性,降低采购风险 |
榜单之外的洞察
除了简单排名,该平台还会额外公布有趣现象:例如某些工具在小样本上表现优秀,但面对长文本时分数骤降;部分工具通过插入错别字或语法破碎来“骗过检测器”,但在可读性上被扣分严重。这些细节能帮助使用者理解“拟人化”的深层逻辑——真正优秀的产品应当在“不可检测”和“可读性”之间找到平衡,而非依赖表层技巧。