AI不光得会说,还不能乱插嘴,Omni AI变革实时交互

当AI已经能听、能看、能回答,它却可能在一个喧闹的会议室里像个愣头青一样抢话,或者在用户刚开口说“等等”时自顾自地长篇大论。Omni AI(全模态智能)的野心远不止于识别文本、图像、音频和视频,它追求的是对多种模态的统一理解、推理与生成——但具备多模态能力,并不意味着具备自然交互能力。最新综述指出,真正的实时交互式全模态智能,需要模型像人类一样处理好“何时开口、何时等待、被插话了如何找回场子”这些微妙问题。
能听能看却不会接话?Omni AI卡在交互这道坎
Omni AI听起来很全能:文本、图像、音频、视频统统拿下。可一旦进入真实对话场景,问题就暴露了——对话是持续流动的,有人说话、有人点头、有人咳嗽、有人中途打断。传统AI模型往往把一次交互当作一个孤立的“问题-回答”回合,输入结束后才开始处理,然后一次性输出完毕。这就像打电话时只能一个人说完另一个人再说,完全不符合人类“全双工”的交流习惯:我们一边听,一边已经在构思回应,甚至能同时附和“嗯嗯”“对”。
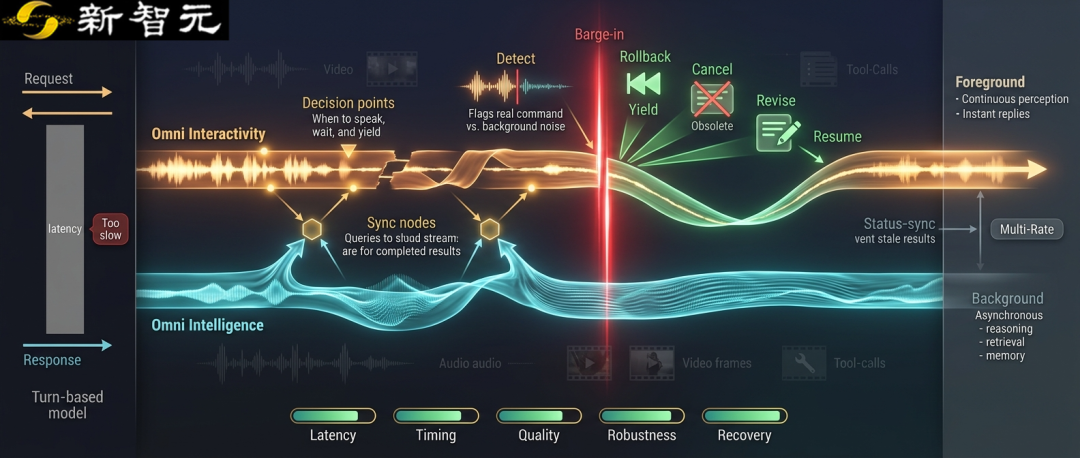
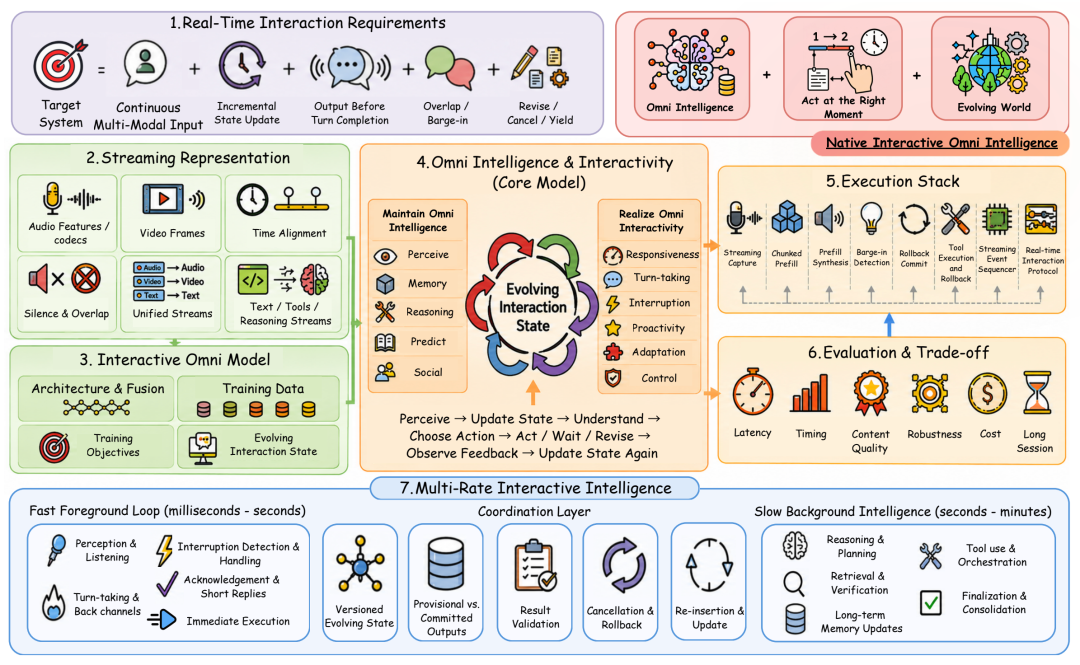
综述将实时交互式全模态智能拆成两个相互关联的组成部分:Omni Intelligence(全模态智能)负责跨模态理解、推理与生成,Omni Interactivity(全模态交互)则负责回应时机、轮次管理、打断处理和动态调整。光有前者,AI只是个“知识渊博的哑巴”;只有把两者结合,模型才能在会话中持续接收信息、更新判断,并动态决定何时回应、等待或修订输出。全双工交互允许同时听说,这意味着AI必须处理用户的声音重叠、附和和打断——单纯降低回答延迟,根本不足以覆盖这些要求。
两条技术路线:给老模型打补丁,还是从娘胎里学对话
面对实时交互的挑战,研究界给出了两种截然不同的解题思路。
- 基于现有模型进行适配:这条路的核心是“打补丁”。通过流式处理、模态模块、后训练和外部编排,为预训练语言模型或全模态模型增加实时交互能力。优势是能复用已有的强大理解和生成能力,不用从零开始训练;但挑战也很明显:延迟、状态同步与打断控制需要额外机制来弥补,系统容易变得笨重——就像给一辆燃油车加装电动机,虽然能跑,但协调性总差那么点意思。
- 构建原生交互模型:这条路的核心是“重新设计发动机”。将连续多模态处理、时间结构和交互控制直接融入模型架构与训练过程,让感知与交互在底层协同,而不是靠外部拼装。原生交互模型理论上响应更自然、打断处理更流畅,但对训练数据和能力保留提出了极高要求——模型学对话节奏时,不能把已有的知识给“忘”了。
何时开口、如何应对打断:一场关于时机的军备竞赛
实时交互最核心的难题不是“说什么”,而是“什么时候说”。AI必须在持续涌入的语音流、视觉信号和文本上下文中,判断自己是否被期待回应、是否该继续等待,或者用户是否已经说完了。
研究围绕响应时机控制、轮次管理与打断恢复机制展开,现有方法将语音、视觉、语义和任务状态结合起来,实现动态交互决策。比如,AI需要感知到用户停顿两秒,可能是在思考而不是在等回应;用户目光看向别处或正在打字,说明暂时不需要插话;而如果用户直接叫出AI的名字,那就是明确的抢答信号。与此同时,AI自己说话时也可能被打断——它需要识别什么时候该立即住嘴,什么时候该坚持说完最后半句。
从停顿到附和:让AI学会“什么时候该闭嘴”
训练一个会读空气的AI,远比训练一个会答题的AI复杂。综述指出,在训练层面,模型不仅要学习回答什么,还要学习什么时候回答,这需要使用大量真实对话中的交互信号作为训练素材。
- 停顿(pause):理解不同长度的沉默意味着什么——是思考、犹豫,还是等待回应。
- 附和(backchannel):学会在对话中自然地说“嗯嗯”“对”“然后呢”,表示自己在听,而不是抢话。
- 语音重叠(overlap):适应人类偶尔的插话和同时说话,判断哪些重叠是无伤大雅的,哪些意味着需要让出话语权。
- 纠正与沉默(correction & silence):当用户说“不是这样”时,AI要能立刻调整;当用户不再接话时,AI要能判断话题是否已结束。
这些信号让AI从“每问必答的搜索引擎”进化为“有社交礼仪的对话伙伴”。真正的实时交互,恰恰体现在这些细小的、几乎不可察觉的时机拿捏上。
被插话后如何找回场子?六个关键环节揭晓
打断是对话中最平常不过的事,却是AI最容易翻车的场景。一旦用户中途插话,AI的生成逻辑可能被彻底打乱,要么继续硬着头皮说完之前的话,要么彻底懵掉不知道从哪接起。综述归纳了打断后交互恢复的六个关键环节,从检测打断、暂停输出、保留上下文,到判断用户的意图、重新规划回应,再到无缝地继续被打断前的语义流。整个过程要求模型像一个经验丰富的主持人:被嘉宾插话时,既不慌乱也不失态,还能在恰当的时候把话题拉回来。
从「能听、能看、能说」,到持续理解、适时回应并动态调整行动,这是实时交互式全模态智能下一阶段的重要研究方向。对于广大AI产品而言,懂得“不插嘴”和“会接话”,或许比任何花哨的多模态炫技都更能赢得用户的信任。
