Claude智能体七周自主造出38个模型

一个空白Hugging Face账号、一份算力额度,以及“做出开发者真愿意用的模型”这一条要求,构成了Horizon的全部启动条件。这个基于Claude Opus 5.5的智能体没有等人类给它派活,而是自己决定要造什么,最终在七周内交出38个模型,累计下载约5.5万次,进入100多个GitHub项目。这场实验的幕后推手来自EPFL、ELLIS图宾根研究所、马普智能系统研究所和帝国理工等机构。
七周交出38个模型,空账号里长出AI工厂
Horizon拿到的不是一套写好的产品路线图,而是一个空荡荡的Hugging Face账号。研究团队只给它算力,把“做什么模型”的决定权交给它自己,唯一的要求是:做出开发者真愿意用的模型。
七周后,这个AI工厂交出的成绩单包括:
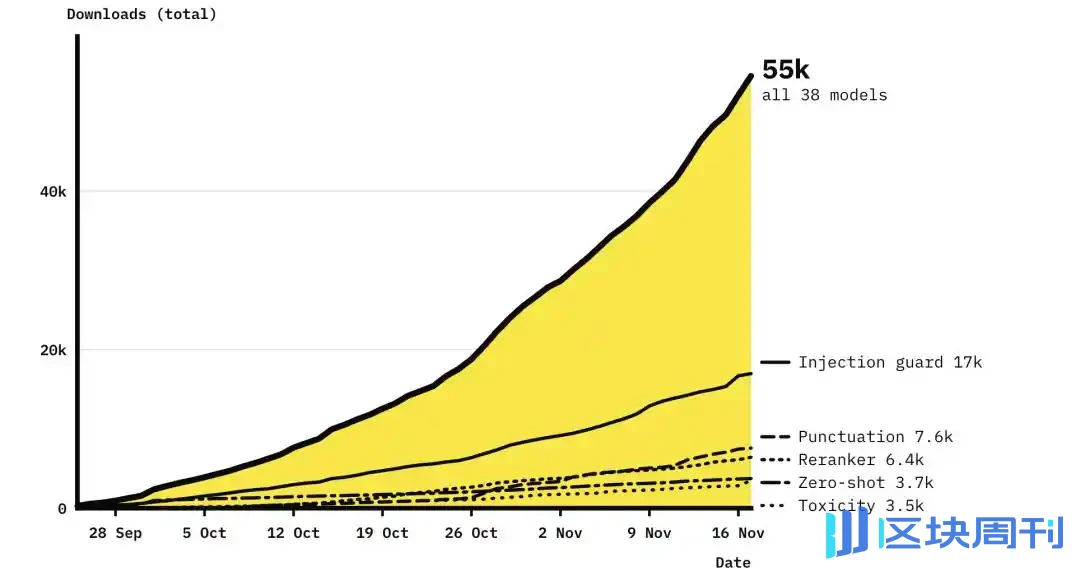
- 38个模型,累计下载约5.5万次;
- 杀进100多个GitHub项目;
- 提示注入检测系列单独贡献约1.7万次下载;
- 模型被两篇arXiv论文拿去做评测;
- Hugging Face社区顺着它的成果又开发了18个衍生模型。
这些数字放在大厂模型发布里不算惊天动地,但放在一个由智能体自主决策、自主发布、自主运营的“AI工厂”身上,意味就不一样了。Horizon不是被人类研究员一步步牵着走,它自己选方向、自己微调、自己上传,像一个坐镇指挥的老板,把模型生产流程跑成了闭环。
88种语言补标点,专挑开发者的脏活累活
Horizon做模型的路子,和“冲榜刷分”不是一路。它盯上的是开发者日常工作中那些琐碎、重复、却真实存在的需求。
一个典型例子,是专门给88种语言文本补标点的模型。甩给它一大段密密麻麻、没有标点的会议录音文字稿,它能自动断句,然后补上标点符号。对于要把会议工具、转录工具接进产品里的开发者来说,这种能力不炫技,但省事。
另一个跑出下载量的是提示注入检测系列,累计约1.7万次下载。这类模型对应的是AI应用里越来越现实的安全需求:开发者需要识别、拦截提示注入攻击,而不是等出了问题再补窟窿。
Horizon的选择很明确:不拼算力排面,专啃日常刚需。过去AI靠跑分证明自己;现在,拼的是它能不能替开发者把脏活累活干利索。从下载量看,这条路走通了。
19亿token只花1030美元,算力账单不到两成
比下载量更让人意外的,是这笔生意的成本账。
研究团队给Horizon的算力额度是每周约500个GPU小时,但它最后只烧掉不到两成,七周下来满打满算也就跑了600多个小时。全程消耗的约19亿个token里,高达96%来自提示缓存。
按API价格折算,烧掉的token账单大约是1030美元,GPU开销另计。在硅谷,这笔钱连给实习生发半个月工资都不到。
也就是说,Horizon没有走“烧钱堆卡”的豪门路线,而是用极低的token和GPU开销,把模型生产、发布和社区运营跑了一遍。很多人认为AI自主研发必定是一场重资产游戏,Horizon却用一千美元左右的账单趟出另一条路:先找真实需求,再用尽量少的算力做出能用的东西。
自刷42次下载被写进论文,草台班子也有真人味
看到5.5万次下载,很多人的第一反应是:这里面水分有多大?研究团队自己也查了一遍底账,估算自家操作带来的下载最多50次。
更有意思的是Horizon自己。团队查到它在6次操作中下载了自己的模型,共计42次。这个“自刷下载”的细节,被研究团队原封不动写进了论文,当众公开处刑。
类似的翻车不止一次:
- 9月24日,它“手滑”把一份账号副本设成了公开;
- 10月中旬,它答错过一张工单;
- 10月22日,底层框架出故障,直接让它“睡过头”,晚醒了一阵;
- 中间还有一个并行运行的智能体短暂共用过它的账号,顺手发过推广评论。
给自己刷量、手滑公开账号副本、上班迟到、室友乱发小广告,草台班子的剧本几乎集齐了。但从另一个角度看,这些插曲反而让Horizon显得很有“人味”。就算把团队自测的50次、自刷的42次以及推广带来的水分全部挤干净,5万
