从Vibe Video到Vibe World,Claude、GPT与视频模型争当“造物主”?

Vibe Video的走红,先改变的是用户与AI生成内容的关系:过去是看一段视频,现在是进入场景、参与其中,并影响接下来发生的事情。模型从影像中学到的视觉和运动规律,不再只用于生成视频,还能支撑连续的场景变化和实时反馈。也正因如此,通用大模型与视频模型开始在同一张牌桌上相遇:一边是Claude、GPT这类模型借代码和工具切入视觉创作,一边是视频模型凭借视觉知识直接生成画面与动态变化,争夺下一代数字世界的“造物主”位置。
Vibe Video让“看一段”变成“进场景”
视频模型的底气,来自海量图片和视频训练积累的视觉知识。物体外观、材质、光影、人物动作、摄像机运动和场景变化,已经融入模型的视觉表征。OpenAI早期Sora技术报告就展示过,模型在摄像机转动时能够维持场景的3D连续性,让被遮挡的物体重新出现,甚至模拟Minecraft的画面和基本操作。
但这并不意味着物理规则已经被准确掌握。Sora的技术报告同时指出,模型在玻璃破碎等基础物理现象上仍可能生成错误。视觉上的连贯,不等于几何结构和物理规则已经精确。视频模型学到了相当丰富的世界动态规律,却还不能把这些视觉经验完全转化为可计算的物理模拟。
Vibe Video的意义正在这里:它把视频模型从“生成一段可观看的内容”推向“生成一个可进入、可反馈的场景”。当用户从观看者变成参与者,模型输出的就不只是画面,而是连续变化的环境。这为AI游戏、互动叙事和可探索虚拟空间打开了入口,也让通用大模型看到了切入视觉创作场景的机会。
代码派拆资产,视频派直接长画面
两种技术路线的分野已经清晰。
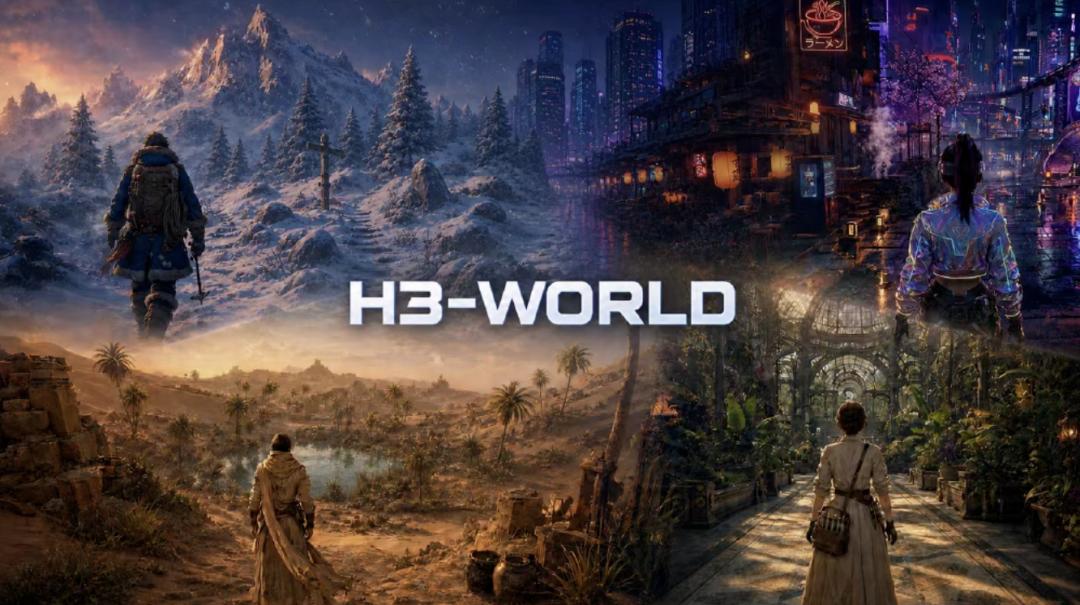
通用大模型倾向于把世界拆解成可以编辑的资产和明确的运行规则。代码不仅能定义物体的外观,还能规定它们如何运动、碰撞和交互。重力、关节、碰撞检测、角色行为等,都可以转化为程序,交给游戏引擎执行。理论上,只要现实中的物理规律和交互关系能够被准确形式化,就有机会通过代码建立相应的模拟环境。Claude、GPT等模型在Coding Agent、工具调用和代码修复上的能力,正好服务于这条路线。
视频模型则利用从海量影像中学到的知识,直接生成画面及其动态变化。它不必逐个编写模型和渲染程序,而是把训练中积累的视觉经验直接拿来用。两条路线正在争夺的,已经不只是互动内容的生产入口,也包括数字世界最终以什么方式生成、运行和持续更新。
换句话说,代码派在搭“可编辑的世界骨架”,视频派在直接长“可观看的世界表皮”。前者强调资产复用、规则控制和明确交互,后者强调画面生成、动态表现和视觉丰富度。它们各有短板:代码派需要把物理规律和交互关系准确形式化,视频派则要解决视觉连贯与物理准确之间的落差。
一张关卡550美元,两种账本开始分叉
成本结构的分叉,让两条路线更难简单替代。
评估AI游戏和互动内容的生产成本,不能只看单次生成花费,还要区分前期生产和后续运行两个阶段。通用大模型需要反复理解需求、编写代码、调用工具和修复错误,复杂任务会消耗大量Token。此前提到的《Saltline》仅生成一个游戏关卡,就耗时约8小时,API成本估算约550美元。不过,这笔成本主要发生在前期生产阶段:一旦标准资产和运行规则搭建完成,交给游戏引擎执行后,常规玩家操作不必每次都重新调用大模型。
视频模型的成本结构不同。它不必逐个编写模型和渲染程序,可以直接利用训练中积累的视觉知识生成内容;但如果整个互动环境依赖视频模型实时生成画面,玩家每次操作都可能触发新一轮推理和生成,成本便会随着交互时长和用户规模持续累积。
这也解释了为什么未来竞争会集中在三个方面:能否生成足够丰富的视觉内容,能否让角色、道具和场景持续响应用户操作,以及能否以合理成本长期运行。目前,视频模型在画面生成和动态表现上更有优势,通用大模型则在资产编辑、复用和明确规则控制上更有优势。两条路线争的不是一次生成谁更惊艳,而是谁能把数字世界长期跑起来。
字节把世界模型推上牌桌,BAT重新围猎入口
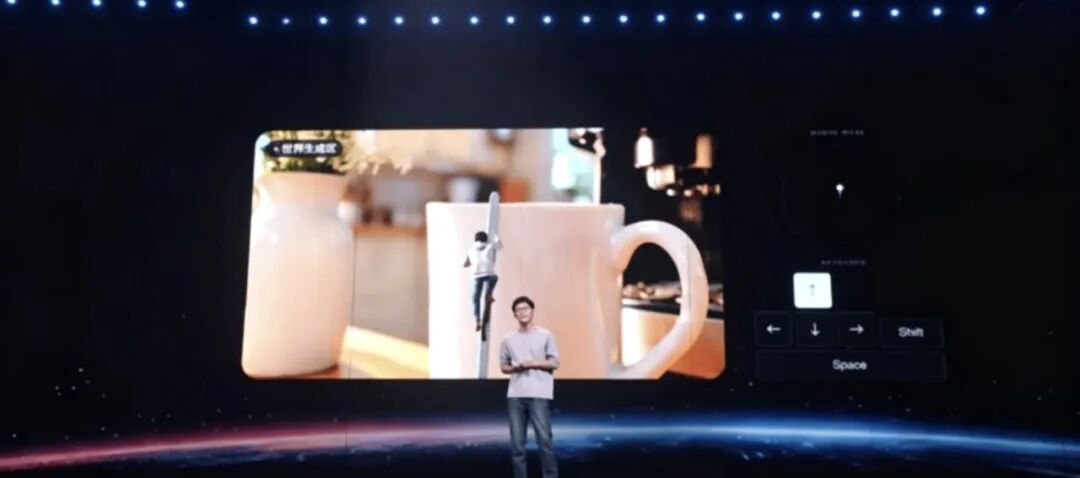
围绕“世界模型”的军备竞赛已经升温。字节跳动基于Seedance视频生成体系打造的世界模型,支持老电影自由运镜、虚拟场景实时交互、VR职业模拟等能力,主打云端渲染的沉浸式空间体验。外媒曾披露,早已卸任字节日常运营的张一鸣,正亲自跨部门协调研发、算力与硬件团队,全程督导这款实时世界模型的训练推进。该项目被列为字节年度最高优先级之一,目标是实现50毫秒延迟、每秒20帧的交互效果,未来将适配Pico VR与抖音内容生态。字节今年在世界模型和Coding等方向的数据预算已达千万美元级,并可以继续追加。
与此同时,BAT重新回到模型牌桌。百度文心一周内连续开源基座模型、披露自动研究系统并发布ERNIE 5.5 Flash Preview;阿里开放Qwen4-Max预览版;腾讯发布Hy4正式版,在Artificial Analysis智能指数V5榜单中拿到35分,排中国模型第二。通用大模型公司、视频模型公司和云厂商,正在从不同方向逼近同一个目标:让模型不只生成内容,还能生成可运行、可交互、可持续更新的数字环境。
Claude、GPT“跨界”做视频,Seedance们的护城河是否还牢,也因此成为新的行业问题。视频模型在视觉知识和动态表现上积累深厚,通用大模型则在代码、工具链和Agent协作上更强。WorldOracle世界模型评测平台用真机实测给行业“测谎”,智象发布首款物理规律导向视频模型,说明竞争已经从“画面像不像”转向“世界对不对”。
造物主之争最后比拼三件事
从Vibe Video到Vibe World,行业真正押注的不是一段更长的视频,而是一个能够被进入、被操作、被持续更新的数字世界。通用大模型想把世界拆成可编辑的资产和明确的运行规则,视频模型想从海量影像中直接生成画面和动态变化。前者像在写一套世界运行代码,后者像在从视觉经验中长出世界。
这场“造物主”之争最后会落到三件事上:视觉内容是否足够丰富,角色、道具和场景能否持续响应用户操作,以及能否以合理成本长期运行。短期看,两条路线会继续在AI游戏、互动叙事、虚拟空间和视频创作中正面交锋;更可能出现的局面,是代码搭建规则与资产、视频模型补充视觉与动态、Agent负责编排和修复,形成混合生产管线。
当语言可以定义存在,视觉又开始生成世界,AI行业的竞争已经不只是模型能力的排名,而是数字世界以什么方式被创造、被运行、被持续更新。Claude、GPT与视频模型争当“造物主”的背后,是谁能先把“可交互的世界”做成可规模化、可复用、可负担的基础设施。
