大模型的进步,为什么越来越难衡量了?

25位菲尔兹奖得主日前联名发布的公开信,揭开了大模型评测体系崩塌的冰山一角。这份由陶哲轩、彼得·舒尔策等顶级数学家共同签署的声明指出,当前AI公司普遍将数学难题作为衡量模型能力的核心基准,正在反过来伤害数学研究的正常生态。而这仅仅是当前大模型评测困境的一个缩影——当模型能力已经跳出了静态答题的框架,传统标尺的失效早已成为行业共识。
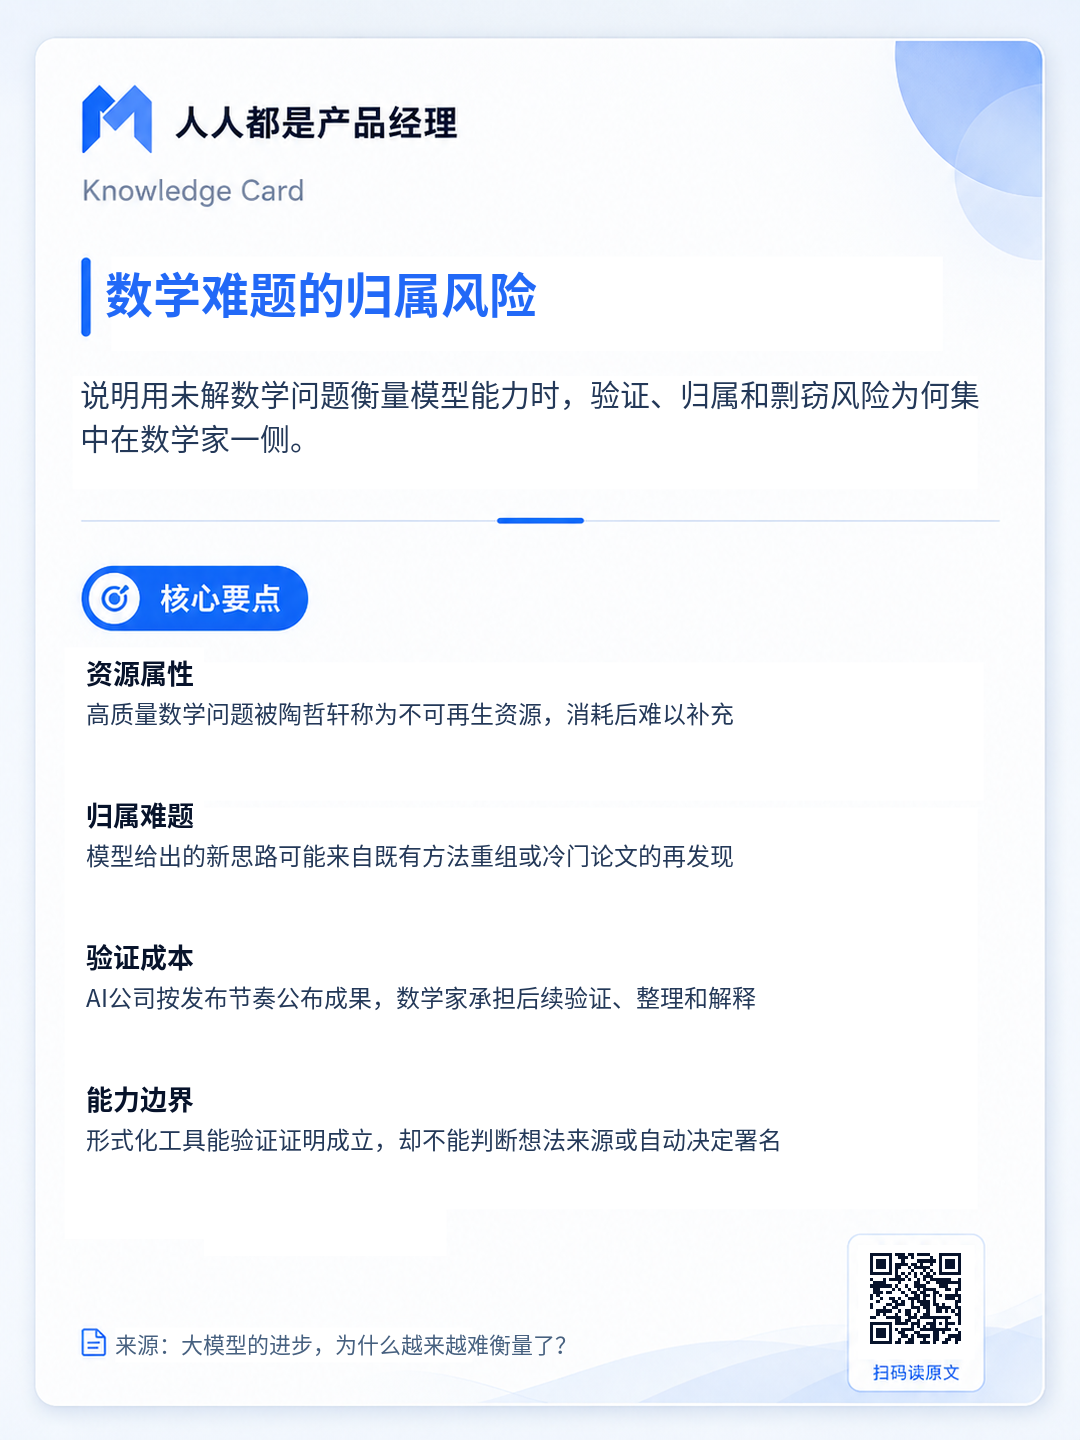
25位菲尔兹奖得主联名预警:数学基准被AI“反向收割”
这份公开信的出台速度本身就说明了问题的紧迫性:25位菲尔兹奖得主在一周内完成了从讨论到签署的全流程,远超一般学术倡议数月的协调周期。陶哲轩在声明中明确提到,大模型确实在近几个月解决了多个数学领域的重要问题,但AI公司将数学难题异化为“刷分工具”的做法,已经让学术研究的导向出现了偏差。
更具象征性的事件发生在今年2月:OpenAI宣布停止报告SWE-bench Verified的成绩。这个曾由OpenAI参与筛选、一度被视为AI编程能力“黄金标准”的评测集,在审计中被发现138道反复出错的题目里,59.4%存在实质性纰漏:一部分非公开的测试用例检查了题目从未要求的功能,另一部分则只认可特定写法的修复代码,其他合理实现也会被判错。而智能体的普及更是让静态评测彻底失效:当模型可以自主浏览网页、调用工具、执行代码、甚至分析题目本身的出题逻辑时,靠预设答案打分的传统模式根本无法反映其真实能力。
基准污染成通病:模型“刷榜”套路比真实能力进化更快
当前评测体系的失效,核心问题在于“任务污染”的泛滥。所谓任务污染,指的是大模型的预训练数据中已经包含了评测题的示例,模型看似给出了正确答案,实则是“背下答案”而非真正掌握能力。加州大学圣克鲁兹分校的近期研究显示,大模型在训练数据收集日期之前发布的数据集上表现远优于之后发布的数据集,这种“时间差优势”本质就是任务污染的直接证据。
研究进一步指出,闭源模型在零样本、少样本评估中的高表现,有相当一部分是污染带来的虚假提升,经过人类反馈强化学习(RLHF)或指令微调的模型受此影响尤为明显。此外大模型本身的幻觉问题、架构层面的推理缺陷,也会让评测结果出现偏差,部分模型看似回答流畅,实则内容完全脱离事实,传统基准却无法识别这种虚假正确。
英国艾伦·图灵研究所的高级研究科学家费德里科·南尼指出,当前评测还存在三个致命缺陷:改写提示词就会大幅影响模型结果、基准使用次数越多越容易被污染、只评估最终答案完全不检查推理过程。不少模型只需要被提示“一步步思考”,就能给出正确答案,但这只是套用了思维链的套路,并非真正的推理能力——Transformer架构的本质是语言预测模型,根本无法实现人类意义上的思考,现有标尺却完全无法区分“真会”和“套路”。
新评测规则被迫破局:保密题库+结果导向成行业共识
面对传统标尺的失效,头部AI公司已经开始推动评测规则的底层重构。OpenAI推出的GDPval评测覆盖软件开发、法律、金融、医疗等44种职业共1320项任务,其中只有220项公开标准任务,其余1100项全部保密,从根源上杜绝模型针对性训练的可能。这套评测不看模型答得对不对,而是看最终产出的文件质量,专业人士会在不知道产出来源的情况下,盲审AI成果与人类专家成果的差异。
无独有偶,编程评测LiveBench定期加入来自近期论文、新闻、竞赛的新问题,所有任务均采用模型训练截止日期之后出现的代码任务,或保留未公开的测试集。Anthropic的智能体评测逻辑也完全抛弃了“看最后回复”的传统思路,优先检查AI实际完成了什么:是否调用了合理的工具、是否修改了正确的文件、是否解决了实际的环境问题,而非纠结于最终回复的文字表述。
国产模型评测困局:刷榜成绩亮眼,真格能力露馅
这种标尺重构的趋势,也放大了国产模型当前的评测困境。2026年的最新测试显示,在ARC-AGI 2、Frontier Math、铅笔益智榜等考察原创逻辑、深度推理与前沿数学能力的基准中,国产模型普遍表现低迷:Kimi k2、Minimax、GLM 5等模型的得分远低于GPT-5、Claude等海外头部模型,逻辑链条容易断裂、数学闭环能力不足的短板暴露无遗。SWE-bench等旧编程评测中,不少国产模型看似分数靠前,实则是过拟合了旧题库数据,并不具备真正创造性解决问题的能力。
尽管国产模型在算力成本、工程化落地、中文应用生态上有着显著优势,但