EMNLP'26:GPT也不会「读空气」,狼人杀基准测出社交盲区

狼人杀变成AI测谎考场
人类说一句「我不是狼」,多模态大模型既能看到表情,也能听见声音。但它真的知道这句话是真是假吗?东京大学研究团队近期提出多模态交互式欺骗评估基准MIDA,用「一夜终极狼人」这个社交推理游戏搭建起一个可验证的测谎考场。相关研究已被EMNLP 2026主会接收。
为什么选狼人杀?因为游戏里的角色、夜间行动和规则全部可追溯,每句发言是否违背说话者当时掌握的信息,都能被严格核验。过往的欺骗检测研究大多盯着单人陈述或两人对话,而现实中的谎言往往藏在追问、站队和群体压力之中。MIDA共包含2360条发言,其中819条来自Ego4D的40局线下游戏,1541条来自151段YouTube游戏视频,覆盖新手与经验玩家两个难度梯度。
- 每条样本包含视频、音频、对话历史和游戏规则
- 标注方式:人工记录夜间行动,结合角色与规则生成可验证标签
- 评测要求:模型需根据多模态信息自行推断说话者掌握的知识状态
总分看着不错,二分类原形毕露
研究覆盖了GPT-4o、GPT-5、Gemini、Claude,以及Llama、InternVL、Qwen、DeepSeek等开源和闭源模型。从总体准确率来看,部分模型似乎并不差:GPT-4o在Ego4D子集上达到74.0%,Qwen2.5-VL-7B达到76.4%。
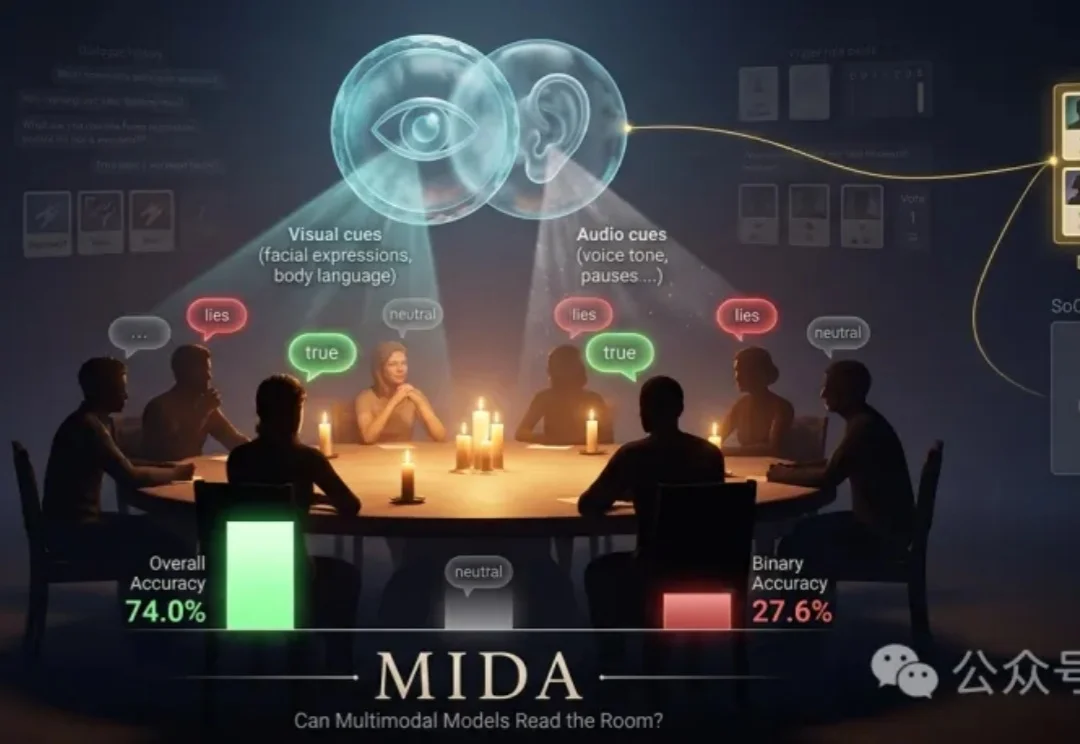
但MIDA的发言中夹杂大量「中性」样本——比如提问、猜测或假设,模型只要频繁选择「中性」就能拿到不错的总分。当去掉中性样本、强制模型判断真假时,真实水平立刻暴露:GPT-4o的二分类准确率只有27.6%,GPT-4o-mini为39.4%,Qwen2.5-VL-7B对「假话」的F1值为0。
模型并没有真正理解谎言的结构,只是学会了在不确定时给出模糊答案。这种「蒙混过关」的能力,掩盖了它们在社交推理上的根本短板。
拆解“读空气”:SoCoT把表情声音变成推理步骤
针对这个问题,研究团队设计了两套模块。第一套是社会思维链SoCoT:要求模型先描述面部表情、身体姿态和声音特征,再推测说话者的目标与心理状态,最后给出真假判断。这相当于把「他说话时声音发抖,所以可能有问题」的直觉,拆解成可以检查的推理步骤。
然而实验发现,非语言线索并不总能帮上忙。以GPT-4o-mini为例,只分析面部线索时,模型总体准确率提高了8个百分点,但真假二分类准确率反而下降了7.1个百分点。紧张、回避视线这些看起来「可疑」的表现,并不天然等于撒谎——模型即使识别出这些表现,也可能赋予它们错误的含义。
记忆板DSEM比看脸更管用
第二套模块是动态社会认知记忆DSEM。它的思路是为每名玩家维护一块持续更新的「记忆板」,记录其角色声明、行动、见闻、已知事实、人物关系和事件时间线。相比从某个瞬间的表情里找破绽,持续追踪每个人的知识与立场,更接近人类实际使用的社会推理方式。
实验里DSEM带来的提升更稳定:GPT-4o-mini二分类准确率提高2.3个百分点,宏平均F1提高3.3个百分点;Qwen2.5-VL-7B的宏平均精确率提高7.6个百分点。而消融实验也表明,移除对话历史后,MIDA二分类准确率从39.4%暴跌到13.4%;增加视觉帧数却没能带来持续增益。对话历史中承载的「谁知道什么、谁说过什么」才是关键。
能识别紧张不代表看穿谎言,AI缺的是心智理论
作者将当前多模态大模型概括为强大的「知识引擎」,而不是成熟的「社会智能体」。它们缺少的不只是更强的视觉编码器,而是对他人知识、信念和意图进行持续建模的能力——也就是通常所说的「心智理论」。
当模型离开答案明确的视觉问答,进入一个每个人掌握不同信息、观点持续变化、甚至主动影响他人判断的多人互动环境时,今天最强的多模态大模型依然很难真正「读懂空气」。MIDA的意义也不局限于狼人杀:在会议协作、在线讨论、人机交互和多智能体协作中,模型同样需要追踪不同参与者掌握的信息与不断变化的立场。这场测谎考试暴露的社交盲区,或许正是下一代社会智能体需要补上的第一块短板。
