国产RSI模型交卷!Flash模型靠它反打旗舰

港股AGI第一股云知声正式推出U2-Flash模型,成为国内首个落地递归自我改进(RSI)机制的AI产品,率先交出国产RSI模型的早期答卷。当下“让模型参与训练下一版自己”的叙事从硅谷火到国内,Anthropic CEO达里奥此前也公开表示递归自我改进(RSI)已经在整个行业发生,包括Anthropic自身也不例外,云知声的这次发布,恰好踩中了行业技术迭代的关键节点。
云知声发布U2-Flash 国产RSI模型率先落地RSI机制
上海交大、清华、上海AI Lab等机构近期发布的论文《The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement》,按照模型接管“自我改进闭环”的程度划分出L1到L5的RSI分级路线图,虽未成为行业统一标准,但为技术发展提供了清晰参考。按该分级,U2-Flash已显露出明显的L3特征:模型仍运行在人工设定的沙盒、规则和授权边界内,却已经开始参与决定下一版自身该学习的内容,从“被动接受训练”转向“主动参与迭代闭环”。过去一年多份国产前沿模型技术报告早已指向同一趋势:模型开始参与生产训练任务,在可执行环境中积累轨迹,再通过强化学习与专家蒸馏把经验转化为通用能力,后训练的竞争早已从“人给模型准备多少答案”升级为“模型能否持续为自己创造有效经验”。
266B总参仅激活10B 多项评测碾压前代直追旗舰
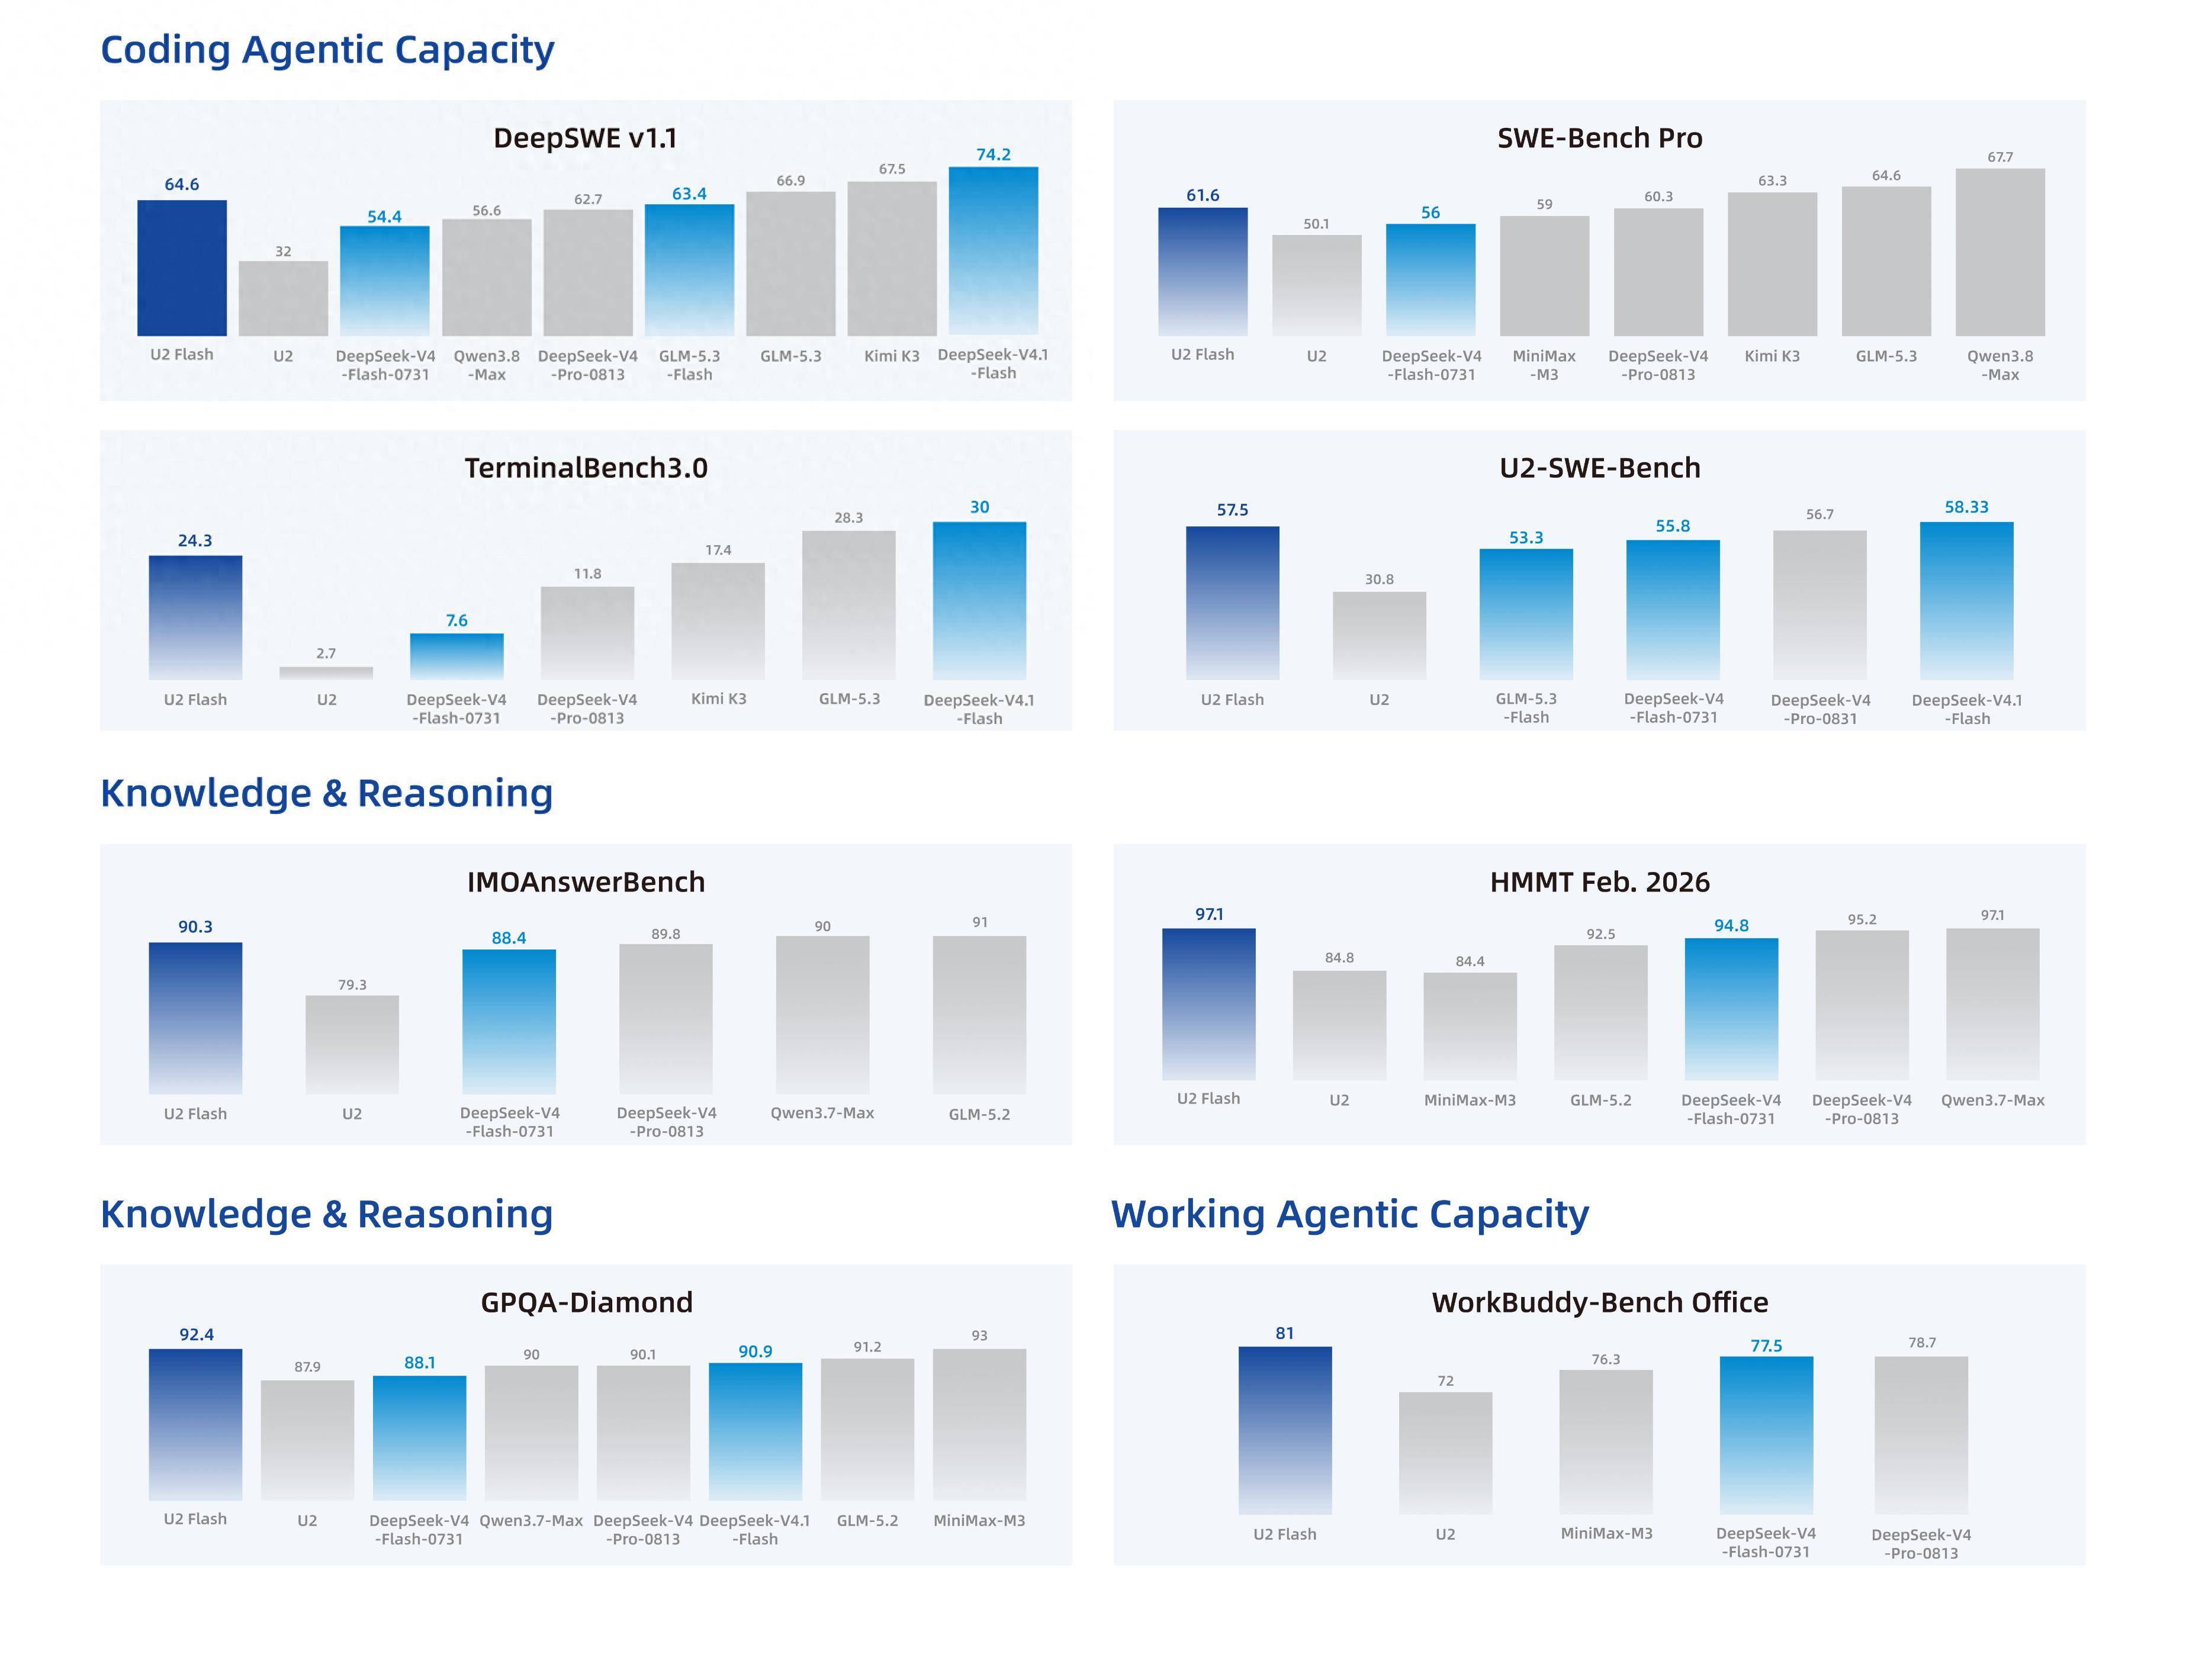
U2-Flash采用稀疏混合专家(MoE)架构,总参数约266B,单次推理仅激活约10B参数,激活比例不到总参数的4%,却实现了远超同体量模型的任务表现。在核心能力评测中,U2-Flash相比前代U2实现了多维度跃升:
- 软件工程任务SWE-Bench Pro拿下61.6分,较前代提升10.5分;DeepSWE v1.1斩获64.6分,直接实现翻倍,超过GLM5.3-Flash、DeepSeek-V4-Pro-0813等同级模型
- 终端执行任务TerminalBench 3.0拿到24.3分,是前代2.7分的9倍,成绩超过K3等万亿参数级模型
- 内部评测U2-SWE-Bench中,模型得分从30.8分升至57.5分,代码工程、终端执行两条能力线同时大幅上扬
办公场景下U2-Flash同样表现亮眼,WorkBuddy-Bench Office评测拿到81分,直接挑落DeepSeek-V4-Flash(77.5分)、DeepSeek-V4-Pro(78.7分)和GLM-5.2(79.6分)。此外模型在知识推理与数学能力上表现优异,GPQA Diamond得分92.4分,IMOAnswerBench得分90.3分,HMMT Feb. 2026得分97.1分。支撑这份高密度智能表现的机制之一是“隐式思考”:模型在给出答案前会先在高维隐藏状态空间中探索多条潜在解法路径,再依据问题难度决定是否切换到显式推理,部分思考过程留在内部连续表示空间,无需全部生成显式中间Token,既降低了推理成本,又提升了复杂任务的处理效率。
自迭代闭环驱动 模型自主定位短板持续优化
U2-Flash的性能跃升,核心来自云知声搭建的系统性后训练闭环,以及十余年积累的真实场景数据与标注能力。云知声长期深耕医疗、交通、座舱等领域,接触过大量真实业务场景,清楚模型会在哪一步出错、哪些专业知识容易理解偏差、用户最终需要怎样的结果,这些真实场景的难题自然成了模型升级的练习题。
传统模型迭代依赖人工判断短板、标注数据,效率低、成本高,而U2-Flash的四步自迭代闭环打破了这一限制:发现薄弱环节→生成针对性数据→强化训练→验证效果,循环运转。具体流程为