刚刚,谷歌世界模型Genie 4实测,30秒生成游戏,24帧实时交互、边玩边改

30秒生成一个游戏世界,WASD直接上手玩
Genie 4的官方演示最令人震撼的一点,是你不用写一行代码、不用搭任何场景,只需输入一句文字提示词,大约30秒后就能生成一个可以立即“上手玩”的3D世界。生成完成后,画面左下角会出现WASD键位提示——这意味着你不再是被动观看一段AI视频,而是真的在“玩”这个AI现场生成的场景。
比如官方展示的“骑龙飞行”案例:用户输入提示词后,瞬间置身于巨龙背上,以时速140公里穿越山脉、城堡和火山地带,周围还有其他骑手在同步飞行。键盘控制导航与镜头,用户想往哪飞就往哪飞。更关键的是,整个过程中场景不是预渲染的录像,而是持续实时计算出来的——每一次转向、每一次视角调整,画面都在即时响应。
除了飞行,官方还演示了湖面萨克斯演奏场景:一名身穿棕色西装的男子站在湖中央的漂浮平台上,周围是雾气弥漫的森林和缓缓流动的湖水。用户可以自由旋转镜头,拉近观察演奏者的手指动作,也可以随时改变天气、移动镜头、往场景里添加新人物或物体。真实感和交互性都远超此前的AI视频生成工具。
这项能力背后是谷歌Gemini系列模型的协作。Gemini负责把用户的自然语言请求翻译成具体的场景修改指令,同时观察画面并跟踪进度;Genie 4则负责实时渲染出对应的视觉世界。当用户中途改变指令时,Gemini会现场调整方案,而非重新生成一段独立视频。
边玩边改:改天气、换场景、加人物,一句话全搞定
Genie 4最大的突破在于“持续性交互”——用户可以在世界运行过程中不断输入提示词,实时修改一切。官方演示中,用户让原本晴朗的草地突然出现一条粉红色绸缎,镜头随即被拉到南极冰原上空的热气球篮筐里。整个过程中场景不被中断,角色会根据新设定继续行动。
这种能力让AI生成内容从“一次性视频”变成了“活的世界”。过去用AI视频模型生成一段画面后,想改任何细节都得重新生成;而在Genie 4中,你可以像游戏导演一样现场指挥:改变天气、调整摄像机位、新增NPC、改变物体属性、触发新事件……所有修改都在模拟持续运行的过程中即时生效。
具体来说,Genie 4允许用户通过自然语言动态改变模拟环境,例如从晴天切换为暴雨、改变摄像机视角、加入新角色或物品。系统会在模拟继续执行的情况下处理这些指令,而不是每次都从头生成一段独立视频。同时,Genie 4还能结合当前环境理解指令,让场景保持逻辑一致性——比如你刚在湖面加了一条绸缎,水面的倒影和风吹动绸缎的动态也会同步更新。
对于游戏开发者来说,这意味着可以用自然语言快速构建可探索的原型场景,并在交互过程中不断调整环境和角色,大幅缩短早期玩法的验证时间。设计师不需要再写死每一条事件和反应,AI会自动生成符合情境的后续行动。
新增原生音频与实时对话,虚拟角色开始“有回音”
Genie 4的另一项关键升级是原生音频生成。以前AI生成的视频往往需要后期配音,而Genie 4在生成画面的同时,会同步生成与虚拟世界匹配的实时音频——包括背景音乐、环境音、物体碰撞声以及角色说话声。官方演示中,巨龙振翅时的轰鸣、高空呼啸的气流、远处火山活动的声音,都是由Genie 4直接生成的,并非后期添加。
更进一步的突破是实时人物对话。Genie 4中的角色可以根据用户的输入或世界中发生的事件作出语言回应,而不是只重复预先准备好的台词。用户可以在场景里和虚拟角色对话,AI会根据情境自动组织回应内容,配合面部的表情和肢体动作一起呈现。
这一变化对虚拟角色、互动叙事乃至游戏开发意义重大。开发者不再需要为每个NPC写死每一句台词和反应脚本,而是可以创造一个能够随着情境变化持续产生行为与对话的模拟人物。谷歌官方设想了一个交互式学习场景:用户进入一幅描绘历史事件的画作中,和画中人物对话,从而了解那段历史。
音频与对话能力同步让场景的整体沉浸感大幅提升。在“骑龙飞行”演示中,伴随快速掠过的山峰和城堡,声音与画面完全同步,用户仿佛真正坐在龙背上穿越云端。这种视觉、听觉与交互行为的紧密绑定,让Genie 4的生成效果几乎与真实影像无异。
物理模拟与人物行为升级,机器人也能在虚拟世界“下跳棋”
Genie 4此次重点强化了复杂物理与人物行为模拟。画面中的角色变得更加拟人:他们能对环境变化作出自然反应,行走、转身、拿取物体、坐下等动作都更符合真实物理规律。物体之间的碰撞、遮挡、光影变化也更接近现实世界的约束。
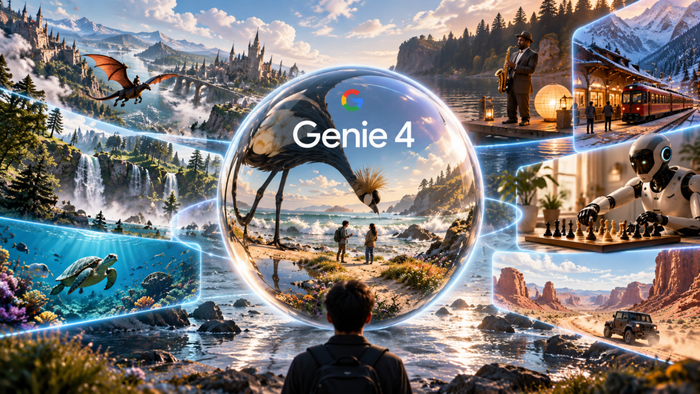
谷歌展示了一项颇具前瞻性的实验:Gemini 4 Argon模型扮演“导演”,将任务拆解成分步指令,Genie 4负责实时仿真。在演示中,Gemini 4 Argon指挥Genie 4一步步模拟Apptronik旗下Apollo人形机器人下跳棋的过程——机器人需要观察棋盘、移动手臂、抓取棋子、放到目标位置,整个过程由Genie 4持续模拟并实时调整,而非播放一段预先录制的视频。
这种组合让世界模型的用途从娱乐扩展到了机器人训练。现实中的机器人训练需要大量设备、场地和实验,一些危险或成本高昂的场景很难反复测试。如果世界模型能够准确模拟物理环境,机器人就可以先在虚拟世界中练习策略,再迁移到真实设备上。Google DeepMind研究主管Tejas Kulkarni表示:“未来我们会越来越多地看到混合式世界模型:Gemini负责编写代码、生成文本,Genie实时读取这些指令,在不同抽象层级上仿真现实世界。”
不过谷歌也承认,Genie 4目前的物理模拟仍有局限。复杂物理互动、可读文字生成以及长时间保持环境一致性等问题尚未解决。随着模拟时间延长,画面细节和物体仍可能发生漂移。此次发布的Genie 4单次模拟最长约2分钟,是上一代Genie 3的两倍,但2分钟之后场景可能开始出现不稳定的迹象。
落地探索:影视预演、游戏原型、机器人训练,但距离成熟工具还有距离
谷歌Genie 4已面向少量受信任的测试者开放研究预览,后续将逐步提供给Google AI Ultra订阅用户,以及Gemini API、Google AI Studio的早期合作伙伴。在合作伙伴计划中,重点探索方向包括影视制作、游戏设计、教育和机器人模拟。
在影视行业,Genie 4可以用于视觉特效(VFX)预演,帮助创作者在正式制作前快速构建和探索场景。首批受邀测试者还挖掘出了电影前期样片快速原型制作这一用途。谷歌DeepMind工程师迭戈·里瓦斯在发布会中提到:“实时渲染的价值,在需要保持创作连贯性的场景里尤为突出,比如创意构思阶段、分镜脚本阶段——所有需要快速迸发创意的环节,它都能派上用场。”此外,测试者还在尝试利用经过核实的历史档案重现历史场景,用于历史教育和沉浸式内容创作。
在游戏开发领域,设计人员可以通过自然语言构建可探索的原型场景,并在交互过程中调整环境和角色。这有望缩短概念验证和早期原型制作的时间,让开发者更快测试不同的场景设计与玩法构想。不过,生成式世界模型与完整游戏之间仍存在明显差距:商业游戏需要稳定的规则系统、可重复的游戏机制、精确的角色控制,以及开发者能够长期维护和修改的内容。Genie 4目前更像是一个实验性原型工具,尚不能直接取代传统游戏引擎。
值得注意的是,谷歌团队曾尝试使用最新旗舰模型Gemini 4 Argon驱动Genie 4,但实际实时交互体验运行在更轻量的Gemini 3.8 Flash上。这表明实时世界模拟不仅取决于生成画面质量,还需要模型能以较低延迟持续理解场景、规划行动并响应用户。Genie 4的发布让AI生成从“内容创作”转向“环境模拟与交互式体验”,但要让这项技术真正成为游戏、影视和机器人领域的成熟工具,仍需解决长期一致性、物理模拟精度、交互响应速度以及生成成本等问题。
