刚刚,华为昇腾960超节点提前登场!韬定律立功性能翻倍,剑指英伟达

昇腾960超节点正式发布 研发进度超预期提前
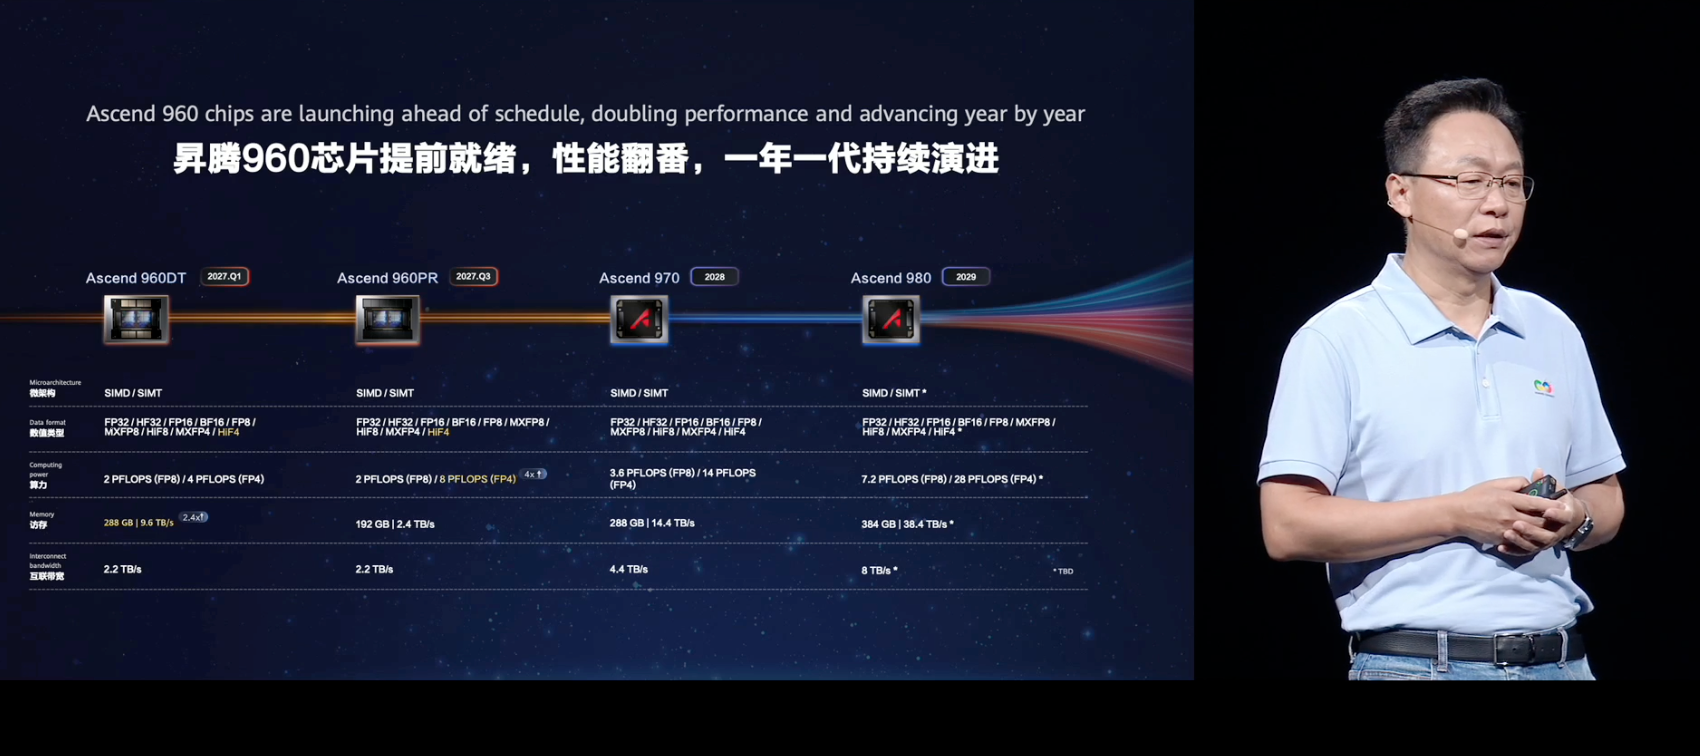
9月17日,华为全联接大会2026在上海开幕,华为副董事长、轮值董事长汪涛现场宣布昇腾960芯片研发超预期,性能实现翻倍,正式推出昇腾960超节点。其中昇腾960DT版本支持2 PFLOPS(FP8)、4 PFLOPS(FP4)算力,较上代实现翻倍,预计2027年一季度就绪,比原计划提前三个季度;昇腾960PR版本预计2027年三季度就绪,比原计划提前一个季度。汪涛表示,华为昇腾系列芯片将依托“韬定律”坚持一年一代的演进节奏,2028年、2029年将陆续推出昇腾970、昇腾980芯片,持续实现算力规模翻倍提升。同时他透露,华为昇腾910C超节点已部署超过1000套,服务覆盖370多家客户,昇腾950超节点已进入规模商用阶段。
灵衢架构+NPO技术落地 打造百万级卡超大规模集群
本次发布的昇腾960超节点底层依托华为自研的全栈技术支撑。在互联与存储层面,华为推出的OceanStor M900搭载灵衢UnifiedBus总线,支持直连L3.5层PB级KV Cache解决方案,相比业界通用的PCIe+RoCE互联方案,GPU或NPU访问SSD池仅需1次数据搬运,I/O时延和首token时延可降低超过50%,同时可将SSD读写寿命提升16倍,从底层保障KV Cache的高命中率和常温可靠性。
在超节点互联层面,华为推出业界首个量产NPO(近封装光学)光引擎Hi-ONE,搭配灵衢UnifiedBus总线构建可规模扩展的超节点互联系统,解决电互联无法支持跨柜超节点的瓶颈。基于灵衢UnifiedBus+二层CLOS灵活组网架构,华为可打造支持100万卡规模的超大规模集群:单个昇腾960超节点最大规格为4096张NPU卡,多个超节点可通过灵衢网络交换机互联形成更大规模的集群。
汪涛透露,华为为AI场景专门打造了11颗关键芯片,涵盖多类核心器件:
- Scale-out平面大容量交换芯片、Scale-up平面低时延交换芯片,以及面向跨柜高速互联的光互联芯片
- 专为AI KV Cache场景打造的Smart Storage Unit,实现平等一跳直达的缓存系统
- 各类系统管理套片,实现复杂系统的协调与管理
全栈方案支撑 昇腾960超节点剑指大模型训练需求
汪涛在会上明确了华为AI战略的核心是算力,华为将坚持硬件变现路线,通过“超节点+集群”模式打造中国坚实的算力底座,构建开源开放的算力生态,同时提供多样化的线上线下的灵活算力方案。
正式发布的昇腾960超节点是全球首个应用NPO技术的超节点,可支撑10万亿参数大模型开展大规模训练与推理,进一步缩小与国际主流AI算力方案的性能差距。产品规格方面,昇腾960风冷超节点将于2027年第二季度上市,液冷超节点将于2027年第三季度上市。
目前昇腾超节点已在金融、互联网、科研等多个行业实现广泛部署,随着昇腾960系列的落地,华为AI算力产品的市场竞争力将得到进一步提升,剑指英伟达在全球AI算力领域的领先地位。