谷歌RSI论文:AI自进化,做梦吧

近日,谷歌联合Google DeepMind、马里兰大学、弗吉尼亚大学发布的最新RSI(递归自我改进)相关论文引发AI圈热议,核心争议点直指大众认知中“AI自进化”的定义边界——本次提出的Dream-RSI框架并未让AI修改自身模型权重,而是通过“梦境模拟”的方式实现探索策略的自进化,大幅降低了科研探索的算力成本。
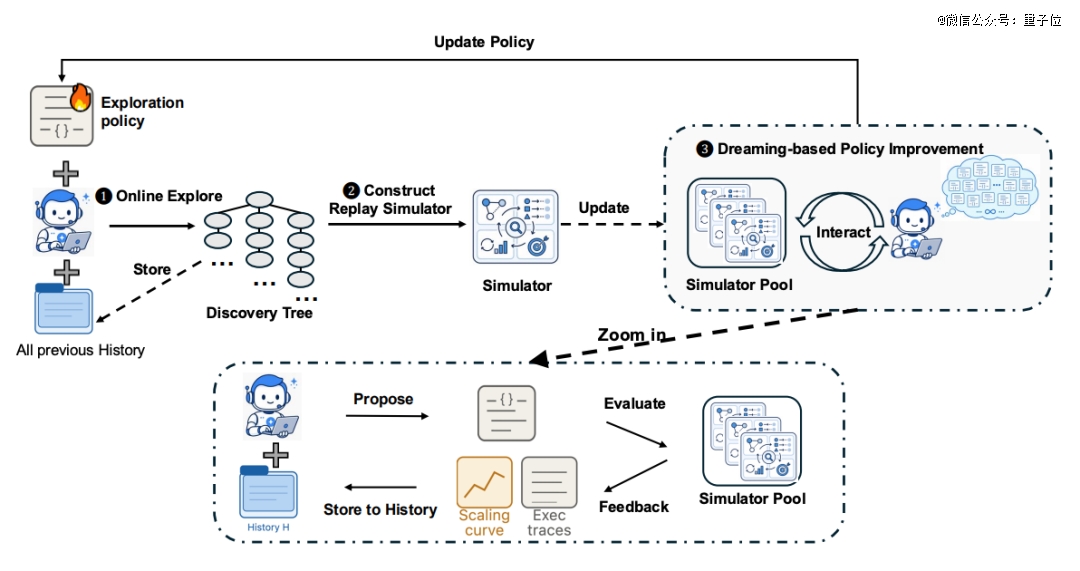
谷歌DeepMind联合多校抛出Dream-RSI框架,把探索历史变“梦境模拟器”
论文核心思路可总结为“把AI走过的弯路变成AI新的训练场”。谷歌研究人员认为,RSI的核心驱动力是高效探索,如何管控优化探索策略是关键问题。目前多数AI科研系统都遵循“生成方案→跑实验→看结果→修改方案→再跑实验”的循环,但固定探索策略无法适应不断扩大的搜索空间,在线策略优化又存在迭代周期长、反馈滞后、实验代价高的困境,且长程科研搜索的并行路线众多,过早总结高层结论反而会加入强先验,堵死实际有价值的探索分支。
Dream-RSI的运作逻辑分为三步形成闭环:
- 真实探索阶段:当前探索策略