谷歌新模型拳打GPT脚踢Claude,却没打算让我们用

10月28日,谷歌突然发布新一代旗舰模型Gemini 4 Carbon。在第三方评测机构Artificial Analysis的智能指数v5.0榜单上,Carbon以59分直接登顶,将58分的Claude Opus 5.5和57分的GPT-6 Astra双双压在身下。谷歌官方晒出的17项核心对比中,Carbon一口气拿下15项最高分。蛰伏一年、曾被戏称为“美国豆包”的Gemini,这次真的把王座抢了回来。
就在无数开发者和吃瓜群众摩拳擦掌,准备第一时间上手把玩这位“新王”时,谷歌却兜头泼了一盆冷水:模型发了,但现在还用不上。按照官方说法,Carbon目前只塞给极少数精挑细选的“网络安全防御人员”,普通开发者、企业和大众,官方只留下一句“尽快”。
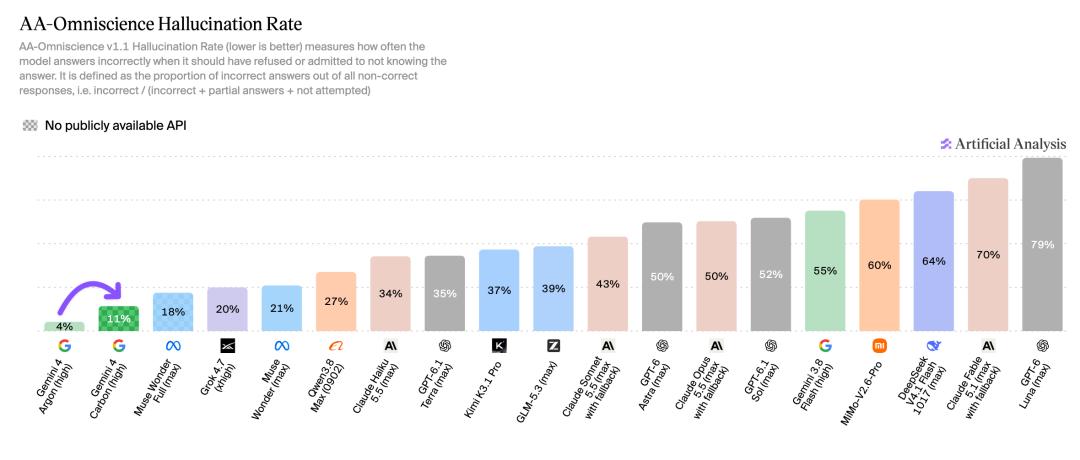
更耐人寻味的是,这已经是谷歌第二次玩同样的套路。上一次Gemini 4 Argon发布时,谷歌也是“只给看、不给摸”,等了差不多半个月才全面开放。连续两次把全网胃口吊到最高点又一脚踩空,谷歌到底在打什么算盘?扒开那份漂亮的成绩单,就会发现事情没那么简单。
屠榜新王:59分把GPT和Claude双双按在身下
10月28日,谷歌在官方博客与社交平台同步甩出Gemini 4 Carbon的评测数据。Artificial Analysis的智能指数v5.0榜单上,Carbon以59分登顶,Claude Opus 5.5以58分紧随其后,GPT-6 Astra以57分排第三。这是Gemini系列时隔一年多重回综合智能榜首。
- 在官方公布的17项核心对比中,Carbon拿下15项最高分
- 谷歌特别强调,Carbon在减少凭空捏造、改善指令遵循与处理复杂工程任务方面进步显著
- 外部评测平台Arena的早期数据显示,Carbon在“可引导性”项目排名第一,Agent Arena总榜排名第二
值得注意的是,这份成绩单一并标注了“初步结果”。即便如此,这也是谷歌近年少有的全面领先。毕竟在过去的几轮竞争中,GPT和Claude轮流坐庄,Gemini总显得慢半拍。这次Carbon的全面爆发,直接宣告谷歌在AI竞赛中回到了第一梯队。
只给看、不给摸:连续第二次限量发布
Carbon的发布节奏让很多人想起半个月前的Argon。10月3日,谷歌发布Gemini 4 Argon时,同样选择不向普通用户开放,而是优先提供给经过严格审核的网络安全从业者。这次Carbon更是变本加厉,连API都没有全面放开。
按照谷歌官方说法,Carbon目前仅通过Fairwind项目向少量可信的网络安全防御伙伴开放。后续会逐步扩大范围,但面向开发者、企业和消费者的开放时间表,官方没有给出任何确切日期。翻译成人话就是:榜单我拿了,模型我发了,但你们还得等着。
谷歌这波操作让不少开发者感到困惑。要知道,过去各家大模型公司发布新模型,恨不得一秒内让全世界都能用上API。谷歌连续两次反其道而行之,更让人怀疑背后另有隐情。
0%攻破率背后,谷歌为何敢藏起王牌
如果只看Carbon暴涨的能力数据,就能理解谷歌为什么敢这么“耍猴”。最基础的长文本能力就足够震撼:在极其变态的GraphWalks测试(256K到1M超长上下文)里,Carbon拿到了接近满分的96.2% F1得分,同期GPT-6 Astra为71.8%,Claude Opus 5.5只有66.8%,半个月前的自家兄弟Argon也只有84.2%。
这项测试之于实际应用,就好比把几千页错综复杂的财务账本、上百份跨国合同丢给模型,问它“第十二页那个隐蔽的漏洞,和最后附录里的一笔交易到底有什么联系?”许多普通模型会直接罢工,Carbon却能稳稳交卷。
更让谷歌警惕的,是两组安全测试数据:
- 在一项间接提示词注入测试里,Carbon的攻击成功率为0%
- 在Terminal Bench 4.0的专项检测中,成功钻空子的比例同样降到0%
- 谷歌内部真实编程环境里,Carbon的高严重级别失调警报下降了将近80%
0%不意味着永远攻不破,只意味着它在那套指定测试里没有出现成功案例。但一个越来越强的模型,怎么保证它不会“越帮越忙”?这才是谷歌真正担心的问题。面对潜在的双重用途,谷歌选择先把防护措施验证完,再逐步扩大开放范围。此外,谷歌已将Carbon提交给美国政府参与自发性发布前安全测试。考虑到近期OpenAI、Anthropic接连曝出前沿大模型安全隐患,谷歌的保守受控发布模式,也是在塑造安全可信的AI厂商形象。
从“答对题”到“干成活”,Carbon的真实进化
榜单上多一分少一分只是数字,真正关键的是谷歌这次选择展示的能力变了。过去各家的评测,无非是给一道数学题看它能不能算出来,给一个网页需求看它能不能一次写对。现在,评价标准已经转向:把一套庞大又复杂的软件系统交给模型,任务复杂到不可能一步完成,它能否在失败后继续追查、找到原因、改掉错误,一直干到问题真正解决。
谷歌在官方公告里披露,内部团队已经观察到Carbon在复杂工程任务中持续运行数天。它会遇到死胡同,会换一条路继续追查大型代码库和底层系统里藏着的缺陷。这背后是多项可靠性的提升:
- Carbon遇到模糊指令或互相冲突的参考资料时,会先查找来源、指出不一致之处
- 证据不足时,会说明缺少哪些信息,而不是硬着头皮编造
- 缺乏依据的陈述较Argon减少约一半
- 擅自超出用户要求的“自作主张”行为减少26%,未充分完成要求的情况减少29%
- 可引导性排名第一,用户指出问题后,模型依指示调整的能力明显增强
不过,这并不等于Carbon已经能完全没人管地干上几天,更不是它已经能自我改写模型。外部评测也显示,Carbon在WebDev Arena网页开发评测中仅排名第四,说明综合能力虽然登顶,部分专项仍有追赶空间。从“答对题”到“干成活”,这中间隔着的正是AI落地最难的一道坎——时间与可靠性。一次回答几十秒,错了可以重新问;可一项持续几十小时的工程活,可能要查文档、调工具、跑测试、反复回滚。
价格方面,Carbon沿用Argon的首发优惠策略:每百万输入Token收费2美元、输出10美元,缓存输入按输入价格的5%计费。优惠结束后,标准价格将恢复为输入4美元、输出20美元。Artificial Analysis估算,Carbon每项智能指数任务的加权平均成本为7.76美元,较Claude Opus 5.5的10.04美元低约23%,但高于GPT-6 Astra的6.25美元,与Argon的7.68美元基本持平。谷歌已经凭Carbon重新站上了一个重要山头,但整个AI战场的胜负远未分晓。真正值得盯住的,不是榜单上谁比谁多一分,而是谁先展现出能稳定承担真实世界复杂任务的能力。
