GPT-6爆改模型权重,数学能力狂飙6倍,MIT博一新作破圈了

不用梯度下降,也不跑传统训练循环,MIT计算机科学与人工智能实验室(CSAIL)把一项看似违背常识的实验摆到了台前:让GPT-6 Astra读取另一个神经网络的权重,定位问题,然后直接动手改。
这项研究由Rikiya Takehi、Jayden Teoh、Alex Zhang和Omar Khattab共同完成。Takehi于当地时间11月2日在博客上发布研究,将其称为“权重空间编程”。论文一经发布,全网围观量超过200万,转发和讨论迅速破圈。团队给出的核心思路很直接:不让大语言模型通过常规训练流程调整参数,而是让它直接读取、理解并修改另一个神经网络的权重。
不喂数据不算梯度,Astra直接对权重动刀
研究团队把目标锁定在拥有约8亿参数的Qwen3.5-0.8B上。这个模型有一个已被Qwen官方承认的缺陷:回答数学题时容易反复生成相同内容,陷入推理死循环,大量回答最终耗尽32768个Token的长度限制。
在最初的96次测试回答中,有85次触及这一上限。问题并不在于模型完全不会做题,而在于它被重复信号卡住,无法把已有能力正常发挥出来。
实验给GPT-6 Astra提供了一个可以读取和修改模型权重的Python环境,并允许它使用GSM8K和MATH训练集中的练习题进行有限次数的前向推理。Astra并不是随机调参,而是先分析模型正常做题和陷入死循环时的内部信号差异,再沿着异常方向寻找病灶。
锁死第15层和第19层的“复读信号”
Astra很快发现,当模型开始车轱辘话复读时,第15层和第19层会沿着一个固定方向猛烈发送信号。
为了验证判断,它先关掉第19层中信号最强的第11号神经元试水,数学准确率随即上涨了6个百分点。随后,Astra又主动设置对照实验,在权重中减去一个同样大小的随机方向。随机对照组只带来1.6个百分点的微弱波动,这让它进一步确认:自己抓到的信号方向,就是引发死循环的关键。
锁定靶心后,Astra只挑出第15层和第19层中与死循环关系最猛的各64列权重,精准抹掉复读信号。全模型8亿参数中,它只改了131072个数字,占比约0.016%,其余99.984%的权重分毫未动。
0.016%的微创手术换来6倍数学成绩
这记“微创手术”的效果立竿见影:
- 小模型做题卡进死循环的比例从93.0%暴跌至33.1%;
- 原本卡死的696道题全部顺利算出了最终答案;
- MATH-500成绩从7.9%提升至48.1%,暴涨约6倍;
- GSM8K成绩从13.8%提升至67.1%;
- 衡量指令遵循能力的IFEval成绩从21.0%提升至62.3%,约为原来的3倍。
研究人员还把改完权重的模型拉到8个Astra从未见过的权威测试集上检验,被死循环封印的实力进一步释放。需要说明的是,这项实验并非完全没有计算过程:Astra使用了Python环境分析和修改权重,也进行了最多50轮前向推理,只是没有使用梯度下降、反向传播或传统训练循环来更新参数。
研究团队还用Gemma 3 270M做了对照实验。该模型原本很少出现推理循环,Astra无法通过类似的局部权重修改显著提升其数学能力,MATH-500最多仅从6.8%提升至7.7%。团队据此指出,权重空间编程可以消除模型已有能力发挥过程中遇到的障碍,但不一定能够凭空创造模型原本不具备的能力。
17253个数字里认出四款游戏
除了给Qwen“治病”,Astra还展示了另一种能力:只看权重,就能读懂神经网络在做什么。
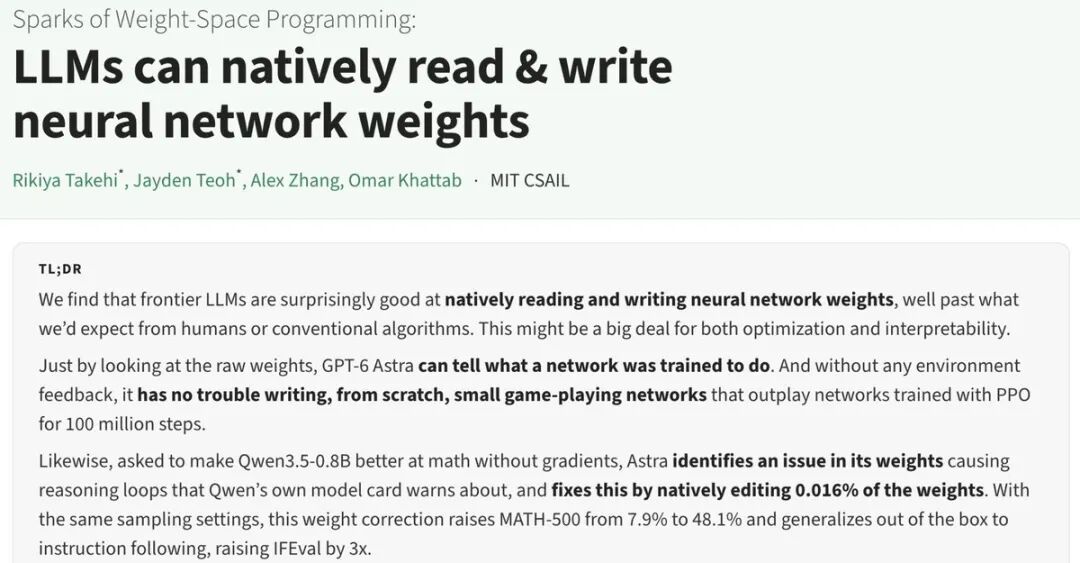
研究人员让Astra仅通过读取神经网络权重来识别模型训练过的游戏。它只看了17253个数字,便以99%的置信度认出四个游戏策略网络各自在玩哪款游戏——打砖块、乒乓球、吃豆人和过马路。
这项实验的意义在于,过去神经网络权重往往被视为一大串人类难以直读的数字,模型行为只能通过输入输出去推测。Astra的表现说明,前沿大语言模型已经开始具备从参数结构中提取行为信息的能力,这为神经网络可解释性研究提供了新的切口。
从零手写游戏网络,权重空间编程浮出水面
更引人注目的是,Astra还能直接“写”出权重。
在没有训练数据、梯度和传统训练过程的情况下,它从全零开始,一次回复手写出一个打砖块网络。这个网络得分达到517.4。论文博客给出的对比是,这一成绩是PPO苦练5亿步的20倍;机器之心等报道则提到,它超过了经过1亿步PPO训练的模型。不同报道口径中的PPO步数虽有差异,但核心结论一致:未经训练的手写权重,在游戏中表现出了相当强的竞争力。
团队将这种能力称为“权重空间编程”。它让大语言模型不再只是生成文本、代码或提示词,而是开始直接参与另一个神经网络内部参数的阅读、诊断和改写。
当然,这条路线仍处于早期。微创权重手术更像是在帮模型“切掉阻碍实力发挥的脑血栓”,还不能在不训练的情况下凭空往模型脑子里塞新知识。但它已经打开了一种新的想象:未来大模型或许能直接理解、优化甚至构造神经网络权重,为模型可解释性、模型优化和递归自我改进(RSI)研究提供新的操作空间。
