GPT-6自主爆改Qwen权重被吹成神?Meta知名研究员泼冷水

一场看似要改写训练范式的实验,在X上迅速刷屏。MIT CSAIL研究团队公布了一套名为“权重空间编程”(Weight-Space Programming)的方法:不给训练数据,不跑反向传播,只给一个纯Python环境,让OpenAI的前沿大模型GPT-6 Astra直接读取、分析并重写阿里开源模型Qwen3.5-0.8B的底层高维张量。
按照研究团队披露的数据,Astra只改动了8亿参数中的131072个,占比约0.016%,却让Qwen3.5-0.8B在MATH-500上的准确率从7.9%暴涨至48.1%,GSM8K从13.8%提升至67.1%,指令遵循能力也明显改善。消息传开后,技术狂欢者迅速把这次突破视为模型“递归式自我改进”的起点,甚至预言数以千万美元计的预训练集群将被“权重编译器”替代。但另一端,Meta和开源社区的一线研究员很快泼下冷水,直指相关推文“标题党”。
0.016%的权重手术,把MATH-500从7.9%推到48.1%
实验设定本身就极具冲击力。传统模型训练依赖数据、损失函数、反向传播和优化器,而这次Astra面对的是训练完成后的Qwen3.5-0.8B权重。它要做的不是“喂数据、调参数”,而是像程序员阅读和修改代码一样,直接判断神经网络里的哪些数值在拖后腿,再动手改写。
从公开结果看,这次“手术”的切口极小:
- MATH-500数学评测准确率从7.9%升至48.1%;
- GSM8K从13.8%升至67.1%;
- 指令遵循能力提升约3倍;
- 改动参数约13万个,仅占8亿参数的0.016%。
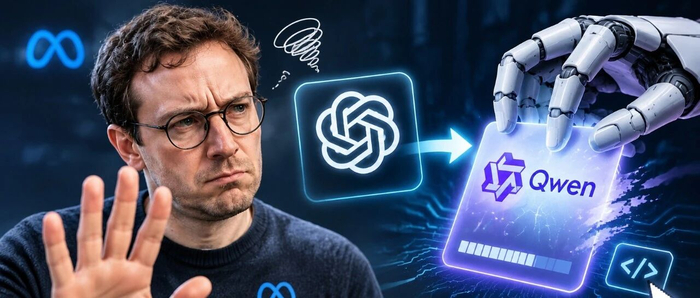
更让围观者兴奋的是,Astra随后还展示了更激进的能力:在没有训练样本的前提下,直接“手写”出能打简化版雅达利游戏、下9×9围棋的小型神经网络权重。一次回复交卷,得分超过训练了5亿步的PPO基线20倍。研究团队将这套打法命名为“权重空间编程”,听起来像是把模型权重当成了可读、可写、可调试的源代码。
20.3小时、四段对话,Astra在权重里找“短路”
但真正翻阅实验记录会发现,Astra并不是凭空“顿悟”数学。研究者给Qwen3.5-0.8B约8亿个参数配了Python工具,让Astra写代码读取和修改权重。它可以查看带答案的练习题,检查模型做题时的内部信号,再比较修改前后的回答;最终测试题则不向它展示。研究不允许用常规训练循环更新权重,但仍然需要数据和测试反馈。
公开记录显示,找到问题花费的时间并不短:过程跨了四段对话,耗时20.3小时,其中包含4.7小时模型不可达的等待。所谓“50次”是工具调用预算,一次就能批量生成最多512份回答。经过多轮检查,Astra定位到模型内部两处会加强重复输出倾向的模块,随后用补丁削弱这股倾向,同时保留原网络结构。
换句话说,Qwen3.5-0.8B的数学成绩飙升,并不是因为它一夜之间学会了高深数学,而是一次精准的“线路排障”:Astra顺着信号流动看懂了内部逻辑,掐掉了导致模型无限死循环的那根“短路导线”。研究者Yunfan Zhang进一步翻阅完整实验日志后发现,Astra只是在长篇推理模式下做了一组开关对照,识别出Qwen的推理链在打转,随后执行了定向清除。他讽刺道,故事的真实版本远没有宣传的“把准确率提高7倍”那么戏剧化。
小车爬坡与九路围棋,权重空间编程的野心不止修Bug
如果只盯着Qwen的数学分数,容易忽略这项研究真正想展示的能力边界。研究团队还设计了一个Kinetix模拟环境:原本用PPO训练的小车总是往坡上冲,然后卡住;要过关,得先倒车拉开距离,再加速冲坡。Astra不用工具,一次回复写出补丁,只改了约3.5%的权重,就让小车在1024次测试中全部成功。模型没能通过训练学会的动作顺序,被Astra直接写进了权重。
此外,Astra还展示了从权重中辨认形状、识别三个720万参数小语言模型分别用Python代码、日语罗马字和英语训练的能力,甚至找出了全部归纳头。在识别“谄媚模型”的实验中,它仅比较权重时无法作出判断,直到被允许观察模型在特定文本上的注意力模式,才识别出差异。这些实验说明,前沿模型直接操作权重的能力正在出现,但并非稳定、通用的“超能力”。团队也明确提示,小车实验只是修小网络的可能性,不能据此推到真实道路驾驶。
Lucas Beyer拆台:提示词早把“循环”二字递到手边
争议很快落在提示词上。研究者在X上的简短介绍,容易让人以为Astra只收到“让它数学更好”这样的目标,就自己发现了病因。但Meta研究员Lucas Beyer提出质疑:实际提示词已经强烈暗示了循环问题。公开日志确实写着,找出并修复重复不终止的原因,也算完成任务;工作步骤还提醒Astra检查截断与重复。
共同作者Jayden Teoh回应称,详细提示由Claude Code根据简短目标扩写。Alex Zhang也承认,提示里有暗示,数学涨分主要来自减少循环。所以,Astra是带着线索找问题。找到具体位置、写出修改代码并验证效果,仍然是它完成的工作,但这与“模型自己看懂权重、凭空变强”是两回事。
Haseeb Qureshi的澄清更直接:Astra是找到一个已发表的可解释性方法自己实现了,修掉小模型“死循环”的问题,分数就涨上去了;不是它看懂了权重,也不是数学能力凭空变强。证据之一是,换成一个本来不怎么循环的小模型,同样做法基本没动静。还有研究者提出,首先应该测试一个简单对照:直接关闭Qwen的思考模式,能否取得类似提升?如果调整推理设置就能大幅减少循环,那么权重编辑究竟带来多少额外价值,就需要重新评估。其次,这种方法还应与正常梯度训练比较,而不只是与一个表现很差的原始模型比较。
梯度下降的位子,真被“权重编译器”撬动了吗?
技术狂欢者的想象很直接:如果AI能找出并修掉模型内部的毛病,它能不能不断改进下去?斯坦福知名学者Omar Khattab也公开抛出一句挑衅式反问:“如果大
