工作流可以自我进化了,英伟达开源 SoL-Pi,每小时省13.5刀!

英伟达近日正式开源旗下AI工作流优化框架SoL-Pi,该框架基于现有Pi框架打造了效率增强层,可让AI编程智能体实现自我迭代优化,在降低Token消耗与API调用成本的同时,保持接近原版的任务完成质量,为长期运行的AI开发工作流提供了新的成本优化方案。
英伟达开源SoL-Pi剑指AI开发成本痛点
当前AI编程智能体的应用场景正在从简单的代码补全、单文件修改,向跨仓库问题修复、长时间自主开发等长任务场景拓展,单次任务运行时长可达数小时。但传统Harness(运行框架)的低效导致Token浪费问题日益突出:模型在完成任务后还需要额外推理轮次决定下一步操作、大文件内容在多次请求中重复传输、数千行日志中仅少量关键信息却需要模型全量读取,这些问题在长任务场景下不断累积,大幅推高了开发成本。更不用说递归自我改进(RSI)这类需要AI自主优化系统的场景,每一次改进尝试、每一个失败方案都会产生额外的Token开销,让“AI优化AI”的路线成本高企。
SoL-Pi由英伟达Efficient AI团队(由MIT副教授、英伟达研究总监韩松掌舵)开发,配置极为简单,用户仅需执行一行代码pi install git:github.com/NVlabs/SoL-Pi即可将框架部署到现有Pi环境中。实测数据显示,相较于底座Pi,SoL-Pi可减少45%-49%的Token消耗,成本降低约三分之一,平均任务得分保持在94%左右;相较于Codex、Claude Code等工具的原配Harness,Token消耗可减少35%-64%,API调用成本下降50%-54%,在专业研究场景下每小时可直接节省8.75美元至13.5美元。
长任务场景下Token空转成最大成本黑洞
Harness是支撑AI智能体完成任务的整套运行框架,负责将工具、上下文、执行反馈和任务流程组织起来,让模型能够实现读文件、改代码、跑测试、根据结果调整行动等操作。同一模型搭配不同的Harness,实际工作效率可能相差数倍。
当前长任务场景下的Token浪费问题早已成为行业痛点:模型完成文件修改后,明明下一步是执行测试,还需要额外发起一轮模型推理决策,中间的多余环节白白消耗Token;早前读取过的大文件内容,会在后续所有请求中重复携带;数千行的运行日志中真正影响决策的信息可能只有几行,但昂贵的模型依然需要从零开始全量读取。而在递归自我改进这类场景中,AI每一次尝试优化系统、每一个被淘汰的失败方案都会产生计费Token,进一步推高了落地门槛。
四大优化机制刀刀避开冗余消耗
英伟达通过自动化搜索流水线,让AI自主提出152个候选优化方向,经过自动实验、淘汰、验证后筛选出四大核心机制,针对性解决重复劳动问题:
- 动作融合:将单次文件编辑及其后续的测试/构建命令封装进同一个本地执行序列,由Harness底层直接完成修改、执行命令、返回结果的全流程,省去了中间单独的模型决策轮次,把两次分散的请求合并为一次高效闭环操作。
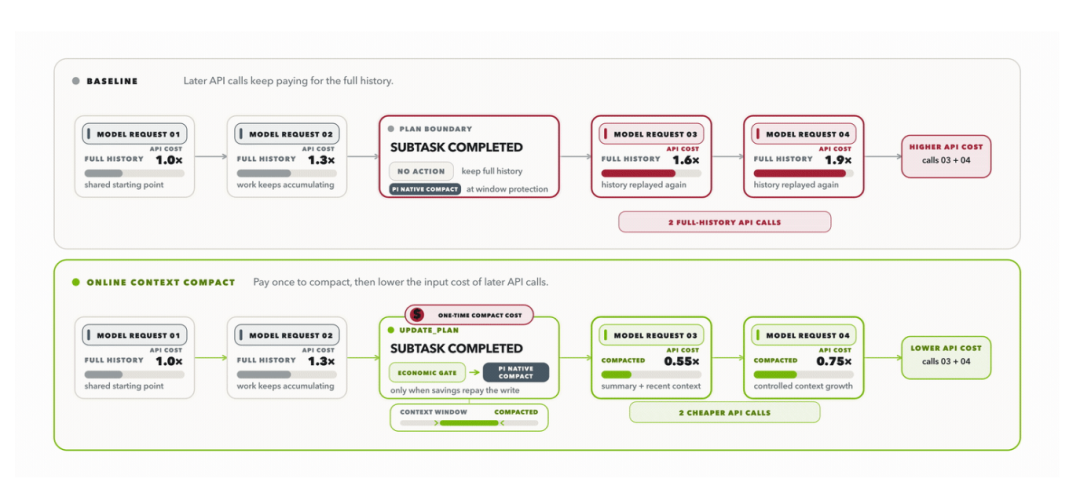
- 在线上下文压缩:按子任务动态核算上下文内容,仅保留当前步骤必要的相关信息,避免无差别携带大文件、历史日志等冗余内容,从根源减少无效Token消耗。
- 高频上下文缓存:对常用文件、历史操作记录等高频访问内容进行本地缓存,避免模型在任务过程中重复读取相同内容,进一步降低重复Token开销。
- 无效推理拦截:针对规则明确的固定流程(如修改代码后直接跑测试),提前预设执行路径,跳过不必要的模型推理环节,减少无意义的决策消耗。
在这四大机制的共同作用下,SoL-Pi实现了成本与效率的平衡,在大幅降低开销的同时,保持了接近原版框架的任务完成质量。
两大长线伏笔瞄准AI自进化飞轮
对英伟达Efficient AI团队而言,SoL-Pi当前实现的成本优化只是阶段性成果,其背后真正瞄准的是“AI研究AI”的自进化飞轮。官方项目主页中埋下了两个极具野心的长线规划:
其一是闭环预训练:当前SoL-Pi的535个测试环境仍由人工构建,未来计划让Agent自主完成全网任务收集、环境搭建、方案验证、Harness更新的全流程,通过提升算力投入与环境多样性,让Harness自身也跑出独立的Scaling Law。
其二是效率复利:用优化后的低成本Harness运行规模更大、成本更低的自动研究循环,进而挖掘出更多效率优化机制,形成“成本下降→研究规模扩大→更多优化机制被发现→成本进一步下降”的复利效应,最终实现AI工作流的完全自我进化。