获10亿美元A轮融资,Flapping Airplanes要破解AI的“数据饥渴”

今年10月,AI初创公司Flapping Airplanes完成由Index与Lux Capital领投的10亿美元A轮融资。今年1月,它刚拿到1.8亿美元种子轮融资,GV、Sequoia Capital和Index Ventures是主要投资者。两轮融资的机构名单还包括Nova Global、Valor、Atreides、Kleiner Perkins、Fundomo、Steve Cohen、BCV、Menlo Ventures、Hummingbird、Victor Lazarte、Absolute Ventures、CRV、Seven Stars、Genesis、Jump Trading、XTX Ventures、Snowy Leopard和NVIDIA。资本押注的并非又一个常规大模型,而是一条更底层、也更难的路线:让AI不再靠海量数据“喂”出来。
Megakernel把上百个算子关进同一个内核
Flapping Airplanes首先把矛头对准GPU内核调度。传统推理过程中,模型每执行一段计算,往往要退出当前kernel,再启动下一个kernel,频繁切换会带来额外开销。团队要做的,是在一个内核中组织上百个算子。
他们先在GPU内部设计了一套解释器,把Llama模型的主要计算归纳为7类指令,并提前为每个SM(Streaming Multiprocessor,流式多处理器)安排好执行顺序。这样,GPU可以在一个持续运行的kernel内依次完成整套前向传播,不必反复退出再启动。
这一步的关键难点在于:如何让上百个算子在同一内核里有序运转。Flapping Airplanes用指令化归纳和SM级排程,把原本分散的推理步骤压进一条持续执行的流水线。
16KiB页面让权重提前“候场”
另一个难点是共享内存。为了让下一条指令在前一条指令尚未完全结束时就提前加载权重,团队把每个SM有限的共享内存切分成多个16KiB的页面。不同指令按需申请和释放这些页面,一旦有页面空出来,就立即交给后续指令使用。
这样一来,下一步所需的权重可以提前加载,并与前面的计算和数据写回重叠,从而减少GPU等待显存数据的时间。换句话说,权重不必等到当前计算彻底结束才“上场”,而是可以提前进入备菜区,让计算和数据搬运同时进行。
这套共享内存调度机制,配合持续运行的Megakernel,成为Flapping Airplanes榨干GPU性能的重要基础。
H100上跑到78%带宽利用率,1毫秒完成前向传播
在H100上,这套Megakernel将显存带宽利用率提高到了78%。在同样的Llama-3.2-1B低延迟推理任务中,其速度接近vLLM的2.5倍,并首次将10亿参数以上、16位精度语言模型的单次前向传播压到1毫秒以内。
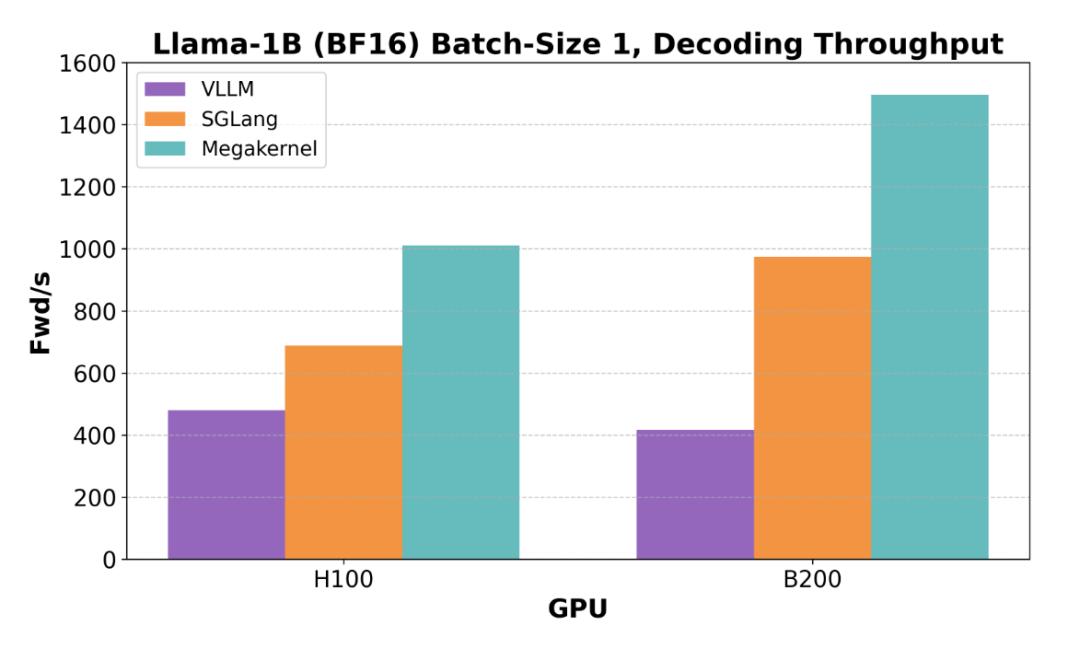
在Flapping Airplanes,Megakernel已经成为一个更完整的框架,能够支持非常规的模型架构、目标函数与优化器,并在同一个内核中,将受限于显存带宽的推理计算与受限于算力的模型训练重叠并行。目前,该框架已能独立执行完整的模型训练、提供推理计算服务、运行视频游戏,甚至可以在单一内核中同时执行这三项任务。
这意味着Megakernel不只是推理加速工具,它还在尝试把训练、推理和其他计算任务放进同一套底层执行框架里,减少不同任务之间的切换与等待。
Megakernel不是终点,损失函数才是下一站
但Megakernel并不是Flapping Airplanes的终点。他们的第二阶段要做一件更本质的事情:探索AI的全新技术路径,甚至重新设计损失函数,重构梯度下降算法,以构建样本学习效率更高的AI模型。
这个构想背后的思考,来自团队对人脑与现有AI模型样本学习效率的比较。人类的大脑只需要少量样本就能学习一项新技能,而现有模型能够调动极其广博的知识库,但它们很难快速掌握新技能,哪怕做一点适应性调整都需要灌入海量数据。
Flapping Airplanes表示,这套系统已经在万亿参数级预训练规模上得到内部验证。10亿美元A轮融资背后,资本押注的也不只是一套更快的GPU内核,而是一条可能改变AI学习机制的路线:从“堆数据”走向更高样本效率的学习方式。
