Happy Wan
Happy Wan 是一款无需本地显卡、在浏览器里就能把一句话或一张照片变成 4 至 15 秒 1080P 带原生同步音效视频的 Wan 3.0 AI 视频生成器。
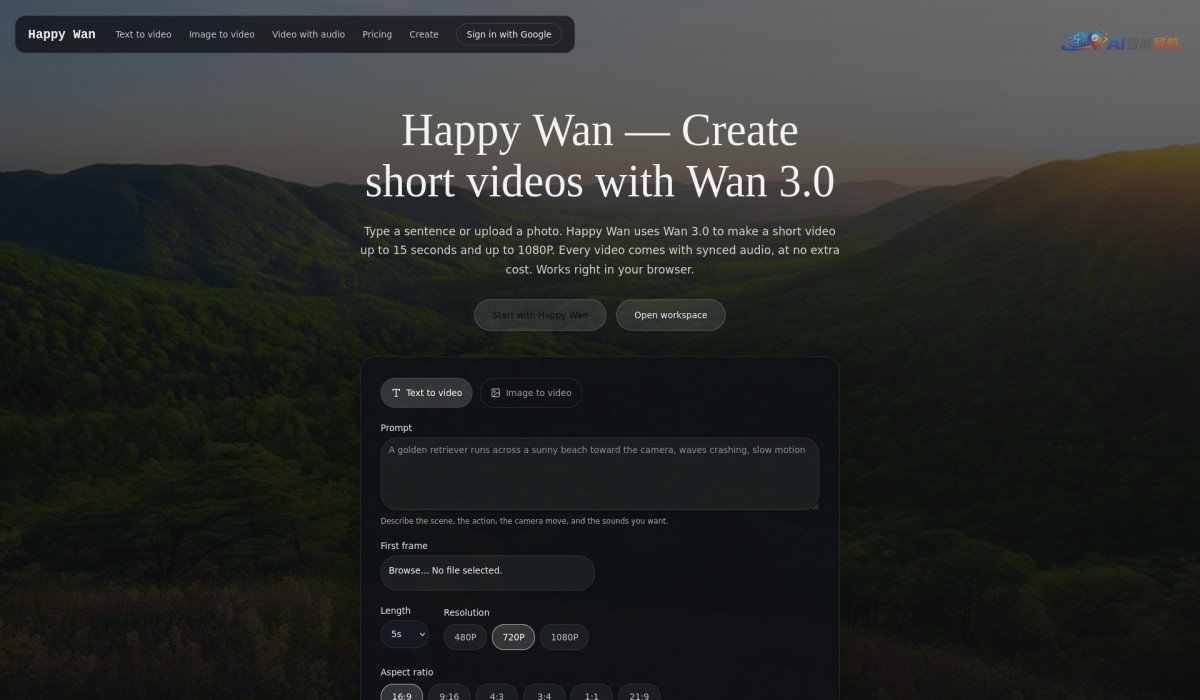
Happy Wan是什么
Happy Wan 是面向创作者与小型企业的浏览器端 AI 视频生成工具,基于 Wan 3.0 模型构建。它最突出的特点是“轻”——整个创作流程都在浏览器中完成,用户不需要在本地配置独立显卡,也不需要安装复杂的渲染环境,只要有一句话或一张图片,就能在几分钟内得到一段可用的短视频。
从产品定位来看,Happy Wan 主要解决三类用户的痛点:
- 个人创作者:缺少专业剪辑能力与设备预算,但需要持续产出社交平台短视频。
- 小型企业:需要低成本的产品展示、活动宣传、社交媒体素材,但难以负担专业视频团队。
- 营销与运营人员:需要快速测试不同创意的效果,要求产出速度快、修改成本低。
与传统视频制作流程相比,Happy Wan 把“脚本—拍摄—剪辑—配音—合成”这条长链路压缩成了一个输入框加一次生成。用户提供的是创意表达,剩下的画面生成、时长控制、音画同步由模型完成。
核心功能与能力边界
Happy Wan 的功能设计围绕“短、快、清晰、有声”四个关键词展开,具体能力可以概括为下表:
| 能力维度 | 具体表现 |
|---|---|
| 输入方式 | 支持文字描述转视频,也支持上传单张图片驱动生成 |
| 视频时长 | 单次输出 4 至 15 秒的短视频片段 |
| 分辨率 | 最高支持 1080P 输出 |
| 音频 | 原生同步声音,音效与画面在同一生成流程中产生 |
| 运行环境 | 纯浏览器运行,无需本地 GPU 算力 |
| 使用门槛 | 无需安装软件,无需专业剪辑经验 |
其中,“原生同步声音”是它区别于许多同类工具的关键点。不少文字转视频工具只生成无声画面,音频需要另外寻找素材并手动对齐;Happy Wan 在生成阶段就把声音纳入模型输出,省去了后期匹配音效的步骤,对不擅长音频处理的用户尤其友好。
4 至 15 秒的时长限制看似保守,但实际上非常贴合当下主流短视频平台的传播逻辑——短片段更适合做开头吸引、产品特写、氛围铺垫,也便于批量生成后组合使用。
使用流程
Happy Wan 的操作路径非常短,基本可以归纳为四步:
- 选择输入类型:决定是用一句话描述画面,还是上传一张已有图片作为起点。
- 撰写或确认描述:文字输入时,尽量说明主体、场景、动作与氛围;图片输入时,可补充希望画面如何运动。
- 设定输出参数:根据用途选择视频时长与清晰度,明确是否需要同步音效。
- 生成并下载:等待模型完成渲染,预览效果后进行下载或调整重生成。
对于初次使用者,有几个实用建议:
- 描述中写清“谁在做什么、在哪里、光线如何”,比堆砌形容词更有效。
- 首轮先用较短时长试生成,确认画面方向符合预期后再延长时间。
- 图片输入时优先选择主体清晰、构图简洁的素材,运动效果会更自然。
适用场景与创作思路
Happy Wan 的输出规格决定了它更适合“片段级”而非“成片级”的创作。把多个 4 至 15 秒的片段串联起来,就能覆盖大部分轻量内容需求:
- 社交媒体内容:为图文帖子配上动态视频版本,提升信息流的停留率。
- 产品与店铺展示:用一张产品图生成带光影变化的展示短片,用于详情页或广告位。
- 活动与促销预告:快速产出多条不同风格的短素材,做 A/B 测试。
- 故事与概念可视化:把剧本中的关键镜头先做成动态分镜,便于团队沟通。
- 教育与科普片段:为抽象概念配一段具象化的短画面,帮助理解。
在创作思路上,建议把 Happy Wan 当作“素材生产器”而非“一键成片工具”。先批量生成多个候选片段,再从中挑选节奏与氛围最合适的组合,往往比反复修改单条描述更高效。
优势与注意事项
Happy Wan 的核心优势集中在三点:零硬件门槛让更多人能参与视频创作;文字与图片双输入覆盖了从零构思和从有到动两种典型需求;音画同步生成减少了后期环节,缩短了从想法到成品的距离。
同时也要对它的能力边界保持清醒认识:
- 时长上限为 15 秒,复杂叙事需要拆分为多个片段。
- 生成结果具有随机性,重要用途建议多轮生成后择优使用。
- 涉及具体人物、品牌标识或精确文字的内容,需自行核对是否符合预期与相关规范。
- 商用前应确认素材版权与平台使用条款,避免直接使用他人受保护的形象或画面。
总体而言,Happy Wan 适合那些希望以极低启动成本进入 AI 视频创作的个人与小团队。它的价值不在于替代专业制作,而在于把“先做一个能看的版本”这件事变得足够快、足够简单。
