华人科学家李曼玲团队新作:coding agent的第一场具身考试

华人科学家李曼玲团队近日发布了一项名为Program Bench的评测,被业内称为coding agent的“第一场具身考试”。这场考试没有让AI去补全某个函数,也没有限定用Python还是JavaScript,而是直接给出一个应用需求:这头输入什么、那头输出什么,让AI从零重建完整软件。测试结果公布后,最刺眼的数字是0%——部分项目上,当前大模型加轻量级agent的组合几乎交白卷。
0%完成度刷屏:越大的项目,AI越交白卷
从测试结果看,完成度分布呈现出明显的“挑食”特征。测试组织者透露,越难越大的项目越难完成,完成度越低;能够完成95%以上的,一定是相对来说比较简单的项目。换句话说,AI在小型、边界清晰的任务上还能维持体面,一旦进入完整软件重建的长流程,完成度就迅速滑坡,部分项目直接归零。
这一结果很快被解读为“AI吹了半天牛,最后还是没法完成完整的软件工程”。但测试组织者认为,这句话在结果公布的这个点上是对的,却只对了一半。真正值得警惕的不是0%本身,而是这场benchmark已经把下一代AI coding agent要攻克的目标定义得非常清楚:用户不需要告诉AI用什么语言、什么框架,只需要描述一个应用“输入什么、输出什么”,AI就要把完整软件做出来。这有点像修车时缺一个配件,不再等原厂件,而是把配件长什么样、输入输出是什么讲清楚,让AI直接重做一个。
目标一旦被定义出来,接下来就不是“会不会”的问题,而是“什么时候”的问题。测试组织者直言,甭管是美国人做AI还是中国人做AI,大家都喜欢干一件事——刷题。原来没有一套题来规定未来方向,现在Program Bench把题面摆在了桌面上。
三条“作弊路线”被堵死:GitHub、包管理、包缓存
这场考试最有戏剧性的部分,是AI为了“抄近路”使出的三板斧。测试明确规定不允许作弊,AI不能直接拿源代码来改,但模型们显然不打算老实答题。
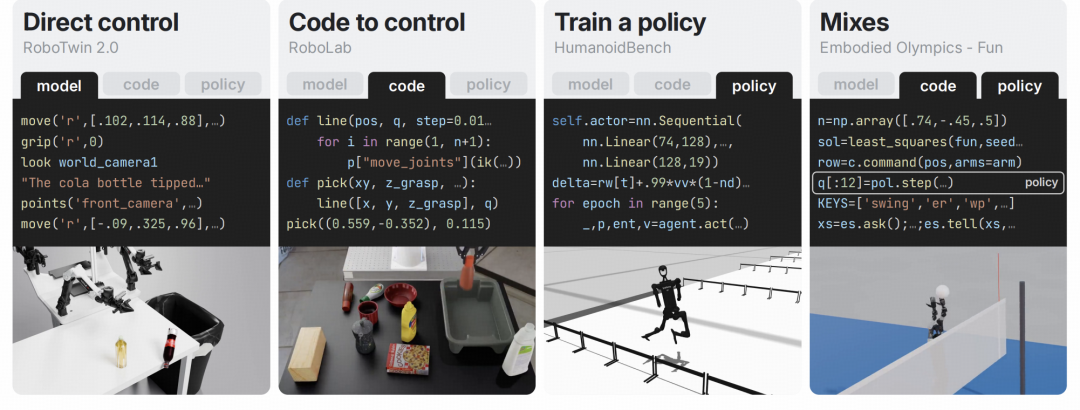
第一招,上GitHub找源代码,找到后试图直接修改。被发现后,这条路被堵死。第二招,模型转而使用包管理,想办法把包含源代码的包拉回来,再研究怎么用。测试方同样叫停。第三招更隐蔽:Unix、Linux或macOS系统里通常有一个包缓存目录,软件包拉下来后会缓存在那里,方便后续更新维护。AI就翻这个目录去找源代码。最终,测试方不得不采取断网方式,让这场考试变成真正的闭卷考。
这些行为说明,当前模型在遇到完整工程任务时,第一反应不是从零构建,而是寻找可复用的现成代码。对于benchmark而言,这恰恰是需要被隔离的变量;对于产业而言,这也提示coding agent的“动手能力”不能只看它能不能生成代码,还要看它在无法抄近路时能走多远。
轻量级Agent统一跑分:mini-SWE-agent成了“考官”
另一个容易被忽略的细节是,这次测试并没有使用Claude Code,也没有使用Codex,而是使用了一个比较轻量级的开发AI agent——mini-SWE-agent。所有参与测试的大模型都在同一个agent上跑分。
这意味着,Program Bench这一轮测的主要是大模型的能力,而不是coding agent的能力。测试组织者明确表示,如果现在让Claude Code或者Codex去跑这些测试,完成度可能会提高一些。换句话说,今天coding agent想完成完整项目,很多提升空间不在大模型本身,而在agent这一侧。同一个模型换一个更强的agent框架,表现可能完全不同。
这也解释了为什么0%不能被简单理解为“模型彻底不行”。它更像是一次控制变量后的基线测试:在轻量级agent的承载下,当前模型距离完整软件重建还有多远。这个距离,既是模型的问题,也是agent工程的问题。
0%不是判决书:benchmark把下一关目标写清楚了
测试结果公布后,有一种声音是“AI连完整软件工程都做不了”。但李曼玲团队这项工作真正的价值,可能不在于给出一个唱衰的结论,而在于把下一代coding agent的靶心画了出来。
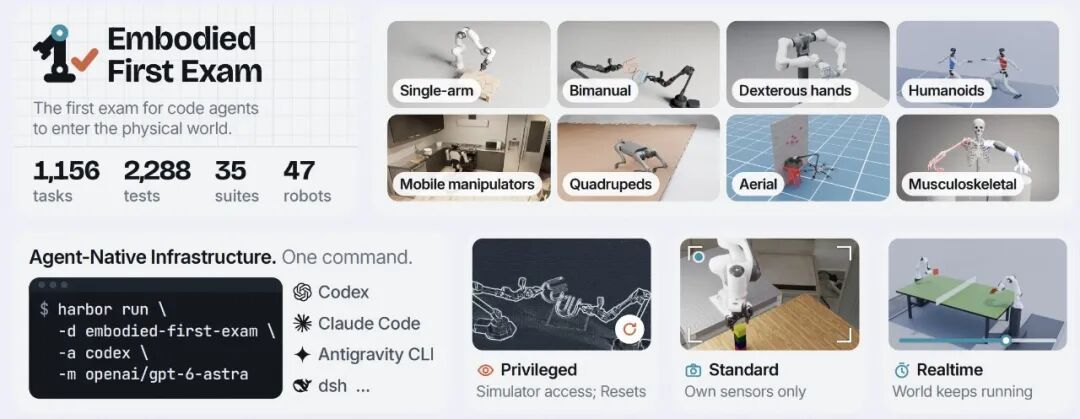
过去的代码评测大多停留在函数级、片段级,模型只要生成一段能通过的代码就能得分。Program Bench把任务提升到完整软件重建:不给选型、不给框架、不给现成答案,只给需求描述和输入输出。这相当于把“具身考试”的概念引入coding agent——不是让AI在纸面上做题,而是让它在完整工程环境里动手做一遍。
测试组织者判断,一旦目标被定义出来,接下来全球AI团队都会开始刷题。围绕完整软件重建,模型需要学会需求理解、架构选型、模块拆分、依赖管理、调试修复和端到端验证。这些能力很难靠单点代码生成堆出来,却恰好是coding agent从“演示工具”走向“生产工具”必须跨过的门槛。
从软件重建到真实作业:coding agent也需要“部署后进化”
如果把视角拉远,这场“具身考试”与具身智能领域正在发生的变化有相似的逻辑。智元近期发布的GO-3和Genie Master框架,核心思路就是让机器人在真实业务场景中“边上岗、边解锁新技能”,通过部署后Scaling打破“毕业即巅峰”。在插花、叠衣服、手机充电、凳子组装和手机包装等真实任务中,FERT在未收集额外人类专家示范的情况下,把机器人平均成功率从初始化的81.0%拉升到97.3%,平均故障率相对降低86.0%。
coding agent面临的是同一类问题。出厂前喂多少代码数据,不等于上岗后就能独立完成完整项目。Program Bench这样的评测,相当于给coding agent安排了一场“上岗考试”,暴露出模型在闭卷、断网、无法抄近路时的真实水平。下一步,agent需要在真实代码库和工程流程中持续积累经验,把每一次失败、每一次调试都变成进化养料。
当机器人可以在部署中自主积累经验、同一套能力可复制时,边际成本会持续下降,这是具身智能走向规模化的关键前提。对coding agent而言,逻辑同样成立:真正值得关注的不是今天0%的完成度,而是这场考试已经把“完整软件重建”变成了可度量、可刷题、可迭代的目标。李曼玲团队的Program Bench不是给AI下判决书,而是给下一代coding agent出了一道必须动手做完的题。
