黄仁勋辞任后人工智能算力建设并非垃圾时间

在多地数据中心走访中,最直观的场景不是算力过剩,而是“有卡不敢满配”。一些老旧机房在原基础上做简单改造,电路没法大改,供电跟不上,一台服务器只能跑两张AI算卡,远未达到八卡满配的设计能力。明明机房条件不行,也要硬跑AI,原因无他:算力需求上涨太快,基础设施远没有建设到位。这个细节比资本市场的一根阴线更能说明问题——AI算力不是没人要,而是高质量供给还没跟上。
老旧机房硬塞两张卡,算力饥渴撞上供电天花板
把老旧数据中心改造成智算中心,正在成为一股现实潮流,但改造的物理边界很快暴露出来。
- 供电系统按旧标准设计,电路无法大改,单机柜功率密度上不去,八卡服务器只能降配运行。
- 制冷系统仍以传统机房思路为主,面对高密度AI集群,局部热点和能耗压力迅速放大。
- 楼板承重、配电冗余、蓄冷时长等指标,也不是靠加几台服务器就能补齐。
这解释了一个看似矛盾的现象:一边是海外资本市场讨论AI泡沫,一边是国内不少机房仍在“硬跑AI”。需求端并没有突然消失,模型训练、推理调用、行业应用都在消耗算力;供给端却存在大量低质量、改造型的智算中心,无法承接高密度、高连续性的AI计算任务。真正稀缺的不是“机房”两个字,而是能满配跑卡、能稳定供电、能算清成本的高质量算力基础设施。
黄仁勋离场掀开遮羞布,海外循环融资先被追问
2026年11月12日,黄仁勋辞任英伟达的消息把全球AI算力泡沫论推向高潮。靠卖AI算力成为全球市值第一公司的创始人,以这样的方式离场,市场情绪可想而知。但更值得追问的是:难道没有这场风波,英伟达的股价就不会跌吗?海外资本市场早已出现AI泡沫破裂的迹象,黄仁勋事件只是掀开了AI算力产业的一块遮羞布。
国际清算银行在2026年经济报告中专门讨论了海外AI产业的循环融资问题。简单说,芯片厂商、超大规模云服务商通过投资AI公司或算力服务商,后者再承诺购买芯片或计算服务,资本在产业链中形成相互支撑的关系。这种“左脚踩着右脚上天”的增长模式,用未来的增长预期支撑今天的投资,再用今天的投资证明未来的增长预期,当然不可能无限持续。
所以,过去那种不计成本的军备竞赛式扩张,肯定不能一直持续,泡沫破灭只是早晚。算力建设是要变,但不是要进入垃圾时间。海外市场要消化的是估值透支和循环融资,国内要解决的则是高质量供给不足和商业闭环未跑通,两者不是一回事。
芜湖把国产化率写到90%,订单排到两三年后
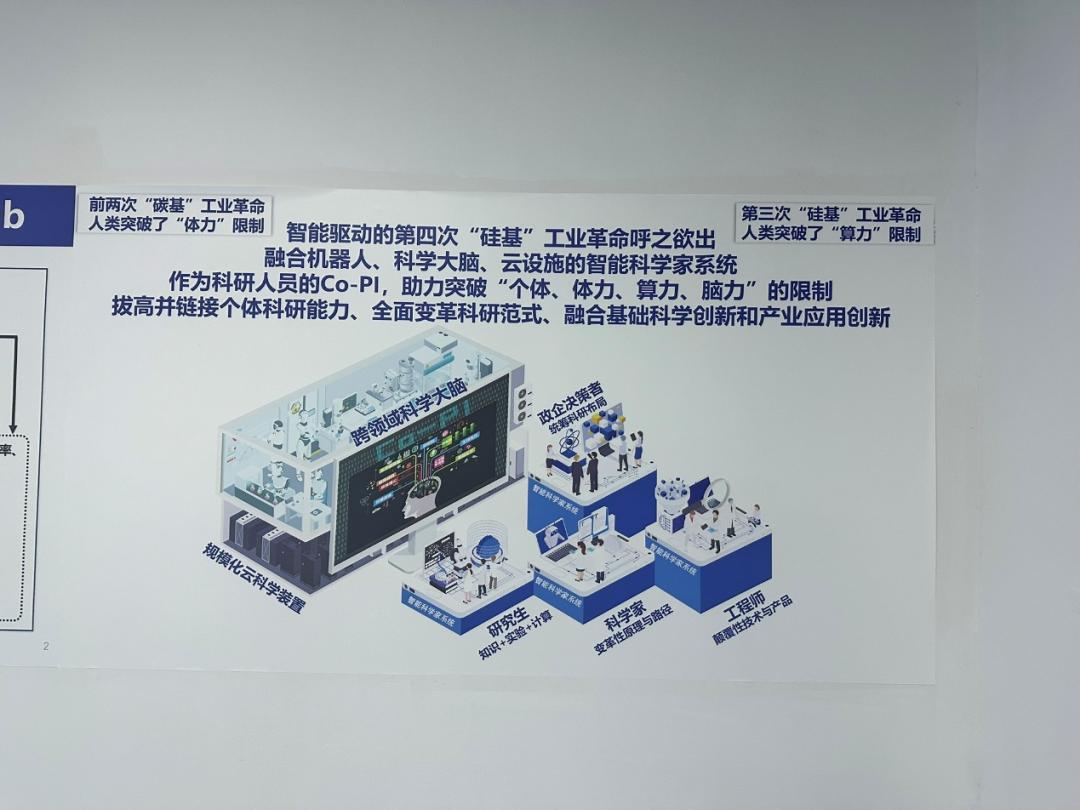
与海外“降单一押注”的逻辑不同,国内AI算力建设呈现出另一番景象。以芜湖为例,当地对计算中心建设提出90%以上国产化率的要求,这意味着相关项目在规划和建设之初,就要优先考虑国产算力产品。
但国产算力供给并不是无限供应。受生产能力、制造良率等因素制约,部分国产算力产品的订单已经排到了两三年之后。需求在,政策在,供给却需要时间爬坡,这就是国内算力建设的真实矛盾。
也正因如此,新一代智算中心与传统改造型机房拉开差距:
- 传统改造型机房供电与制冷集中同层,供电不足,单机仅支持两张卡;新一代方案采用分层设计,把水冷层、计算层、供电层分开,支持八卡满配。
- 传统机房楼板承重不足,难以承载超过1吨的超节点;新一代智算中心专为高密度AI集群优化承重设计。
- 传统机房蓄冷罐仅15分钟,新一代方案可达1小时,满足金融AI等高连续性场景。
- 规划指标从“按机柜、按服务器数量”转向“按电力单位GW规划”,强调算电协同。
- 一些地区还把国产化率、PUE<1.5等作为可验证指标,推动算力建设从堆设备转向系统设计。
这说明,智算中心还没有进入垃圾时间,但必须对重复建设的低质量智算中心说NO。
DeepSeek一限流,推理账单先露底
2026年11月16日,DeepSeek因算力不足限制超过7天不活跃的长对话及每日对话额度。这是国民级AI应用首次公开暴露算力瓶颈,也让“算力过剩论”显得尴尬:如果算力真的多到用不完,为什么国民级应用还要限流?
问题在于,算力需求没有触顶,但高质量供给不足,商业账也算得艰难。
- 普通消费者使用AI越来越频繁,但这并没有自动转化为模型厂商的收入。每调用一次,厂商都要承担推理成本。
- 一些国产大模型仍对免费用户设置调用次数和额度限制,或在高峰期限制访问,因为商业收入和算力成本目前还打不平。
- 企业端同样如此,地方政府可以用补贴“扶上马送一程”,但不可能永远替企业买单。补贴退出后,企业还愿不愿意拿出真金白银购买算力服务,取决于AI能否带来足够的经营收益。
- 如果AI进入实际生产后没有带来足够回报,企业的算力需求就会止步于“薅羊毛”。
这些瓶颈,比黄仁勋的桃色花边新闻更真实,也更值得追问。黄仁勋事件提醒从业者,不要被每一条热点新闻牵着鼻子走。真正要回答的是:算力建在哪里、给谁用、谁来付费、能否持续。
从“跟着老黄买GPU”到算力战国,垃圾时间只属于重复建设
后黄仁勋时代,全球数据中心正在告别单一教主,进入算力战国。过去那套“跟着老黄买GPU、跟着NVLink建集群、跟着CUDA做生态”的简单范式走到分水岭。不是算力周期结束,而是定义算力的人换了。
第一层变化来自需求迁移:算力重心从训练转向推理。推理对软件栈的绑定没有训练那么刚性,大量专用NPU、ASIC、低成本加速器可以在这里抢份额,不需要完整复刻CUDA。
第二层变化来自替代栈成熟:ROCm、各类开源加速框架、国产软件栈持续补齐。只要迁移成本可控,云厂商就愿意为供应链安全承担一部分适配成本。
第三层变化来自客户自制:头部模型公司开始打造自己的抽象层,把底层硬件封装起来。硬件可以轮换,模型资产、调度框架、智能体运行时才是不能丢的资产。谷歌第七代Ironwood TPU已正式商用,亚马逊Trainium3进入商用阶段,都是客户自研的注脚。
市场数据也在变化。路透社援引IDC数据报道,2026年上半年,中国数据中心AI加速器市场中,英伟达市场份额已降至34%,出货量同比下降44%;华为出货量达到57.2万颗,市场份额约28%。华为2026年披露,CANN外部开发者占比已达到61%,超过5200名月活跃开发者,已有40多个模型在昇腾和CANN上完成原生预训练。方舟投资创始人凯茜·伍德则预计,英伟达约83%的GPU市场份额会逐步流向特斯拉Terafab、博通以及Cerebras等新锐芯片公司,五年后市占率可能下调至38%。
短期看,英伟达已经铺出去的长期框架、锁定的大客户订单、Vera Rubin路线图和预制AI工厂交付计划,仍会按原有节奏往前走。真正的变量不在已经签好的订单,而在新增预算的分配逻辑:客户会从单一追求最强性能,转向性能、成本与供应链安全的综合平衡。资本市场也会从“一枝独秀”的确定性溢价,转向GPU、ASIC、自研芯片、高速互连、交换芯片、光模块、服务器ODM和推理侧性价比方案的“百花齐放”。
所以,AI算力建设并没有进入垃圾时间。垃圾时间只属于重复建设的低质量智算中心,属于没有商业回报支撑的算力投资,属于靠补贴和概念硬撑的机房。真实需求仍在,高质量供给仍缺,国产算力仍在爬坡,推理账单仍待跑通。对这些问题的回答,比追问黄仁勋的花边新闻重要得多。
