ICLR 2027首轮评审,槽点有点多

首轮评审意见陆续公开后,OpenReview上的画风有些失控。有人收到了一份要求解释“standard deviation”的评审意见,有人发现三位审稿人里有两位的评语几乎一字不差,第三位则把“Certainly! Here is a review of the paper”原封不动贴了上来。与此同时,Paper Copilot的统计数字显示,ICLR 2027已记录42,790份投稿,其中活跃稿件40,335份,撤稿773份,Desk Reject 1,682份。审稿资源与投稿规模之间的裂缝,在这一轮评审里被撕开了一个口子。
审稿人请作者解释什么是标准差
加州大学伯克利分校的Hanchen Li在社交平台上发帖,说自己收到了一份ICLR评审意见,对方要求他们解释什么是“standard deviation”。他开玩笑说,这下仿佛又回到了高中课堂。
原帖没有展示完整的论文和评审上下文,因此无法判断审稿人究竟是希望作者补充统计定义,还是对论文中某个具体用法存在疑问。但这条帖子迅速引发了讨论,因为“标准差”几乎是机器学习论文里最基础的统计概念之一。对作者来说,几个月的研究工作换来一句“请解释标准差”,很难不产生一种错位感。
这类意见未必说明审稿人完全不具备专业能力。在评审时间被严重压缩的情况下,审稿人可能只是快速扫过论文,对某个表述产生了疑问,却没有精力去区分“作者没写清楚”和“自己没看懂”。但当这种疑问以正式评审意见的形式出现时,作者感受到的就是另一回事了。
三份意见两份复制粘贴,第三份连AI开场白都没删
另一位研究者Ravid Shwartz Ziv展示的情况更有喜剧效果。他贴出了三位审稿人的意见。
第一位写道:“The paper is well-written and addresses an important problem. However, the authors should consider additional baselines.”第二位几乎原封不动地重复了这句话。到了第三位,画风突然变了:“Certainly! Here is a review of the paper”,后面才开始进入正式评审内容。连AI生成文本常见的对话开场白都没有清理干净。
两份评语像是从同一个模板里复制出来,第三份则留下了更明显的AI生成痕迹。更让作者无奈的是,这些意见最终都进入了正式的同行评审流程。对作者而言,这意味着他们需要认真回应一份可能由另一个模型在几秒钟内生成的评审意见,而这份意见的质量,直接影响论文的命运。
还有一位研究者Konstantin Grotov遇到的问题涉及AI辅助写作。他表示,自己提交ICLR的论文收到了一条主要针对AI使用情况的评审意见。问题在于,论文已经按照要求披露了AI辅助写作。ICLR 2027要求作者在论文和Submission Form中说明LLM的使用情况,并把不同科研环节分为“必须披露”和“建议披露”两类。作者按规则做了披露,评审意见却仍然把AI使用当作一个未被说明的问题来质疑,这种“已读乱回”式的评审让作者颇为无奈。
四万两千份评审背后,审稿人已经不够用了
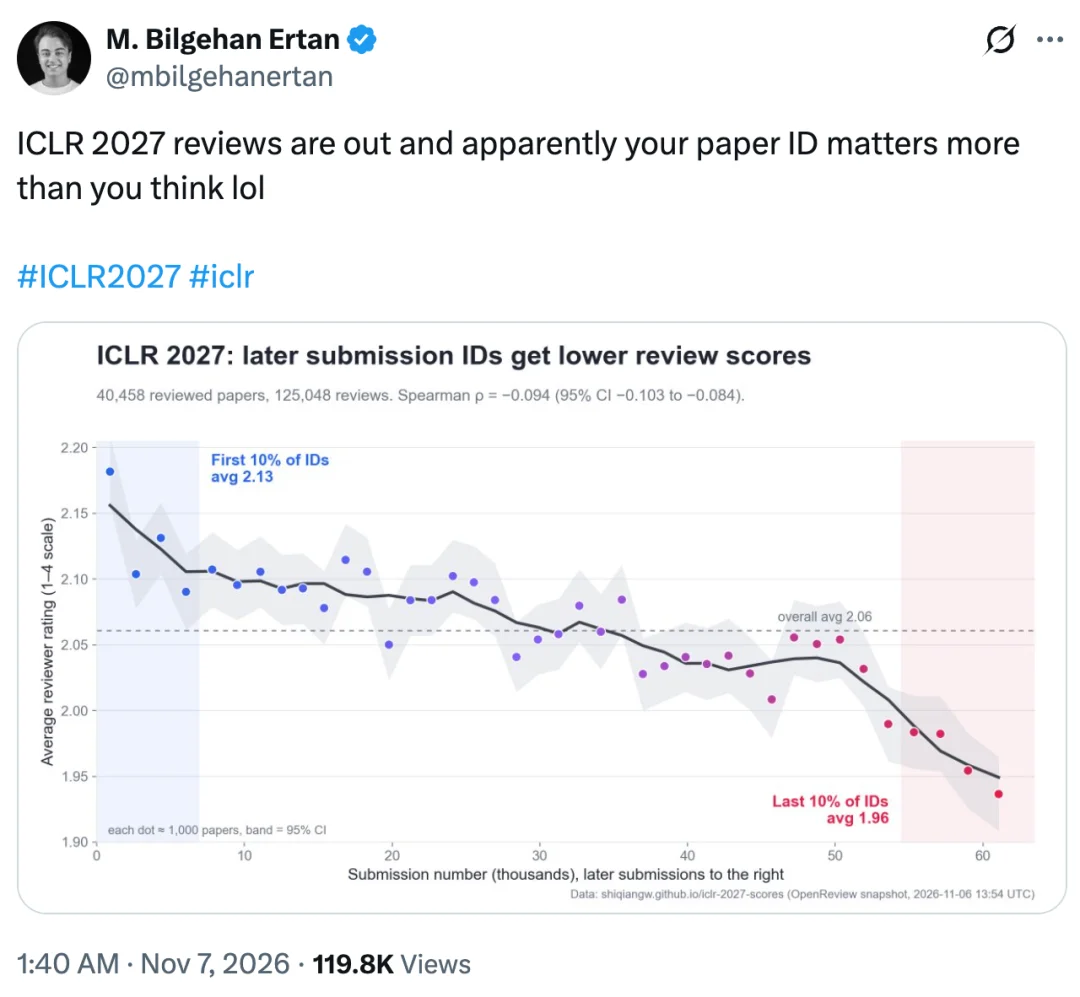
把这些个案放在一起,能看到一个更结构性的问题。Paper Copilot的统计显示,ICLR 2027的评审维度覆盖rating、confidence、soundness、informativeness、presentation等12项指标,每项均对应42,790份记录。而在此前的ICLR 2026周期中,评审平均分已经从上一年的5.12降到了4.2。ICLR官方在复盘中确认,他们不得不在所有审稿意见上运行LLM内容检测器,因为“超过75000份审稿的巨大规模,使得仅靠人类判断来一致地标记和发现问题审稿变得不可能”。
审稿人数量并没有跟着投稿量一起膨胀。在投稿量“只有”1.9万篇的时候,平均每位审稿人已经被分配了约4.2篇论文。到了ICLR 2027,投稿编号一度逼近6.2万,审稿人的注意力成为整个评审系统里最稀缺的资源。当每位审稿人被迫在有限时间内处理更多论文时,“让审稿人快速理解你的贡献”变得比“贡献本身有多深”更加关键,而快速理解的反面,就是“标准差”式的提问和模板化的评语。
SAC平均分只有2,一篇差评就能决定命运
除了评审质量,评分标准的变化也让作者们绷紧了神经。Reddit上有讨论称,今年的ICLR评审似乎非常严酷,因为采用了新的评分标准,一篇差评就可能导致论文被拒。有人提到,SACs报告的平均值和中位数都是2。
这种收紧直接改变了作者的预期。在往年的评审季,作者们还会讨论“三个审稿人里有一个给低分还有没有救”,今年不少人已经在预测“绝大多数会是222、221或223”,并提前把希望寄托在rebuttal和AC选择上。一位用户写道:“放轻松,没必要紧张。绝大多数会是222、221或223。所以大家都在同一个情况之中,都需要进行反驳,并且等到AC选择来区分人群。”
评分标准收紧本身未必是坏事。在投稿量膨胀、评审意见质量参差不齐的情况下,更严格的分数分布可以帮AC更快地筛掉明显不合格的稿件。但它同时也放大了单份评审的权重。如果一份低分意见来自一个没看懂论文的审稿人,或者一份AI生成的模板评语,作者要在rebuttal阶段扭转局面的难度就会成倍增加。
主席团队承认:AI把生产端和评价端同时改了
ICLR 2027项目主席团队在9月2日发布了一篇官方文章,专门分析了AI时代同行评审面临的新压力。文章指出,机器学习领域近年来增长迅速,新进入者的数量远远超过资深研究者,具备专业评审能力的人手可能跟不上投稿增长。生成式AI又进一步降低了论文生产门槛,即使是不熟悉某个研究领域的人,也可以借助AI生成一份外观上像研究论文的稿件。与此同时,审稿人将评审工作交给AI,也成为需要解决的新问题。
为缓解评审资源紧张,ICLR 2027推出了一系列措施,包括限制投稿数量、强化互惠审稿制度等。互惠审稿的认可范围涵盖ICLR、NeurIPS、ICML、JMLR、TMLR、ACL、EMNLP、CVPR、ICCV、AAAI、IJCAI、ICRA、KDD、COLT等会议和期刊,Workshop、Position Paper、Tiny Paper等则不能用于满足要求。官方还要求所有作者在全文截止前完成OpenReview Profile创建并正确关联,否则论文可能被Desk Reject。
这些措施针对的是同一个问题:当AI同时降低论文生产门槛和评审门槛时,同行评审这套依赖专业判断和时间投入的机制,需要重新找到自己的支点。ICLR 2027首轮评审暴露出的槽点,与其说是某几位审稿人的水平问题,不如说是系统在规模压力下的一次集中显影。对作者来说,接下来能做的,大概就是在rebuttal里把“标准差”解释清楚,同时祈祷第三位审稿人的开场白不会出现在正式回复里。
