机器人干活的关键:把大脑搬上云

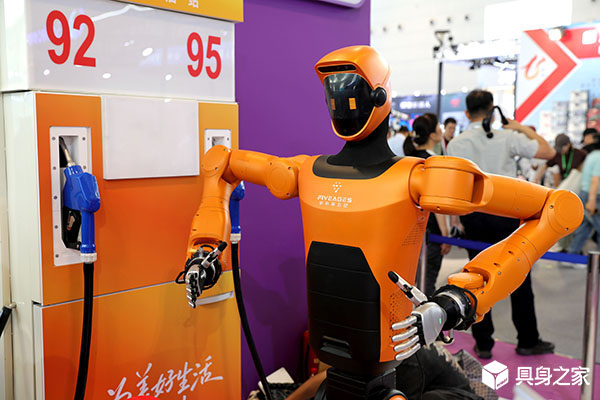
过去三年,AI的主战场在一块屏幕里;现在,它正在向物理世界突破。从酒店洗衣场景的轮式人形机器人,到工厂里的双臂机器人移箱取物,再到展会现场连续出餐、制作咖啡的服务机器人,行业关注点已经从“机器人能不能动”转向“机器人能不能干”。而要让机器人干活,先把大脑搬上云,正在成为具身智能产业落地的一条清晰路径。
千万小时数据缺口逼出“云上大脑”
具身智能的第一道门槛,是数据。国金证券研报数据显示,行业预计成熟具身大模型所需的数据至少为千万小时级,进一步迈向通用智能则可能需要亿小时量级;而当前行业高质量训练数据仅数十万至百万小时,供需缺口约90%。
更棘手的是,原始数据并不能直接变成训练数据。腾讯云存储首席技术专家温涛在公开场合表示,在具身领域采集上来的原始数据,只有5%能直接用于训练。腾讯云异构计算产品副总监黄阳则强调,具身智能的群体经验复制率是0.01%。这意味着,高质量物理交互数据的供给缺口是结构性的,从原始数据到训练数据之间,还存在大量清洗、标注、治理和检索的工程工作。
这也解释了云计算厂商为何纷纷加码具身智能。要解决数据瓶颈,核心着力点是让数据的采集、存储、治理、传输和训练更高效。腾讯云在基础设施层面推出了一系列工具和产品,搭建从算力底座、模型服务到感知交互的三层体系,打造覆盖研发、训练与交付的具身智能云+AI底座。
在算力和模型层面,腾讯云提供包含国产算力在内的GPU/HCC高性能计算等服务,持续升级异构算力及Hyper系列加速能力,并推进国产算力适配优化,支撑万卡级集群稳定训练;模型训练与推理服务依托TI-ONE平台实现算力调度。在感知交互与远程操控层面,腾讯云提供实时音视频TRTC、远程实时操控TRRO、视图计算、媒体处理MPS、智能标注、语音交互等能力。由此形成从云底座、模型层、平台层到应用层的一整套“具身智能全栈方案”。
腾讯云把三层底座铺到机器人脚下
具身智能企业对云的需求,正在从“租GPU”转向“全链条托底”。企业负责人李伯勋介绍,他们使用国产开源模型,把机器人能力包装成“大脑”的技能池,从中选择合适的方案调用以完成任务,推理效率相比开源方案提升数倍甚至数十倍。他还表示,2026年能明显感受到具身智能企业对算力的需求比2025年有数倍提升,目前正在与业内合作完善从机器人纳管到训练、部署的全链条。
这一变化背后,是云厂商角色在变。过去云主要提供存储和算力,如今还要介入数据标注、模型训练、远程操控、实时音视频回传和部署运维。腾讯云的三层体系正好对应这一趋势:
- 算力底座层:国产算力适配、异构算力调度、万卡级集群稳定训练;
- 模型服务层:依托TI-ONE平台进行训练与推理调度;
- 感知交互层:TRTC、TRRO、MPS、智能标注、语音交互等能力支撑机器人“感知—决策—执行”闭环。
在广州一处展会现场,人形机器人还能根据订单需求,在等待咖啡制作的间隙再取一份冰淇淋,实现多任务自主排程和并行操作。相关负责人介绍,他们采用“快脑+慢脑”架构,把不同大小、类别的模型根据需要分别部署在机器人端侧和云上。端侧负责实时响应,云上负责复杂推理和持续训练,云脑分工开始走向工程化。
快脑上端、慢脑上云:技能池开始共享
“快脑+慢脑”并不是简单把模型切小。它对应的是具身智能在真实场景中的硬约束:机器人端侧要低延迟、低功耗,云上要强推理、可迭代。把不同模型分别部署在端侧和云上,既保证动作执行速度,也让复杂任务理解与技能进化留在云端。
在北京一家具身智能企业,形态不同的机器人有的用于便利店服务、工业搬运,有的会打网球、跳街舞,但底层接入的是同一套具身模型。基于这一底座搭建的智能体,让机器人训练方式发生变化。企业大模型负责人张直政介绍,过去学习一个技能需要采集高精度的机器人数据,有了智能体,可以直接从人类干活的视频中学习。未来会看到多模态大模型成果逐渐被具身智能公司吸收。
另一家AI企业的双臂机器人则展示了“大脑”接上技能池后的能力:机器人对桌面不同物品进行抓取分拣,即使目标被箱子挡住,也能进行分析,移开箱子后完成抓取。业内人士认为,像GPT-6等最新模型展现出的直接操控机器人能力,对于具身智能行业现有技术路线可以形成互补。
这意味着,机器人不再只靠工程师写死动作,而是通过云端技能池、智能体调度和跨本体复用,逐步形成“一个大脑服务多类机器人”的能力。云端训练、端侧执行、数据回流,开始构成闭环。
鹿明和银河通用把学习闭环搬进作业现场
在作业现场,具身智能的真正分水岭是“越干越强”。鹿明展示的重载轮臂式具身智能机器人MOS2已迭代到第二代。展台侧屏上,机器人的感知数据与任务执行过程同步呈现,直观展示机器人如何从“能动”走向“能干”。MOS2上装有激光雷达、腕部/头部相机、力传感器,真实作业中产生的环境感知、任务理解与操作数据会实时回流至鹿明自研具身大脑NexCore。NexCore以此构建学习闭环,通过自动训练和优化形成新技能,再反馈部署至MOS2。
银河通用则把“大脑”和“小脑”拆开讲、又合着做。6月19日,银河通用发布AstraBrain-WBC 0.5,号称全球首个人形机器人“通用小脑”GPT基础模型,采用GPT式因果Transformer架构,推理延迟压到0.39毫秒,能零样本执行篮球、拳击、舞蹈、翻身起立等高动态动作。大小脑协同、端云分工,正在成为具身智能产品架构的常见选择。
云深处科技则围绕自研具身大脑DEEPRobotics-Brain密集发布五项研究成果:世界模型DR-WM-1.0、具身基础模型DR-VLA-2.0、具身智能体DR-Agent、策略优化框架DR-APO和数据闭环平台DR-Benchmark。五项成果由云深处联合MIT等七所顶尖高校协同研发,覆盖感知—决策—执行—进化闭环,强调系统级协同而非单点突破。其中,DR-Benchmark首次构建具身智能数据闭环评估标准,架构设计以“读懂意图、适配需求、自主迭代”为演进目标。
跨维智能则展示了一个大脑跨三类场景的能力:手机装机流水线质检、商超自主扫码分拣,以及冰淇淋与爆米花连续出餐。手机装机流水线质检任务旁标注着蓝思科技,跨维将真实工业场景复现到展会现场。无界动力与韩国KG集团旗下咖啡品牌HOLLYS联手打造沉浸式机器人咖啡空间,K15在真实顾客进出的开放环境中连续完成饮品端送、桌面清理、垃圾回收、手部消毒、座椅归位等任务,背后依靠自研MWA隐空间世界模型,理解动作与物理变化的因果关系,再用“长时序双向物理因果链”把长程任务拆成连续动作,减少误差累积。
跨本体调度倒逼云+AI全栈重构
当机器人共享“大脑”、具身智能探索“跨本体”调度新模式,云+AI基础设施也面临更彻底的重构。物理AI与数字AI加速融合,势必会在技术、产品、解决方案等维度对整个行业的云+AI基础设施进行一次更加复杂、更加彻底的调整。这种重构不仅体现在业务层面,也会体现在组织层面。
加速进化科技有限公司董事长程昊提出“四肢健全→认知健全”的渐进式技术路径:先提升机器人运动能力,在踢足球、搬箱子等简单场景逐步落地;通过落地过程采集真实场景数据,结合仿真与生成数据训练未来“具身大模型大脑”。他主张技术研发分阶段投入,当前优先夯实硬件基础与场景落地,待数据规模充足、技术范式成熟后再发力认知层,并类比云计算规模效应,强调这是兼顾商业可行性与长期目标的务实策略。
乐聚(深圳)机器人技术有限公司董事长冷晓琨则指出,人形机器人未来发展的核心是从人到机器人的行为数字化知识迁移。随着具身智能出现,机器人正在由过去的纯小脑控制,演进为大脑和小脑深度融合,但行业对大脑的模型架构尚未形成清晰定位,相对于小脑已开始收敛的技术路线,机器人大脑的发展方向还有待进一步探索。
从产业实践看,算力国产化、存储更高效、连通更快捷的趋势不可阻挡;更深层次、更多层级、更多样化、更加复杂、更加高效的AI全栈基础设施和框架互联互通,几乎是确定性方向。机器人要干活,先把大脑搬上云,不只是把模型部署到云端,而是把数据采集、治理、训练、部署、回流和跨本体调度连成一条可持续进化的生产线。谁先把这条生产线跑通,谁就更有机会让机器人从展会现场走进工厂、商店、码头和家庭。
