Kafka已正式接入AI

Apache Kafka凭借广泛的数据连接能力,可对接数据库、云平台、存储系统、各类应用程序等多源异构数据,为AI应用提供丰富多元的训练与推理数据集,有效提升AI模型的准确性与数据多样性。针对欺诈检测、推荐系统、医疗健康监测、动态定价等需要即时获取最新信息的AI场景,Kafka可通过Kafka Streams直接在数据摄入环节完成实时转换、聚合与数据提取,无需单独进行预处理,大幅降低AI应用的预处理延迟。典型适用场景包括:
- 实时反欺诈交易监测
- 个性化内容推荐
- 工业设备健康预警
- 电商动态定价调整
同时其分布式架构可支持每日处理万亿级消息、PB级数据,完全满足AI场景下的海量数据吞吐需求。
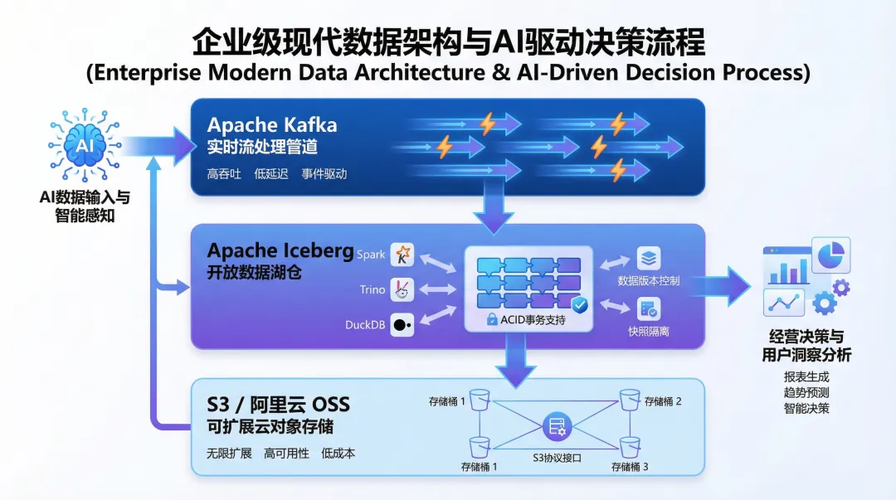
多源实时接入打通AI数据动脉
作为Apache软件基金会维护的开源事件流技术,Kafka凭借持久化事件存储、可扩展数据流、事件可重放、可扩展事件处理等特性,已成为机器学习流水线、实时分析、事件驱动架构的核心底层支撑。其分区日志模型可动态扩展存储与计算能力,在保持高性能的同时灵活应对AI场景下的流量波动,无论是模型训练的大规模数据批量摄入,还是推理阶段的实时数据流处理,都能提供稳定可靠的服务。目前已有大量数据工程师依托Kafka构建将数据流式传输至BigQuery等分析系统的流水线,支撑运营监控、付款处理等AI相关场景的落地。
分布式架构扛住AI高吞吐需求
为适配AI快速迭代的开发需求,Kafka可通过Camel的低代码DSL快速对接数据库、REST API、CSV文件、第三方服务等多种端点,搭配Quarkus可实现极速启动与高内存效率,在Kubernetes环境中运行时可兼顾快速原型开发与可维护性,完美匹配AI快节奏的工作流。此外Kafka具备运行时动态注入新行为的能力,例如可在无需重新部署或修改现有服务的前提下,新增主题消费者组或中间主题,灵活适配AI系统不断调整的业务逻辑。针对企业用户的运维需求,谷歌云、Instaclustr等厂商已推出托管式Kafka服务,用户无需再操心代理扩容、存储管理等运维工作,还可通过Kafka Connect快速完成数据迁移与湖仓一体构建,进一步降低AI落地的技术门槛。
低代码集成降低AI落地门槛
随着AI系统从简单的API调用向多步骤、自主多智能体系统演进,事件驱动协调成为AI系统的核心基础能力,而Kafka正是这一场景下的关键基础设施。它可为多智能体系统、多步工作流、工具编排、混合云通信等复杂场景提供稳定的事件流转支撑,解决传统流处理方案无法满足的动态路由、跨系统互操作性等需求。此外Kafka的可重放特性还可支持AI模型的效果回溯与问题排查,配合服务网格技术可进一步提升AI推理的可观测性与安全性,成为连接AI各环节的隐形技术底座。