Kimi拿走61%,美国企业开源账单近九成给了中国模型

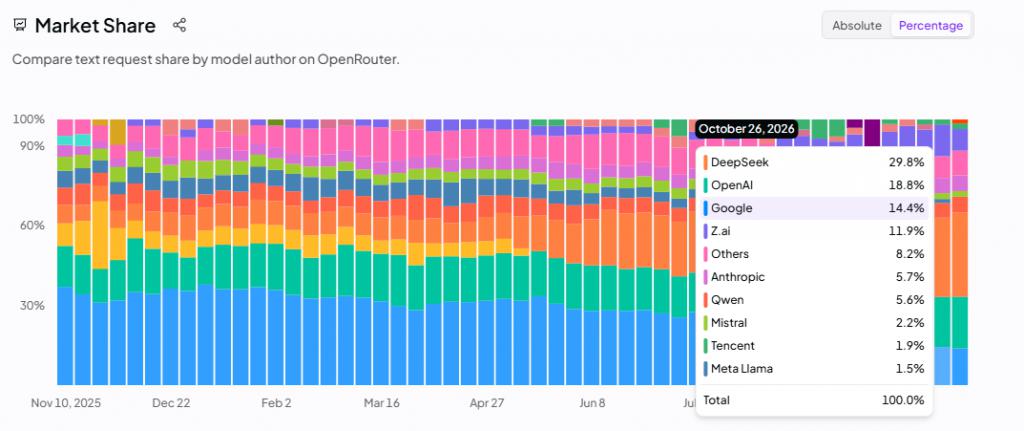
11月3日,硅谷风投门罗风投(Menlo Ventures)发布《2026年企业AI现状报告》,基于对近400名美国企业AI业务负责人的调研,给出一个刺眼的数字:美国企业花在开源大模型上的支出,89%付给了中国模型。门罗风投在报告中直言,“随着中国模型定义了开源前沿,它们占到了开源支出的89%”。
门罗风投把400名美国AI负责人的账单摊开
这份报告的核心数据来自门罗风投委托Morning Consult进行的调查。调查在9月8日至9月26日期间进行,询问了400名美国企业决策者,他们负责的AI支出总额超过40亿美元。报告统计的“企业真金白银支出”维度,直接反映了美国企业在生产环境中为开源模型付费的实际流向。
拆开这份开源账单,中国模型占据了绝对主导:
- 月之暗面的Kimi拿走61%,位居第一;
- DeepSeek占15%;
- 智谱GLM占11%;
- 阿里通义千问占3%;
- 西方模型中份额最高的Meta Llama,仅占7%。
换句话说,美国企业在生产环境里跑开源模型,十次里有九次,底层来自中国。钱流向中国,并不是因为中国模型便宜到白送,而是因为它们把开源这一档的能力上限抬高了。报告特别提到,开放权重模型为开发者提供了闭源模型难以给予的控制权,企业可以在此基础上进行后训练,使模型适配自身业务,以降低成本并减少对头部模型公司的依赖。
与此同时,美国企业AI部署支出的大盘也在膨胀。门罗风投数据显示,2026年美国企业AI部署支出已从去年的330亿美元冲到1768亿美元,一年涨了5.4倍;其中55%的新增预算是净新增,不是从传统软件或人力预算里切过来的。Anthropic、OpenAI与谷歌三家合计吃下69%的企业支出,支出规模为1227亿美元;开源模型所占比例则从11%上升至19%。
六成付给Kimi,DeepSeek在调用端抢回第一
支出榜和调用榜呈现出一种值得注意的反差。在门罗风投统计的企业实际支出维度,Kimi以61%的份额压过DeepSeek的15%;但在全球AI模型聚合平台OpenRouter按实际请求量排的使用榜上,DeepSeek反超Kimi,成为开发者调用最频繁的中国模型。
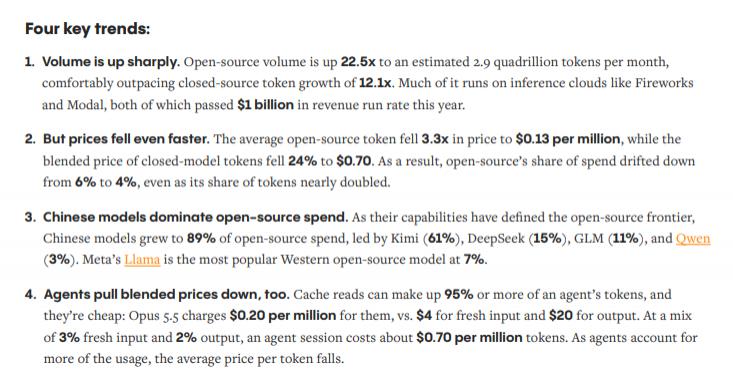
OpenRouter最新一周(10月26日至11月1日)的排行显示:
- DeepSeek以29.8%的文本请求份额排在所有作者第一位,环比上涨7%;
- OpenAI以18.8%退居第二;
- Google份额从14.4%继续下滑;
- Z.ai(智谱)以11.9%排第四;
- 通义千问以5.6%排第六。
这一周,中国大模型的token调用量已经连续第27周超过美国模型;按单模型排,周调用量前五名里中国模型占了四席。支出向Kimi集中,调用向DeepSeek集中,背后是同一批美国企业:它们在为开源模型付钱,也在为中国模型写代码。
报告还揭示了智能体对调用量的推升作用。与传统聊天机器人不同,智能体能够独立执行复杂的多步骤任务,并行处理工作,在较少人工干预的情况下持续运行。在OpenRouter平台上,智能体目前已经贡献了80%的Token使用量,相当于人类用户使用量的约7倍;智能体流量自今年2月超过人类用户以来,已经增长了37倍。AI模型的主要使用者,正逐渐从向AI提问的人,转变为利用AI自主执行任务的机器。
0.13美元的token与2.9千万亿的月用量
开源模型用量暴涨的背后,价格是一股不可忽视的力量。过去一年,开源模型的平均token价格掉了三分之二,从每百万0.45美元降到0.13美元;相比之下,闭源模型的平均价格约为每百万token 0.70美元。价格腰斩的同时,用量却涨了22.5倍,月token量冲到2.9千万亿。
价格下降与调用量暴增同时发生,使得开源模型占平台token总量的19%,却只占企业模型支出的4%。便宜,但用得狠。从使用量来看,2025年9月至2026年9月,开源模型的Token使用量增长了22.5倍,增速明显超过闭源模型的12.1倍。
另一本账则指向更贵的旗舰模型。企业的钱正加速流向更贵的旗舰模型,前沿模型的支出份额由35%升至63%。这意味着,开源模型承担了大量高频调用和成本敏感型任务,而企业仍愿意为前沿闭源模型支付溢价。两件事放在一起,才是美国企业AI账单的真实结构。
不过,开源模型市场仍处于早期阶段。2026年,采用后训练技术的AI开发者比例仅从2025年的6%上升至10%;而在已经开展后训练的开发者中,91%依赖外部合作伙伴。
Cursor、Harvey和Thinking Machines都开始“借刀”
中国模型的影响力并不局限于直接向海外用户提供服务,其开源模型正在成为美国AI企业开发自身产品的底层技术基础。报告特别列举了一个案例:美国AI编程公司Cursor基于中国开源模型,并借助Fireworks提供推理基础设施,支持强化学习过程中的模型调用。
更高端的明星实验室也开始把中国模型放进生产链条。11月5日,Thinking Machines Lab发布新模型Inkling 2 Small。这家公司由OpenAI前CTO Mira Murati出走创办,一轮种子就融了20亿美元,最近一轮谈的估值是400亿美元,是硅谷含金量最高的明星实验室之一。参考资料提到,造模型的Thinking Machines拿Kimi当老师,做应用的Harvey拿Kimi当底座。从实验室到应用层,Kimi都挤进去了。对这些公司来说,开放权重意味着拿到了一把可以自己磨的刀,而不只是一把便宜的刀。
中国模型由此进入了海外头部应用的生产链条——从被调用,到被当作老师、底座。这股势头还在加速。10月23日刚发布的Kimi K3.1 Pro,月之暗面自报的Terminal-Bench 4.0成绩达到65.7%;紧接着11月5日,它登陆了微软Foundry。
微软云收入共享,Kimi把中国开源模型送进两朵云
Kimi登陆微软Foundry,不只是一次普通上架。这是微软云上第一个采用“收入共享”模式的开源权重模型。简单说就是:企业在微软Azure上每调一次Kimi,月之暗面都跟着分钱。而在微软之前,Kimi已经先上了亚马逊AWS。微软、亚马逊,全球最大的两朵云,先后给中国开源模型发了“入场券”。
从支出份额到调用榜单,从Cursor的底层调用到Thinking Machines的“老师”角色,再到微软云的收入共享模式,美国企业的开源账单正在把中国模型推向生产链更深处。门罗风投的数据显示,这笔账还在继续:2026年美国企业AI部署支出冲到1768亿美元,开源模型份额升至19%,而中国模型拿走了开源支出的89%。与此同时,评测机构调整测试体系后,开源与闭源模型的效能差距由3分扩大至12分,外界对开源模型真实能力的讨论仍在继续。但至少从美国企业的付费记录和调用记录看,中国开源模型已经不只是“便宜替代品”,而是被写进了越来越多美国AI公司的成本表和生产流程里。
