开源决策模型Karpo登顶两大榜单反超谷歌

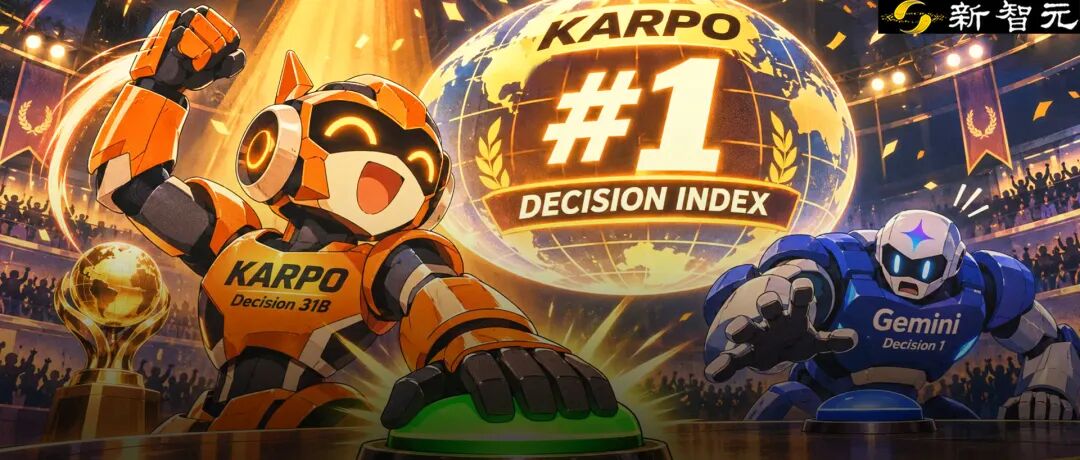
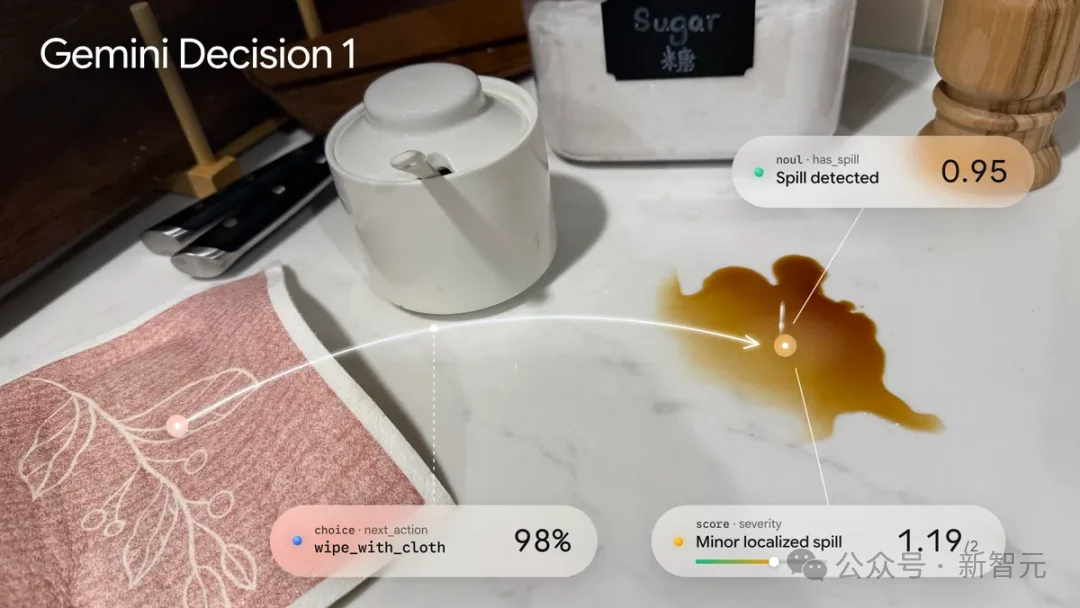
在决策模型这条长期由闭源旗舰把守的赛道上,一匹开源黑马完成了正面超车。MachinePulse推出的Karpo不仅拿下Decision Index总榜第一,还在JevBench断网盲测中交出高能力分与高校准分,把谷歌闭源王牌Gemini Decision 1压在身后。更值得玩味的是,Karpo的后训练底座正是谷歌自家开源的Gemma 4 31B。
73.9分把Jev 1.14甩在身后
Decision Index横跨37项公开基准与未公开私有题库,吸引全球300个模型同台打榜。Karpo在这份总榜上以73.9分一举夺魁,远超初代标杆Jev 1.14的60.2分。
- 总分领先之外,Karpo的中位延迟只有94毫秒,比Jev 1.14的196毫秒快了整整一倍。
- 在细分到陌生领域、知识准确率与安全判断三大维度时,Karpo同样全线胜出,三项得分分别为72.3%、56.0%与93.4%。
- 它还把KnowLine、GLiDE、Sieve等原榜单前三的开源对手悉数甩在身后。
真正拉开差距的是防刷榜的私有题库盲测。公开榜前十名的模型一旦进入同技能私有盲测,成绩平均要暴跌6.8分;唯独Karpo只掉了4.3分,在前十名里抗跌能力最强,到了全新领域私有题上更是拿下78.6分。
断网盲测里的89.53分与96.00校准分
在JevBench刚出炉的1500道题官方断网盲测中,Karpo交出了更惊艳的答卷。这场由榜单维护方独立运行的严苛大考,全程在自有显卡上断网进行,1500道考题中有1200道永久封存。
- Karpo在当期能力分上拿下89.53分。
- 在1200道封存私有题上拿到85.67分,甚至反超了公开题的80.45分。
- 校准分飙到96.00分,折算到榜单统一标尺后,在261个开源模型中,Karpo以87.2分的折算能力分杀入全球前三。
与同场参测的谷歌相比,Karpo的综合总分77.4、决策智力80.2与校准度94.1三项核心指标全部占优。这意味着它不仅“选得准”,还能较为诚实地报告自己的把握程度。
每千次决策仅0.025美元的成本账本
决策模型要真正进入生产环境,不能只看榜单分数,还要看每次判断的算力开销。Karpo每千次决策成本仅需0.025美元,相当于做4万次判断才花1美元。
支撑这一成本表现的是MachinePulse在训练配方上的组合拳:
- 将早期权重与后期权重结合。早期权重泛化好、后期权重更专精,恰好与LoRA“学得少、忘得也少”的特性形成互补。
- 五个权重合二为一后,推理开销依然维持单模型的1倍,但陌生领域准确率比单模型终点反超1.6个百分点。
- 引入校准决策强化学习,激励模型如实评估自身把握度,把JevBench上的校准误差压到0.023。
在涵盖临床医学、法院裁判等10个大类、283个小类的陌生领域评测中,Karpo直接对Jev 1.14打出10比0的全面零封。遇到信息缺失的是非题盲测时,它也能对92.0%的题目果断拍板,并在剩下8.0%拿不准时主动弃权,安全交由人类兜底。
31B旗舰带出五个同阶第一梯队
31B旗舰登顶的同时,MachinePulse还把同一套训练配方搬到了0.8B至12B五个中小尺寸上。无论是端侧轻量模型还是单卡主力,每个参数量级都杀入了同阶第一梯队。
这套全尺寸开源矩阵的意义在于,开发者不必只盯着一个榜单冠军做演示,而是可以按场景选择不同参数规模:
- 端侧场景可以选用0.8B级轻量模型,降低部署门槛。
- 单卡环境可以用12B级模型承担主力判断任务。
- 对性能要求更高的场景则交给31B旗舰。
靠着极速判断机制,Karpo开源即登顶总榜第一,并在多项评测中正面击败谷歌闭源王牌Gemini Decision 1。一个由谷歌开源底座后训练出来的模型,反过来在决策能力上超越谷歌闭源旗舰,这层戏剧性也让Karpo的登顶更具标志意义。
中国开源模型的全球下载量已反超美国
Karpo的突围并非孤立事件。过去一年,全球人工智能领域掀起“中国热”,以中国大模型为代表的新兴力量凭借持续开源开放与垂直场景应用优势,正在改变与OpenAI、Anthropic等闭源巨头对战的节奏。
美国麻省理工学院与开源平台“抱抱脸”的联合报告显示,过去一年,中国研发的开源模型全球下载量占比达到17.1%,反超美国的15.8%,位居全球第一。从DeepSeek R1确立开源推理模型的高标准,到通义千问覆盖不同规模与场景,再到GLM-4.5、Kimi K2与GLM-4.7在智能体、长上下文和复杂推理上连续突破,开源模型的能力边界被不断推高。
在这一背景下,Karpo以“决策新王”的姿态拿下全球榜首,并把31B旗舰与0.8B至12B全尺寸模型一并开源,等于把决策模型的高地从闭源实验室搬到了开发者手中。榜单分数、私有题库抗跌能力、校准度与推理成本同时占优,说明开源模型的竞争已经从“追平参数”进入“拼决策质量与部署效率”的新阶段。
