李飞飞的Atlas,为具身智能推开新世界大门

维特根斯坦曾在《逻辑哲学论》中写下「世界即所发生的一切」,一个世纪后,AI领军人物李飞飞正用新一代世界模型Atlas,让AI真正理解人类所处的三维物理空间。这款由World Labs从零预训练的全模态模型,原生支持文本、图像、视频与3D数据联合建模,官方将其称为「全球首个」能同时处理四类数据的多模态世界模型,能力覆盖世界生成、空间重建、物理模拟等多个核心场景,李飞飞本人将其视为World Labs的里程碑式成果。
几张普通照片就能造世界,Atlas重建3D场景能力惊艳
过去两年,视频生成模型的镜头控制始终依赖提示词碰运气,画面走向与镜头轨迹难以精准把控,传统3D重建更依赖多角度、高覆盖率的密集拍摄,对设备、时间与人力成本要求极高,始终难以规模化落地。
Atlas彻底改变了这一范式。它将相机位姿参数作为原生输入,每张送入模型的图像都会被锚定在三维空间的具体坐标上,携带姿态与深度信息,相当于模型手中拿的不是一叠孤立照片,而是一张带坐标的世界草图,用户可像导演一样精准调度镜头轨迹。
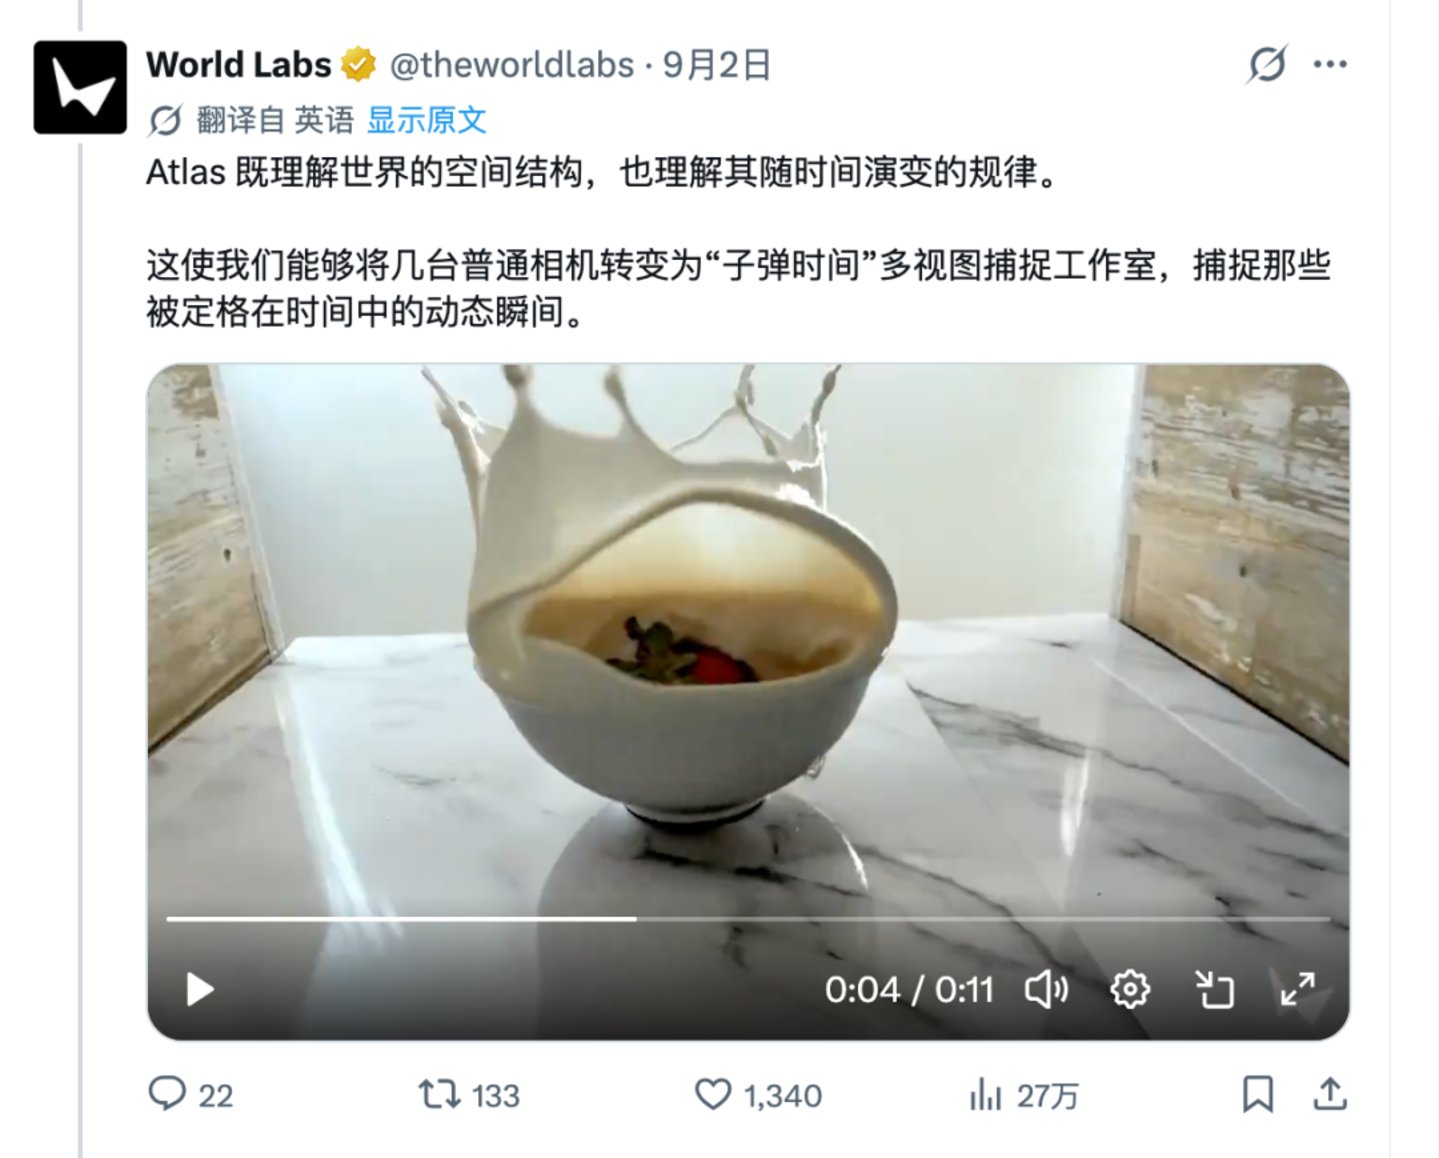
官方演示中最出圈的案例显示,仅需3到5台普通手机拍摄同一瞬间的画面,Atlas就能冻结时间、还原牛奶溅起的全过程,用户可自由选择任意角度观看;此前需要上百台相机围拍绿幕才能实现的《黑客帝国》子弹时间效果,如今几台手机就能大致复刻。
3D重建能力同样突破行业瓶颈:传统三维重建需要围绕场景拍摄数百张照片覆盖所有角落,而Atlas仅需2到25张地面随手拍的游客照,就能高保真重建出斯坦福主方庭的完整场景;输入图像越少,模型会调用先验知识「脑补」不可见区域,输入图像越多,重建结果越接近真实场景,性能优于现有专用3D重建模型。
Atlas四大核心能力覆盖多元需求
- 可控运镜:支持像素级相机控制,1到6张参考图即可生成最长1分钟、1440p分辨率的视频,可精准指定镜头位置、角度与轨迹,画面与原始图像保持高度一致
- 空间重建:支持1张到上百张图像输入,兼顾快速概念生成与高精度场景还原,输出可包含新视角图像、深度图与点云
- 时空模拟:可同时理解空间结构与时间变化,支持任意视角的时间定格与画面重构,为机器人模拟训练提供动态交互环境
- 图像生成:支持文本生成高清图片与360°全景图,可遵循复杂提示、精准呈现文字内容,覆盖写实到插画等多种视觉风格
官方在公开博客与访谈中明确,目前Atlas已实现几何层面的「空间上下文」理解,而物理规律的理解是团队的长远目标,二者并非同一阶段的能力,外界无需将两者混为一谈。值得一提的是,Atlas从设计之初就为Scaling做好了准备,李飞飞团队表示已看到明确证据,证明模型能力会随规模扩大持续提升。目前Atlas尚未全面对外开放,仅向部分合作伙伴开放早期访问权限,用户可在官网提交申请,未来也将作为World Labs旗下Marble等产品的底层模型。
打通Real-to-Sim路径,给具身智能训练解了成本难题
传统AI生成模型主要服务于影视、游戏等创意产业,核心目标是生成「看起来逼真」的静态内容,而Atlas通过构建可交互、可推演的「世界模拟器」,将AI生成能力拓展至机器人领域,直击具身智能的核心痛点。
当前具身智能发展的最大瓶颈,是真实世界的训练数据匮乏、采集成本高昂,机器人需要在真实环境中进行海量试错才能掌握动作策略,既耗时又存在损坏风险。Atlas打通了「真实照片/视频→