

LLMFly AI是什么
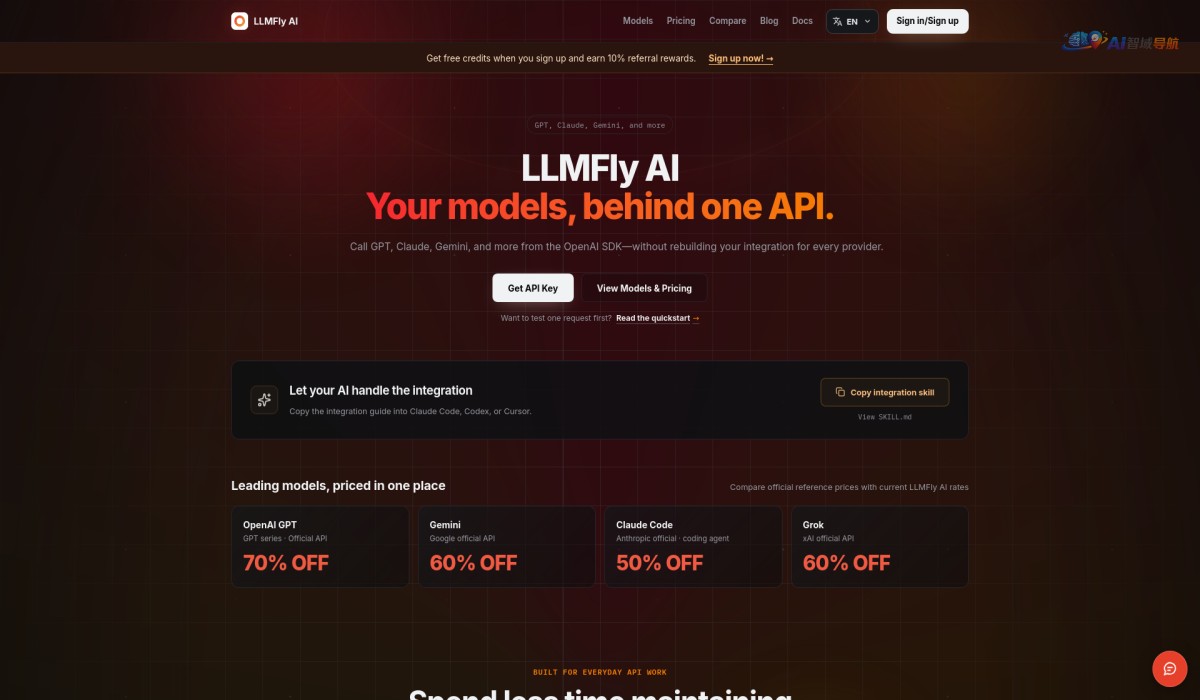
LLMFly AI 致力于消除多模型调用的复杂性,为开发者和企业提供一个端到端的API网关。它封装了不同厂商的认证、速率限制和响应格式差异,用户只需使用一套标准化接口,即可按需切换或组合GPT-4、Claude 3、Gemini Pro以及Grok等模型。平台内置自动重试、负载均衡和Failover机制,确保高可用性,同时支持流式输出、Token计量和费用透明化,让AI能力集成像调用普通HTTP服务一样简单。
核心功能
-
多模型统一接入
一个API Key覆盖主流大语言模型,无需分别注册和付费,降低管理成本。 -
智能路由与容灾
根据模型可用性、延迟和价格,自动选择最优端点;当某个模型不可用时,无缝切换至备用模型。 -
请求与响应转换
自动将用户请求适配为目标模型的原生格式,并将响应统一为标准的JSON结构,方便下游解析。 -
用量监控与限流
提供可视化仪表板,实时查看各模型的调用次数、Token消耗和费用;支持设置每用户/每API Key的速率限制。
使用流程
-
注册并获取API Key
在控制台创建项目后生成专属密钥,用于后续所有请求身份验证。 -
选择目标模型
在请求参数中指定模型名称(如gpt-4、claude-3-opus),或使用别名配置自动选择策略。 -
发送标准化请求
调用统一端点,传入messages数组、temperature等通用参数,LLMFly AI自动完成模型适配。 -
处理响应结果
接收统一格式的JSON回复,包含content、finish_reason和usage字段,可直接集成到应用逻辑。
适用场景
| 场景 | 说明 |
|---|---|
| 多模型对比测试 | 快速切换不同模型输出同一Prompt,评估效果差异 |
| 降级与成本优化 | 高优先级任务使用强模型,常规任务自动分配到廉价模型 |
| 全球化应用 | 利用各模型在不同地区的低延迟节点,提升用户体验 |
| 企业级集成 | 通过单一账单和权限管理,简化内部AI能力调用规范 |