Meta新研究:字节模型蒸馏后,天花板破了

大模型蒸馏技术迎来新的突破路径。传统蒸馏方案普遍让学生模型学习教师模型在超大Token词表上的概率分布,但面对动辄十余万Token的庞大词表,完整保存概率分布的存储成本极高,行业通常采用Top-K截断的方式保留高概率候选,反而损失了部分分布信息,限制了学生模型的能力上限。
Meta团队另辟蹊径推出字节级蒸馏方案
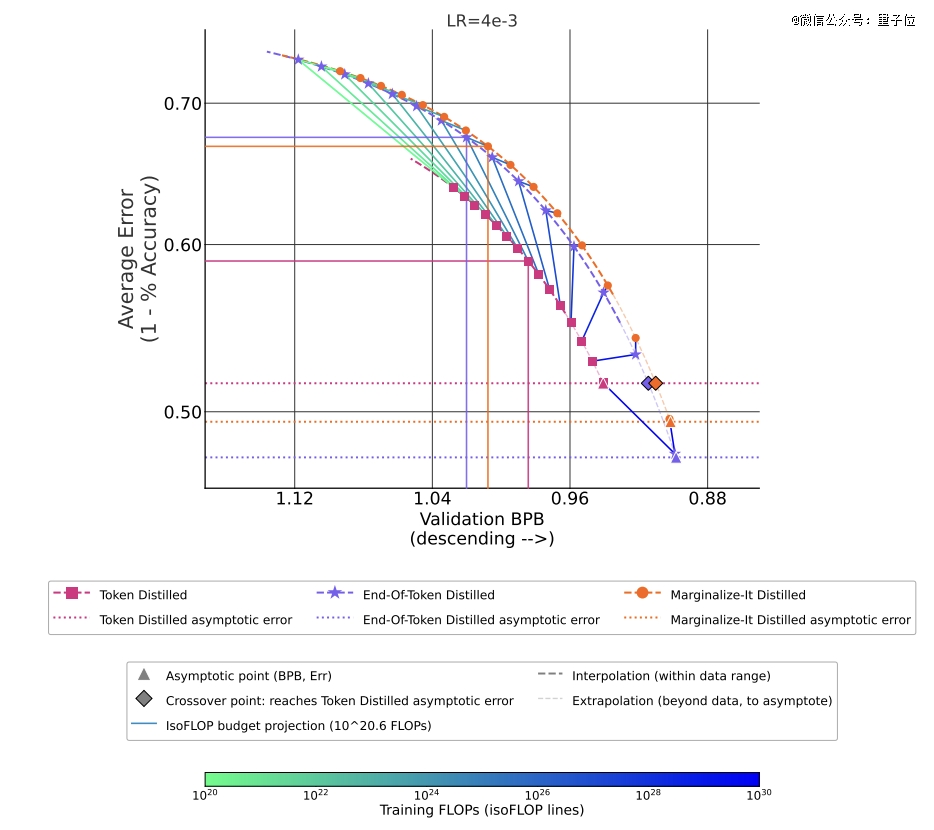
针对这一痛点,Meta FAIR联合华盛顿大学团队在最新论文中提出字节级蒸馏方案,将学习的基本单位从Token换成字节。字节仅由8个比特组成,共有256种基础取值,单个位置的预测空间仅两百余种,远小于Token词表的十几万候选,完整保存概率分布的存储成本极低。团队设计了两种具体实现方案:Marginalize-It和End-Of-Token,核心逻辑都是将教师模型对不同Token的概率分布逐步分解到对应字节位置上,其中End-Of-Token方案额外为每个Token添加结束标记,能更完整地保留教师分布的概率信息。
字节蒸馏性能上限较传统方案高4个百分点
研究团队没有直接采用每字节预测损失(BPB)作为模型能力判断标准——BPB仅衡量模型对文本的预测准确率,与下游任务的实际表现并不完全对应,于是团队拟合了“训练计算量-BPB-下游任务成绩”的缩放曲线,预测不同方案持续Scaling后的能力上限。测试结果显示,三种蒸馏方案的预测平均准确率上限分别为:Token蒸馏48.4%、Marginalize-It蒸馏50.5%、End-Of-Token蒸馏52.4%,End-Of-Token较传统Token蒸馏高出4个百分点,是所有测试方案中能力上限最高的。此外普通字节监督模型的渐近准确率预测为51.2%,高于Marginalize-It的50.5%,论文指出这正是因为Marginalize-It为节省计算丢掉了部分Token结束后的概率信息,而完整保留教师分布的End-Of-Token同时超过了监督训练版本和其他所有蒸馏方案。从Scaling趋势来看,Token模型前期训练速度更快但很快进入平台期,字节模型起步更慢但随计算量增加持续改善,具备更强的Scaling潜力。
存储压力大幅降低但计算成本有所上升
存储层面,字节级蒸馏的优势十分明显:按照论文预测的计算预算,End-Of-Token处理的实际文本量仅为Token方案的六分之一;在Token仅保存Top-600概率、字节保存完整分布的设置下,存储量仅为Token方案的五分之一,显著降低了数据和教师分布的存储压力。但计算层面存在一定权衡:由于End-Of-Token在每个Token后增加了概率转换步骤,处理相同文本量时,训练计算量比普通字节模型高约30.94%;按照Scaling曲线推算,End-Of-Token需要达到约6.33×10²² FLOPs的训练计算量时,才能追平Token蒸馏48.4%的预测上限。
小学习单位撬动更高能力上限
传统蒸馏的逻辑是让学生模型模仿教师对超大Token词表的概率判断,而字节级蒸馏将学习的基本单位拆得更小,预测空间从十几万缩小到数百种,反而能更完整地吸收教师模型的能力,突破传统Token蒸馏的性能天花板,为资源受限场景下的小模型训练提供了新的技术方向。
Meta同步收紧内部竞品AI工具使用规范
在推出技术突破的同时,Meta近期也收紧了内部AI工具使用规范,限制Applied AI部门及直接参与AI模型研发的工程师使用Anthropic的Claude Code、OpenAI的Codex等竞品AI开发工具。Meta表示,此举是为了避免竞争对手模型的输出内容被直接或间接纳入内部AI开发流程,防止Llama模型通过非刻意蒸馏吸收竞品能力,同时降低内部代码、产品设计等商业机密通过第三方工具泄露的风险。分析人士指出,这反映出当前AI大厂已将模型输出、训练数据与开发流程视为核心竞争资产,后续行业对内部AI工具的使用规范预计将更加严格。