美股一夜血洗2.8万亿,硅谷顶级VC曝光:开源模型支出九成流向中国

隔夜美股遭遇史诗级抛售。媒体估算,美股一天蒸发约2.8万亿美元;另有报道称,标普500在40分钟内市值蒸发约2.5万亿美元。市场情绪并不只被选举变量牵动,更深层的导火索,是对天量AI资本开支“到底能不能回本”的怀疑集中爆发。Anthropic传出债务与估值压力、美国拟限制“超级智能”研发等消息,也让AI交易的风险溢价被重新定价。
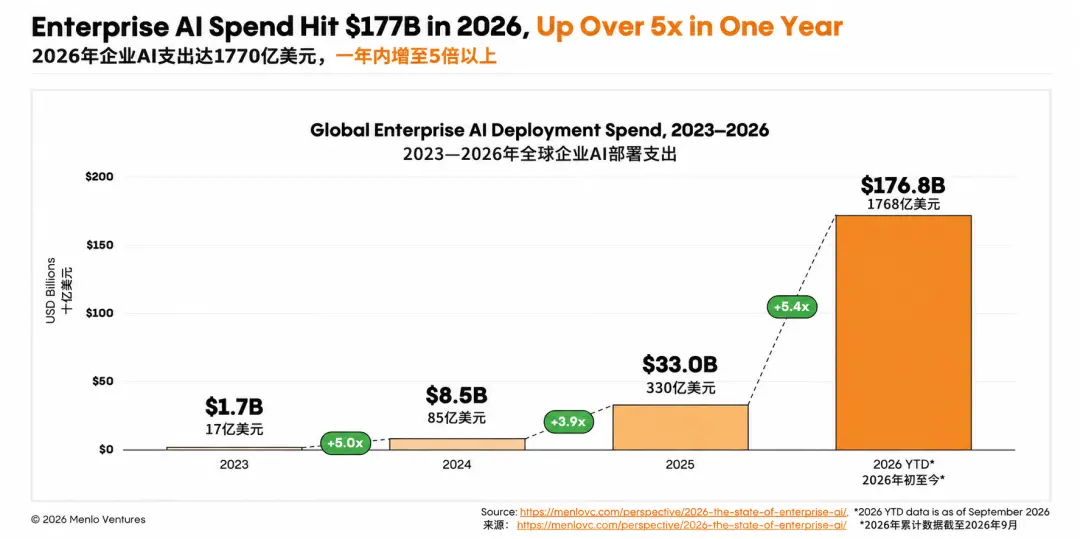
但就在两天前,11月3日,硅谷50年老牌风投Menlo Ventures发布了《2026年企业AI现状报告》。这家Anthropic的早期投资人,给出了与股市完全相反的曲线:企业AI部署支出从330亿美元飙到1770亿美元,一年暴涨5.4倍;三年前这个盘子才17亿美元,三年涨了100倍。华尔街在怀疑供给侧的资本开支,需求侧的CTO们却在加单加到预算失控。
标普500四十分钟少掉2.5万亿美元
美股这一夜的抛售,带有明显的“AI交易挤泡沫”色彩。40分钟内标普500市值蒸发约2.5万亿美元,媒体估算全日蒸发约2.8万亿美元,速度快、范围广,科技股和AI相关资产首当其冲。
消息面上,市场同时消化多重压力:
- Anthropic传出8950亿美元债务黑洞、估值预期大幅下修,随后又有估值暴跌至5000亿美元的说法;
- 美国拟永久禁止“超级智能”研发,违者最高可判20年;
- 民主党重掌国会后,财政扩张受限、AI监管与地缘风险被重新定价;
- 美元走弱、10年期美债收益率两日累计下行逾12个基点,国际油价先大跌后反弹。
这些变量叠加在一起,让“AI资本开支能否回本”从财报电话会里的远期问题,变成了交易盘面上的即时问题。可几乎同一时间,企业端的AI预算却在加速释放。
Menlo把企业AI支出账本翻到1770亿美元
Menlo Ventures这份报告最刺眼的地方,是需求侧和供给侧走出了两条相反的线。2026年企业AI部署支出从330亿美元升至1770亿美元,一年5.4倍;三年前仅17亿美元,三年100倍。
这不是实验室里的试点预算,而是企业生产环境里的真金白银。报告还给出两条更耐人寻味的线索:
- 中国模型拿下了企业开源模型支出的89%,其中Kimi占61%;
- 企业的钱正加速流向更贵的旗舰模型,前沿模型支出份额由35%升至63%。
把这两件事放在一起看,才能理解美国企业AI账单的真实结构:底层开源模型大规模采用中国产品,高价值、高单价的旗舰模型预算则继续流向少数美国头部厂商。
开源模型账单里中国军团拿下89%
在企业开源模型支出中,中国模型以压倒性优势盘踞前四:
- Kimi:61%
- DeepSeek:15%
- GLM:11%
- Qwen:3%
- 合计:89%
Meta的Llama是西方世界最拿得出手的开源选手,但只拿到7%。换句话说,美国企业在生产环境里跑开源模型,十次里有九次,底层来自中国。
更关键的变化是,中国模型已经不只是“便宜替代品”。它开始往别人的产品里“长”进去。11月5日,Thinking Machines Lab发布新模型Inkling 2 Small。这家公司由OpenAI前CTO Mira Murati出走创办,一轮种子就融了20亿美元,最近一轮谈的估值是400亿美元,是硅谷含金量最高的明星实验室之一。
模型本身也不含糊:5940亿总参数、170亿激活的MoE,Artificial Analysis智能指数拿到31分。但真正值得注意的细节藏在技术博客里:预训练走到后半段,喂给模型的数据大部分不是从网上扒的,而是让几个更早的模型先跑一遍生成的。点名的第一个,就是月之暗面的Kimi K3。
这意味着,中国开源模型不仅出现在美国企业的推理账单上,还开始进入下一代模型的预训练数据管线。它从“被调用”走向“被嵌入”,从成本项变成了生产工具的一部分。
越贵的旗舰模型越抢手,Anthropic与OpenAI分走86%
报告里最反直觉的发现,是企业一边大量采用中国开源模型,一边把更多预算砸向更贵的旗舰模型。前沿旗舰模型的支出份额从35%飙到63%,token份额从18%翻倍到42%。
价格并没有挡住采购。去年企业的主流选择是Claude Sonnet 4.5(每百万输入token 3美元)和GPT-5(1.25美元);今年换成了Claude Opus 5.5(4美元)和GPT-6 Astra(10美元)。价格翻了几倍,用户不仅没跑,反而蜂拥而至。
钱流到了谁手里?
- Anthropic从40%涨到55%;
- OpenAI从27%涨到31%;
- 两家合计吃掉86%的企业LLM API支出;
- Google从21%掉到9%,明显掉队。
而Kimi K3、DeepSeek V4、GLM-5.3这些性能已经逼近旗舰的选手,合起来不到5%。能力到了,但企业还没敢把命根子交过去。价格战的结果也很直接:干的活多了一倍,收的钱反而少了,增量全被降价吃掉了。开源Flash模型们赢了吆喝,旗舰模型赢了钱包。
Inkling 2 Small把Kimi K3写进预训练数据管线
如果说89%的开源支出份额说明中国模型已经“霸榜”美国企业账本,那么Inkling 2 Small的技术博客则说明另一件事:中国模型正在成为美国前沿实验室的“数据来源”。
Thinking Machines Lab的明星光环、20亿美元种子轮、400亿美元估值谈判,都让这个细节更具象征意义。一个由OpenAI前CTO创办的顶级实验室,在5940亿参数MoE模型的预训练后半段,让更早的模型生成大部分数据,并第一个点名Kimi K3。
这与报告里的另一组数字形成呼应:企业预算不认开源闭源,只认谁能干活。开源阵营里,够得上旗舰的选手一只手数得过来;中国模型拿走了开源支出的大头,却还没有拿走旗舰模型的高价值预算。美国企业正在用中国模型降本、提效、做数据,同时把最贵的生产调用继续交给Anthropic和OpenAI。
于是一个割裂的画面同时成立:一边是美股一夜蒸发约2.8万亿美元,市场对AI资本开支回本充满怀疑;另一边是企业AI支出一年暴涨5.4倍,开源账单近九成流向中国模型。华尔街在给AI交易挤水分,硅谷的CTO们却在把中国开源模型写进预算表、产品链,甚至下一代模型的预训练管线里。
