面试官:Agent 批量处理任务时 CPU 和内存瞬间打满,如何定位和解决?

Arthas在线诊断:10分钟定位资源打满根因
遇到Agent批量处理任务时CPU、内存瞬时飙高的问题,优先使用Arthas这类在线诊断工具排查瓶颈:先执行dashboard命令查看TOP N线程的CPU占用分布,再通过thread命令导出高负载线程的完整堆栈信息,快速定位是模型推理阻塞、任务调度死循环还是异常IO调用导致的资源占用。同时可参考云原生Agent的常规资源阈值规则,比如正常场景下Agent CPU占用应控制在1vCPU的20%以内,若超过25%会触发自动重启机制,超过20%会自动降频,结合监控指标可快速判断负载是否超出正常范围。
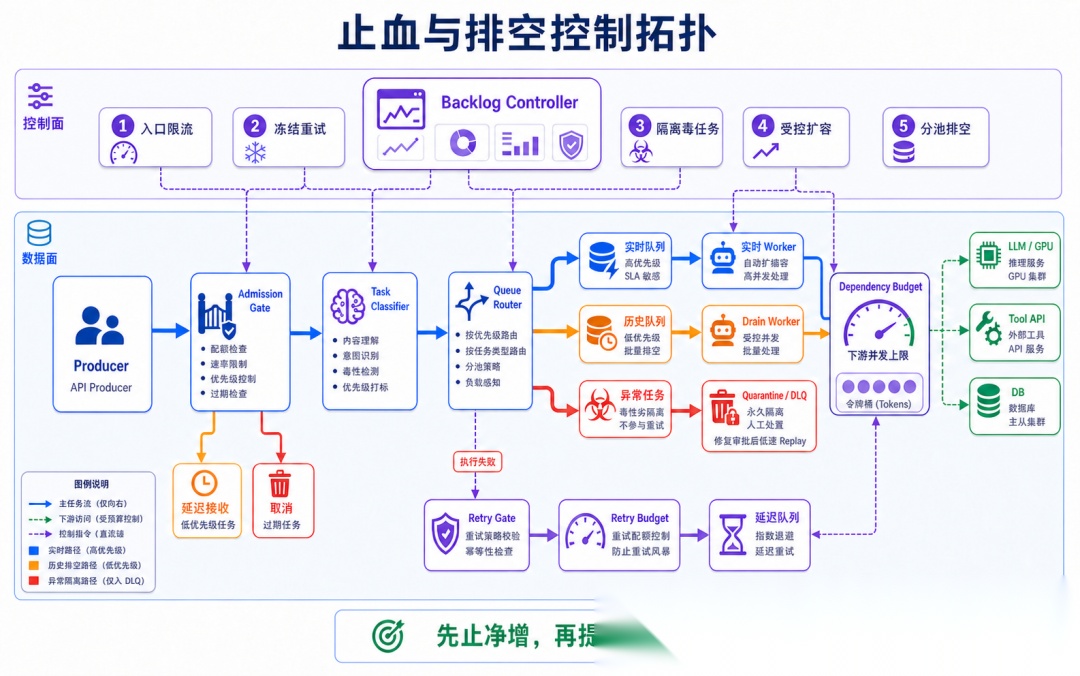
三级自动降级:5倍突发流量下核心业务不崩溃
针对批量任务的突发流量冲击,可部署分级降级策略兜底核心功能:当QPS超过预设阈值的80%时触发L1降级,关闭推荐、个性化等非核心功能释放资源;若LLM API错误率超过10%则触发L2降级,复杂查询统一走快速轻量模型降低计算负载;一旦系统CPU超过90%或内存超过85%,立即触发L3降级,仅返回缓存内容和FAQ回答,完全不调用大模型。实测该方案可在5倍突发流量下保障核心功能可用,降级响应延迟低于200ms,实现零系统崩溃事故。
端侧优化:流式渲染+虚拟滚动降低40%内存占用
部分资源打满问题来自前端渲染和内存管理不当,可从端侧优化降低消耗:流式输出场景下不要每收到一个token就更新DOM,可累积50ms的token后批量更新,结合requestAnimationFrame控制渲染频率,同时采用Markdown渐进式渲染,仅渲染已接收的内容不等待完整文本;长对话列表场景下采用虚拟滚动技术,仅渲染可视区域内的消息气泡,历史消息按需分页加载,避免一次性渲染大量节点占用内存;此外及时清理闲置的EventSource连接,使用WeakRef管理消息对象引用,可让页面内存占用降低40%,流式输出帧率从30FPS提升到60FPS,100轮以上对话列表滚动依然流畅。
运行时管控:资源阈值+熔断机制避免故障蔓延
从运行时层面设置规则可避免小问题演变为大故障:明确Agent资源占用上限,常规场景下内存占用不超过500MB,执行病毒查杀等重任务时控制在800MB以内,若超过最大内存限制会在5分钟内自动重启;针对冷启动问题,可提前预加载模型、预热缓存和连接池,减少新实例扩容时的资源瞬时飙升。同时配置服务熔断机制,下游服务故障时直接返回缓存结果或切换备用模型,避免长时间超时等待占用资源,还可返回“系统繁忙,请稍后重试”等兜底话术,实测可将故障响应时间从30秒降低到100毫秒,下游服务恢复后30秒内自动恢复正常