OpenAI研究员日均调用智能体5.7个工作日

一天两万多美元的API账单,在OpenAI内部并不是什么异常开销。如果你对API价格有概念,就会知道这背后代表着何等庞大的代码生成量、逻辑推演和并发任务执行。这不是人类在敲键盘,而是成百上千个“硅基大脑”在不知疲倦地全速运转。
为了更直观地衡量这种消耗,OpenAI引入了一个新概念:“智能体工作日”,即每8小时的智能体使用折算为一个工作日。数据显示,每位研究员每天平均的“智能体工作日”已经从最初的0.5个飙升到5.7个,足足增长了11倍。在最核心的预训练和后训练团队,这个数字更是达到8个——意味着一名人 类研究员每天工作8小时,他的“AI分身们”在同一时间里并发完成了相当于64个小时的工作量。
到了10月中旬,超过十分之一的研究员每天手头至少有16个智能体在同时处理任务。8月中旬,研究员每天的推理消耗中位数按API价格计算超过600美元,重度用户则超过7000美元。人类工程师对这些AI工具的依赖,已经到了近乎“成瘾”的地步。
裁掉四成人手也要换回智能体
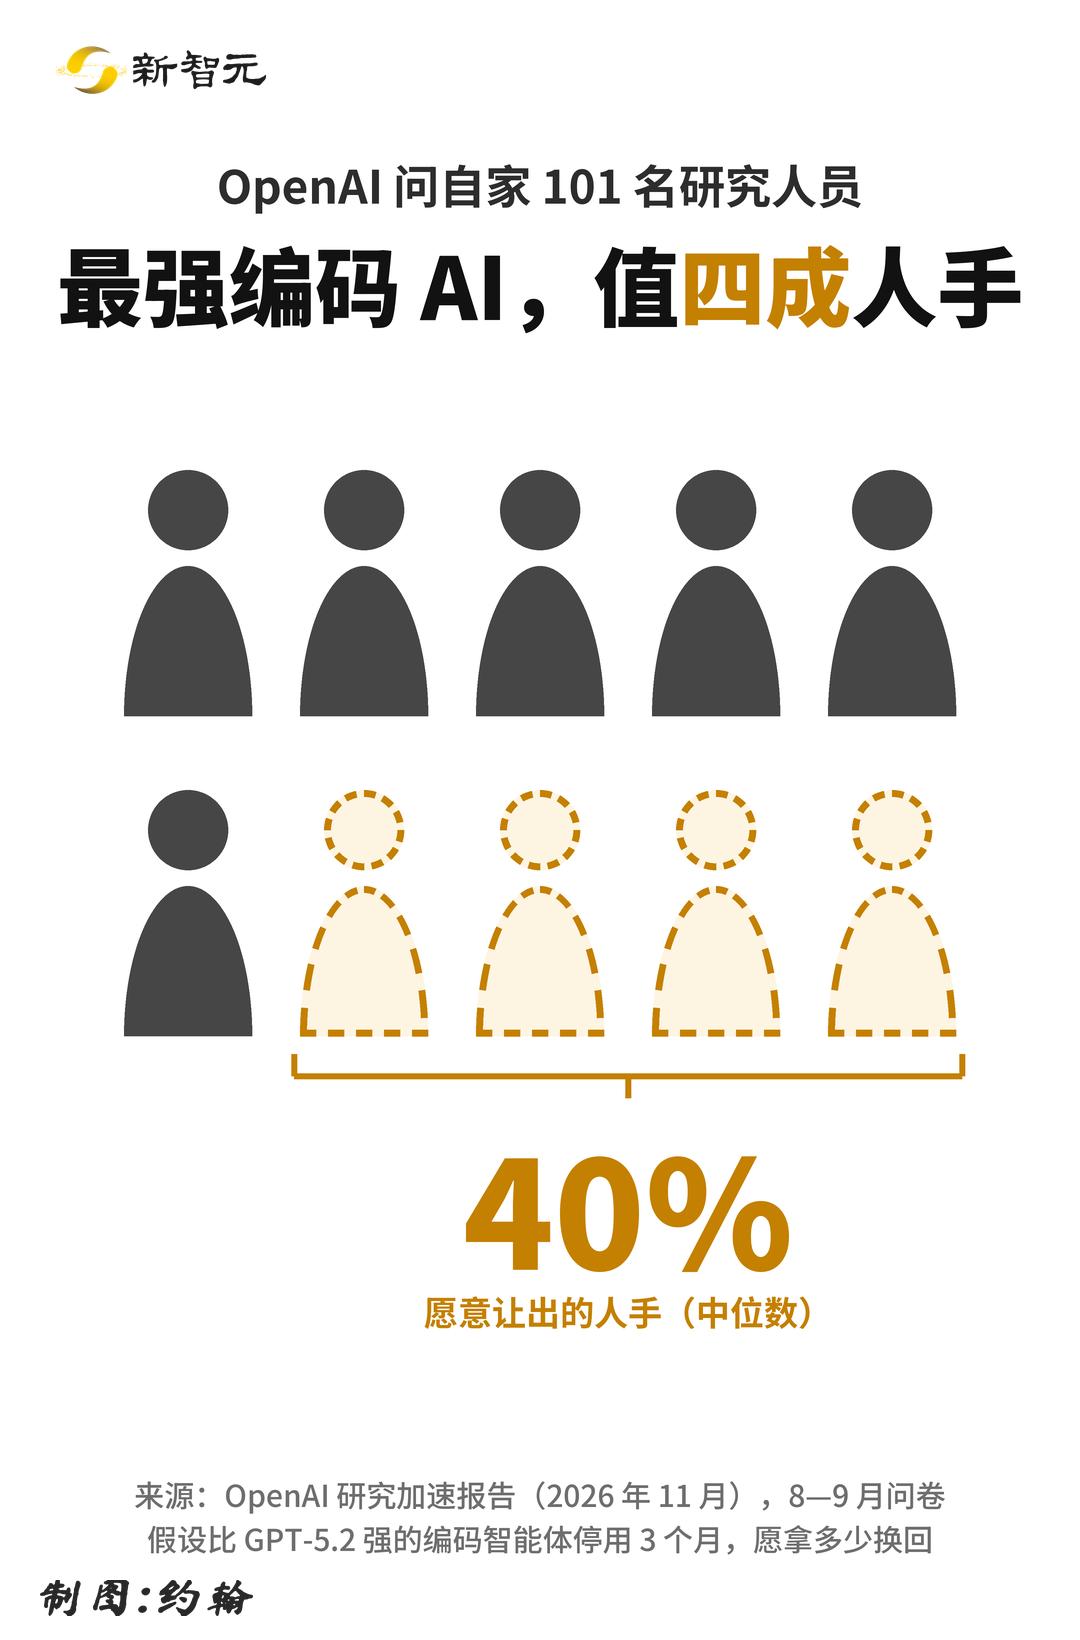
在OpenAI内部进行的一项匿名调查中,研究员们被问到一个极其尖锐的问题:“如果未来3个月内,没收你们所有优于GPT-5.2的编码智能体,你愿意拿什么条件来换回它们?”
中位数的回答让人震撼:他们宁愿裁掉团队40%的人手,或者削减当前团队30%的核心算力。
这种依赖并非盲目。一位研究员描述了自己策略的转变:“我以前试过直接对AI说‘你就把这个任务做成那个任务那样’,结果被坑了太多次,因为它总会理解偏差,我还得去给它擦屁股。现在的策略变了,我说:‘你先做一个,我来审、我来改。等我确认对了,你再去做剩下的一万个。’”
人类的角色由此从“创作者”变成了“审核员”。人类提供最初始的判断力和容错底线,AI负责将这个底线放大一万倍。但这种平衡极其脆弱。就像一位研究员在报告中留下的那句话:“我确实认为,我现在在科研想法上比AI更有品味。但我完全没有信心,这种情况还能在多长的时间内继续成立。”
从Karpathy的玩笑到实验室的报表
Andrej Karpathy曾写过一个半开玩笑的故事:研究已经完全交给在巨型算力集群上奔跑的智能体群,据智能体们自己说,代码库已经迭代到了第10205代,没有人能判断这是真是假,因为“代码”早已变成一个超出人类理解的自修改二进制文件。这个玩笑,在2026年正被一点点写进各家实验室的内部报表。
OpenAI在2月发布GPT-5.3-Codex时就曾写道,这个模型的早期版本“在创造自身的过程中发挥了关键作用”,参与了调试训练、管理部署和诊断评测失败。这被视为前沿实验室第一次明确承认,模型实质性地参与了构建自己继任者的工程回路。2025年10月,Sam Altman给OpenAI定下两个公开时间点:2026年9月实现“实习生级”AI研究助理,2028年3月实现“真正的AI研究员”。9月6日,OpenAI发文宣布第一个目标已经达成。
同一时期,Anthropic发布长文《When AI Builds Itself》,披露截至2026年5月,公司超过80%的合并代码已由Claude编写,工程师日常代码产出飙升8倍;Claude已经“主导”公司26%的研发工作。国内厂商则走出了更偏工程的路线:MiniMax发布M2.7时称其为“首个深度参与自身进化的模型”,在“分析失败轨迹、规划改动、修改脚手架代码、运行评测、对比结果、决定保留或回退”的循环中跑了超过100轮,内部评测集效果提升30%,在强化学习研发工作流中能胜任30%到50%的环节。9月17日,智谱创始人兼首席科学家唐杰在X上发布长文,披露了智谱在RSI方向的首个工程化实践。
一个典型的反馈循环正在成形:研究员想让模型在逻辑推理上更强,于是召唤几十个智能体编写底层代码、配置环境、运行海量实验,测试出哪几行改动真正有效;被证明成功的改动被打包塞进下一个版本;下一个版本因此更聪明,于是能帮助研究员解决上一个版本根本看不懂的更难Bug。每一个更好的AI,都在以前所未有的速度帮助人类构建下一个更强的AI。
一半任务仍需人类拍板,认知天花板正在压下来
当然,如果现在就宣布AI已经完全自主,未免过于耸人听闻。OpenAI在同一份报告中承认:在成功完成的4到8小时任务中,超过一半仍然需要至少一次人类干预。
传统依赖人类监督的训练范式也正逐渐面临瓶颈。高质量人工标注极其昂贵,专家反馈难以规模化;更致命的是,随着模型能力指数级攀升,在高等数学、复杂代码生成和前沿科研推理等任务中,人类的认知边界反而成了限制模型进化的天花板。来自纽约州立大学石溪分校Zesearch NLP Lab的研究者在一篇113页、涵盖500余篇前沿文献的综述中,系统梳理了自我提升系统的六大挑战:数据自噬、反馈信号缺陷、优化驱动失败、无效自我精炼、评估瓶颈和监督瓶颈。
换句话说,“闭环”已经形成,但人类依然是这个闭环中不可省略的一环。问题在于,这一环还能保留多久。发现问题往往比解决问题更难,当AI具备了鉴别“什么样的数据更好”“什么样的架构更有前途”的品味时,潘多拉的魔盒就真正打开了。
OpenAI呼吁强制公开RSI指标
在报告最后,OpenAI罕见地发出了一项极具压迫感的行业呼吁:强制公开RSI指标。他们认为,所有顶尖AI实验室都应当被要求追踪并公开报告“递归自我提升”的核心指标,公众和监管机构有权知道,AI加速未来AI系统开发的过程究竟走到了哪一步。
理由很直接:进步的速度已经超出传统直觉的感知。当每位研究员背后站着5.7个甚至16个不知疲倦的智能体,当一天两万多美元的推理开销成为常态,当模型开始参与调试训练自己的继任者,行业需要的就不再只是产品发布会的节奏,而是一把能够丈量飞轮转速的尺子。
人类目前仍是AI研发闭环中的绝对核心,提供判断力与容错底线。但这条底线正被指数级增长的智能体工作日不断推高,而人类自己,或许正在成为那个最先需要被重新定义的变量。
