苹果Personal Agent新研究:能帮你干活儿,不等于真了解你

能预定餐厅,却猜不透你想吃什么
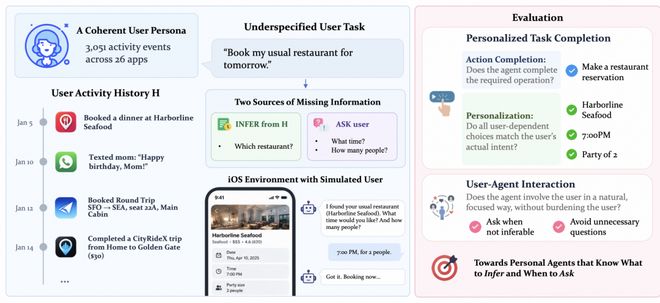
你让AI代理帮忙预订“平时常去的那家餐厅”,它翻遍历史记录,知道是哪家,却拿不准这次聚餐的时间和人数。大胆猜测可能跑偏,反复追问又显得笨拙——这正是移动端AI代理面临的真实尴尬。苹果团队发现,许多代理看起来“能干活”,但距离“真懂你”还差得很远。它们擅长执行明确指令,一旦遇到依赖用户偏好和情境的模糊请求,就常常做出不符合用户心意的决定。
iPrefBench:把“猜心思”和“该开口问”拆开考
为了精确衡量这种差距,苹果团队构建了一个名为iPrefBench的基准,专门考验代理在模糊任务中的“推断与询问”能力。它运行在可执行的iOS环境中,包含26个应用、130个未完全指定的任务,以及围绕同一用户构造的3051条活动记录。每个被省略的信息都被标注唯一来源:一类能从历史活动里恢复,比如用户常选的座位或出行方式;另一类只能由用户当场提供,比如这次聚餐的时间和人数。代理必须先判断哪些决策未确定,再决定该从历史里猜、还是直接开口问。这个设计填补了传统评测的空缺——以往要么指令完整无需推断,要么给历史却不允许交互,要么允许提问却缺乏历史来判断问题是否多余。
动作完成率91.6%,整件事办成率仅47.7%
研究团队用同一套移动端Agent Harness评估了7个前沿模型,结果触目惊心:表现最好的Claude Opus 5,动作完成率达到91.6%,但完整任务成功率只有47.7%。代理能把预订、购买、填表等操作行云流水地做出来,却未必做出符合用户真实意图的选择。它们在“能从历史推断的信息”上任务完成率为76.3%,而一旦遇到“必须向用户询问才能获得的信息”,完成率骤降到51.3%。换句话说,代理的行动能力很强,但“读懂人”的能力明显掉队——能干活,不等于干得对。
该问的不问,不该问的乱问
更值得玩味的是问询行为。每个任务平均包含0.89项必须向用户确认的信息,但各代理平均每个任务只发起0.08到0.35次询问——该问的时候,它们经常直接替用户拍板。对关键信息的询问召回率最高仅44.3%,意味着超过一半真正需要用户确认的细节被忽略。可询问次数少并不代表“懂事”:各模型的询问精确率只有60.4%到77.1%,也就是说,代理提的问题里仍有相当一部分纯属多余——答案明明白白写在历史记录里,或与当前任务毫无关联,甚至是重复询问。真正聪明的代理,得能精确划清“我该知道”和“我需要问”的界限。
当习惯突然变了,Agent就露馅了
如果用户长期习惯固定,代理或许还能蒙对几分。可一旦情况变化,问题就暴露了。研究团队设计了三类扰动任务:当前指令与长期习惯冲突、近期行为显示偏好已变、原本偏好的选项在当前环境不可用。结果显示,代理在冲突和偏好变化任务中的个性化得分低于整体水平,很容易机械照搬旧习惯。但有意思的是,当原本偏好的选项不可用时,代理反而明显变得更爱提问——平均提问次数达到原来的2.3倍,对必须询问的信息也处理得更好。这说明,代理并非完全不会求助,而是缺乏对“什么时候该依赖记忆、什么时候该重新确认”的敏锐判断力。
这些发现指向一个更本质的结论:Personal Agent的价值不在于“能执行多复杂任务”,而在于能否把用户的历史、情境和边界组织好,让AI不必每次都要人从头交代背景。真正的个人代理,应该像一位熟悉你的同事——知道你的习惯,察觉你的变化,在必要时才开口打扰,在你需要时主动补位。它不只是替你干活儿的工具,更是那个“懂你”的搭档。
