7名博士生仅用3个月从零训练7B大模型:代码+数据+训练日志全公开

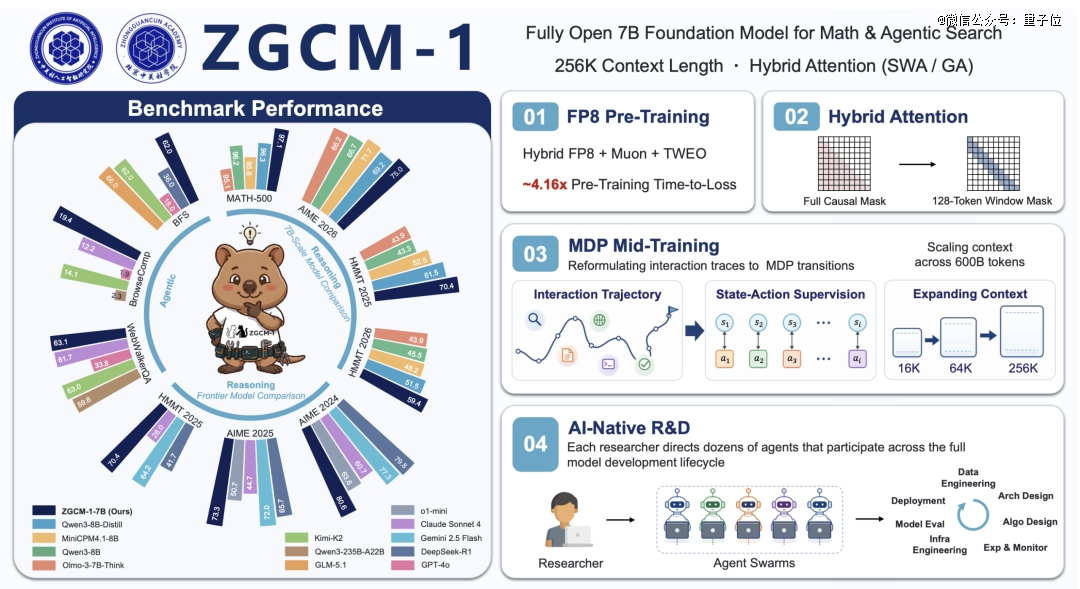
北京中关村学院的7名跨专业博士生,用一顿火锅的时间聊出了从零训练大模型的想法,最终耗时3个月跑通了7B大模型ZGCM-1的全流程研发,所有核心资料全面公开,为行业提供了可复现的大模型训练实践参考。
火锅局碰撞出跨专业训练目标
七名成员专业背景差异极大,2人来自人工智能方向、2人来自网络方向,剩余3人分别来自化学、生物、网络安全领域,此前大多仅在现成模型上做微调。大家在复盘技术报告时产生共同困惑:报告中一句轻描淡写的“数据清洗”“训练调优”,落地时究竟要完成多少具体工作?预训练阶段的能力天花板到底由哪些因素决定?正是这些困惑让大家萌生了从头完整训练一次大模型的想法,甚至最初的目标是打造一款能调用工具、延长思考链路的7B模型,挑战更大参数量的商用模型。项目获得校方与中关村人工智能研究院的支持,先期投入算力资源,团队在数天内快速跑通小规模模型的全流程,才得以推进7B模型的正式训练。
数百个Agent成为研发团队“外援”
7人的核心团队面对庞大的预训练工程显然人手不足,团队最终采用数百个Agent分工协作的AI4AI研发范式:需要理解原理、排查训练故障时,就让Agent从基础概念开始讲解,再对应到代码实现与实验现象中验证;数据清洗、代码调试、日志分析等重复性工作也交由Agent完成,核心决策权始终掌握在人类研究员手中。这种模式不仅大幅提升了研发效率,也让团队在实践中验证了AI辅助研发AI的落地可能性,过程中团队还对不同Agent的任务完成表现做了评级,为后续相关研究提供了真实的工程参考。
全链路资料公开填补开源生态空白
ZGCM-1项目最大的特点是全流程透明:团队不仅公开了模型权重,还将训练用到的全部代码、原始数据集、清洗后数据集、完整训练日志、技术报告一并放出,甚至包括训练过程中失败的尝试、调整配方的决策逻辑,彻底打破了大模型预训练的“黑箱”。当下多数开源项目仅公开模型权重,却对数据处理策略、训练调优过程、失败案例讳莫如深,此次ZGCM-1的全公开,让其他研究者能够清晰理解“为什么这样训练”而非仅仅知道“训练出了什么”,为降低大模型研发门槛提供了切实可行的参考。目前ZGCM-1的开源链接、技术报告、训练代码、模型权重及训练日志均已对外发布,研究者可自行下载复现。
三个月实践验证轻量化大模型训练可行性
最终团队按时完成了ZGCM-1的全部训练工作,模型在能力基准测试中达到了预期目标,项目也形成了完整的大模型训练实战经验沉淀。该项目由北京中关村学院何纪言老师指导,核心成员包括冯文俊、关浩祥、郭俊毅、梁广、柳浩、沈逸飞、孙锦博、谢彦泰等,同时得到了中关村两院数十名师生的支持。团队表示,此次实践不仅证明了跨专业小团队在有限时间内完成大模型研发的可行性,也为行业探索出了“AI辅助研发+全流程开源”的新范式,后续将持续更新相关资料,欢迎社区研究者复现验证。