PrismML 再出手:Bonsai 2 27B 以 1/9 内存占用保留 Qwen3.8 27B 98.2% 性能

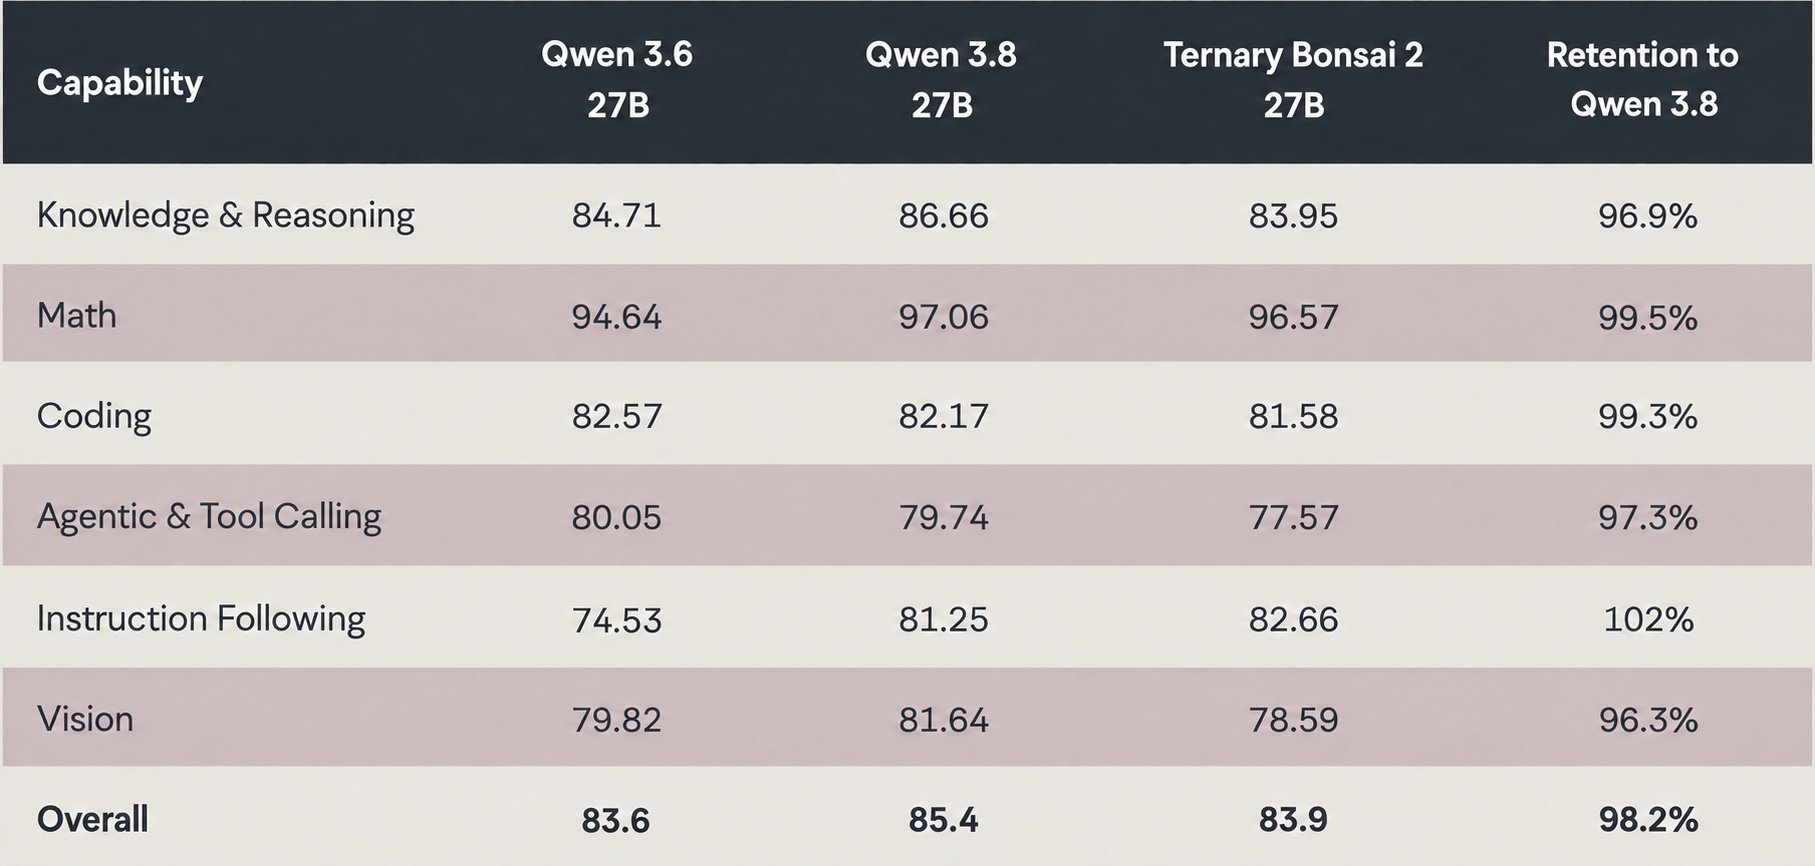
当地时间27日,人工智能实验室PrismML正式推出三值量化版本的Bonsai 2 27B模型,将基础模型升级至Qwen3.8 27B,在推理、编程、视觉、长程智能体等维度的性能较前代Bonsai 27B全面提升,综合表现甚至优于前代基础模型Qwen3.6 27B。
三值量化技术突破:27B模型内存占用降至全精度1/9
本次发布的Bonsai 2 27B采用了PrismML独家的FP16分组缩放三值量化方案,每个权重的有效比特仅为1.76,模型总大小压缩至5.9GB,仅为同规格全精度模型内存占用的不到1/9。在综合基准测试中,该模型拿到了基础模型Qwen3.8 27B 98.2%的分数,性能损失控制在极低水平。
从细分测试维度来看,量化后的模型在多数核心能力上几乎无损失:
- 通用知识测试得分100%,与原版全精度模型持平
- 编程能力测试得分97.6%,高于前代Qwen3.6 27B对应成绩
- 历史类测试得分98.8%,仅小幅落后原版
- 多语言测试(如波斯语)得分45.2%,是三值量化下损失最明显的领域
此外,该模型支持262K的超长上下文窗口,可满足长文档解析、长链路智能体等复杂任务的需求。
多端部署友好:消费级显卡即可流畅运行
Bonsai 2 27B已实现多平台适配,可通过CUDA在NVIDIA GPU上运行,也可通过MLX在Apple Silicon设备上运行,且以Apache 2.0许可证开放权重,开发者可自由使用和修改。
官方给出的性能数据显示,该模型在NVIDIA GeForce RTX 5090上的词元吞吐量可达143TPS,在Apple Silicon M5 Max上的词元吞吐量达46.8TPS;在GeForce RTX 4090上的推理能效为0.714mWh/Token,比同场景下的全精度8B模型低40%。
社区实测也印证了其低部署门槛:有用户使用PrismML分支的llama.cpp运行该模型时,仅需12GB显存即可完整加载并跑通65536长度的上下文窗口,低显存用户无需依赖云端即可本地运行大模型,被社区称为“低显存用户的福音”。
落地场景明确:可承载多数本地知识工作流
PrismML表示,Bonsai 2 27B的性能足以在本地承担编程智能体循环、计算机使用工作流、私有文档解析、多模态调试、混合编排等“真正的知识工作”,仅在需要调用更强模型能力时才需接入云端API,兼顾了本地部署的隐私性与云端模型的泛用性。
社区评价也普遍认可该模型的价值:有用户称其是“小体积模型中的最佳选择”,低内存占用与接近全精度的表现让其成为消费级硬件跑大模型的优选方案;也有业内人士指出,PrismML独有的量化技术目前尚无其他厂商实现复制,若后续该技术普及,将大幅降低大模型推理的成本与门槛。