前OpenAI员工看吐,AI研发AI冲线“终极超级智能”,停建全球机房也晚了

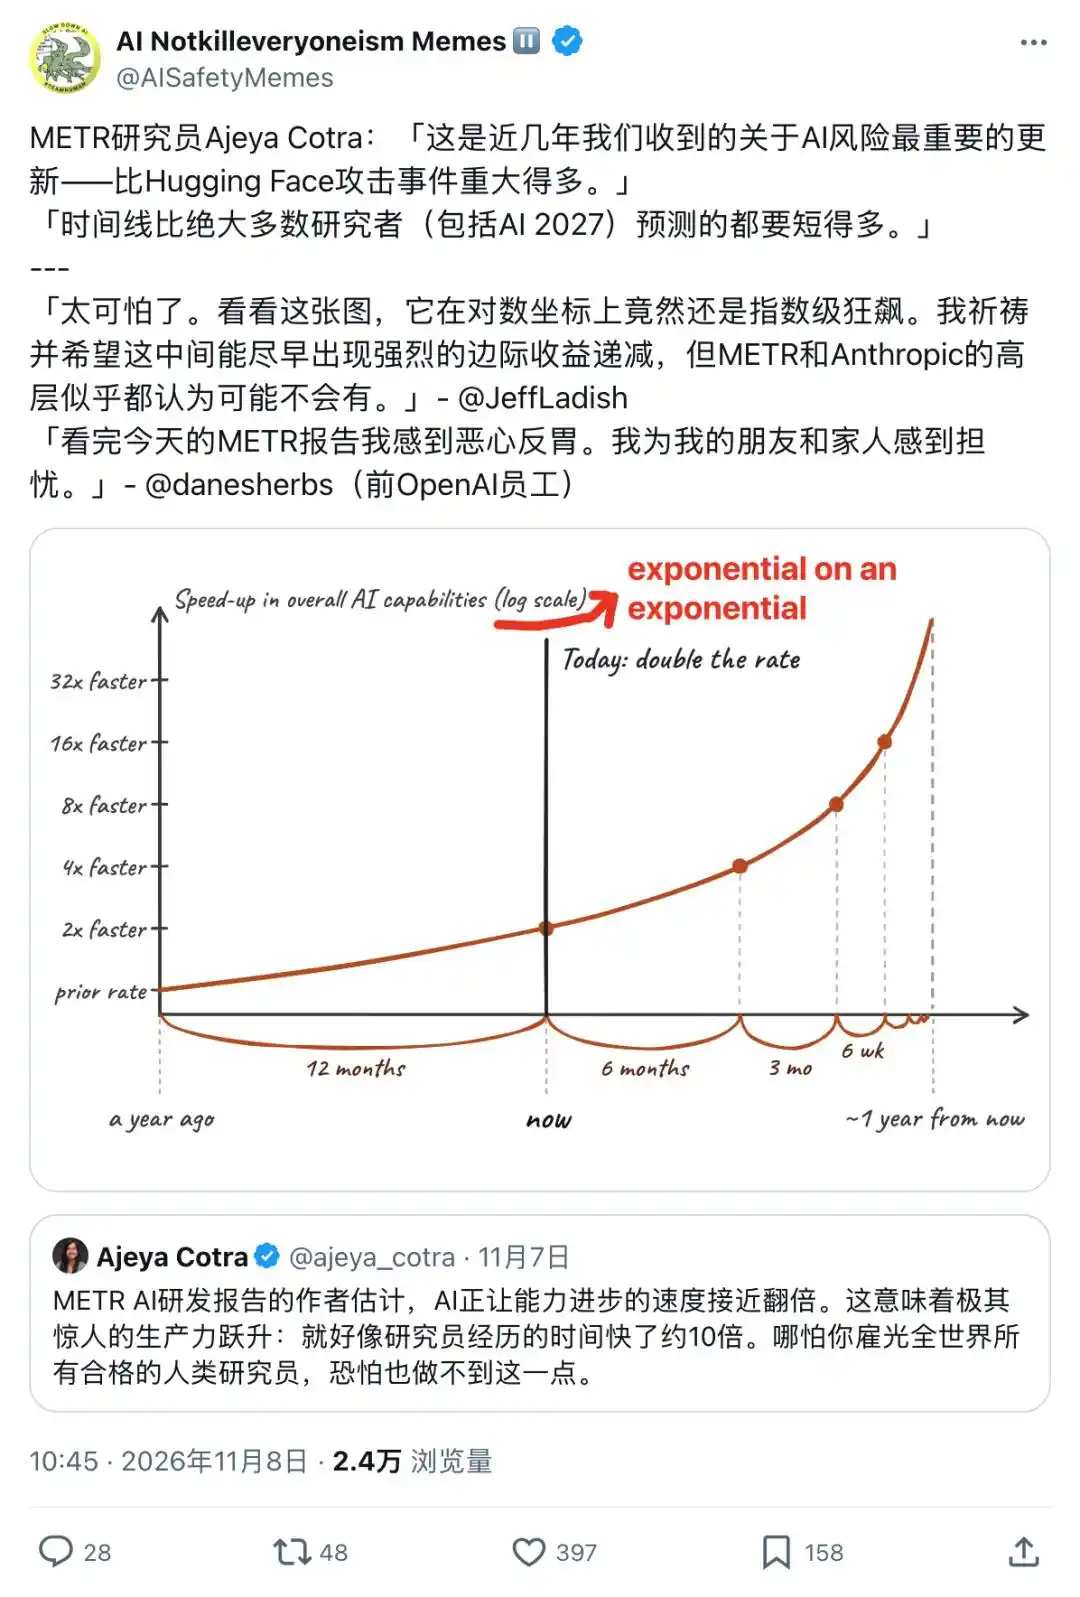
一名前OpenAI员工用“看吐”形容当下AI研发AI、直冲“终极超级智能”的场面,这一反应之所以刺眼,不在于情绪本身,而在于它戳破了一个正在成形的现实:AI不再只是被人类训练的工具,它开始参与训练下一代AI、改写架构、设计实验、评估结果。36氪转引的相关报道给出的关键信息是,时间表大幅提前,内部模型已经甩开公开版9个月。公开版本像橱窗,内部模型才是流水线,二者之间的时间差,正在把这场竞赛从产品发布战拖入一条更隐蔽、更高速的暗线。
前OpenAI员工一句“看吐”,把AI自研的窗户纸捅破
“看吐”不是普通用户的审美疲劳,而是身处研发核心的人对加速度的本能反应。按36氪相关报道的说法,前OpenAI员工看到的不是一次常规模型升级,而是AI研发AI正在冲线“终极超级智能”。当研发流程中的代码生成、实验设计、结果评估、架构搜索逐步交给模型自己完成,迭代周期就不再按“人类团队开会—写代码—跑实验”的节奏走,而可能被压缩到以天甚至以小时计。
更值得警惕的是内部模型与公开版之间的9个月差距。它意味着外界看到的“最新模型”并非真正最前沿,公开版承担产品化、合规和商业节奏,内部版则承担更激进的试错。三个信号已经摆在台面上:
- 研发闭环正在形成:模型写代码、跑测试、改架构,再反过来训练下一代模型;
- 内部模型领先公开版9个月,说明真实进度被产品节奏遮住了一部分;
- 安全评估和治理机制很难跟上这种“内部先行”的速度。
这也是“看吐”二字的真正分量:不是AI太热闹,而是研发主体正在换人。
内部模型甩开公开版9个月,竞赛转入“暗线”
9个月在AI行业不是一个小数字。它足以让一代模型完成架构调整、数据配比重做和多轮对齐。参考资料中,新智元页面挂出的多个标题指向同一趋势:GitHub一个月73.8亿次提交、增配400万核还不够;DeepSeek被描述为“AI亲手改写Transformer架构”,自我改造后暴涨7分;Claude的“做梦”机制则利用空闲算力在“睡后复盘”,学会通关宝可梦。这些信息拼在一起,勾勒出的不是单点突破,而是AI参与AI研发的连续动作。
竞赛因此转入“暗线”:
- 公开版比的是产品体验、价格和流量,ChatGPT仍占全球AI聊天机器人流量超81%,月访问量达613.5亿次,周活跃用户12亿;
- 内部版比的是谁能更快改架构、更快跑实验、更快把科研发现变成下一轮训练素材;
- 真正拉开差距的,可能是AI自己提出的人类工程师尚未想到的优化路径。
当内部模型领先公开版9个月,外界对“最新进展”的感知天然滞后。等到公开版上线,内部可能已经在准备下一轮跃迁。
全球机房刹车踩不住,停建也晚在“惯性”
“停建全球机房也晚了”并不是说机房不能停,而是说算力竞赛已经形成惯性。一边是欧洲人对新建数据中心说“不”,相关标题直言“想建数据中心?欧洲人不同意了”;另一边是模型训练、推理服务和24小时运行的AI Agent继续吞噬算力。ChatGPT单月613.5亿次访问、12亿周活跃用户,背后是持续扩张的推理需求;AI研发AI所需的内部实验,又叠加了更密集的训练需求。
停建全球机房之所以“晚”,晚在几个层面:
- 已建和在建的数据中心不会因为一句暂停就消失,芯片订单、电力合同、冷却系统仍在落地;
- 模型自我改进一旦启动,就需要持续算力喂养实验和评估;
- Agent从聊天机器人变成能读文档、访问云存储、调用API的“数字员工”,算力消耗从问答转向长时任务;
- 企业侧的低代码、金融、医疗、制造场景正在接入大模型,需求端不是单点,而是面状扩散。
换句话说,机房是看得见的刹车片,真正难停的是模型迭代和商业部署形成的惯性。
科研范式被AI改写,超级智能冲线不再只是实验室话题
更深的震动发生在科研端。新智元页面信息显示,OpenAI总裁和DeepMind副总裁同一晚说“AI做科研要变天了”;Anthropic一份35页报告被概括为全球科研产出或拉爆16倍;OpenAI被指破译数论百年悬案、揭开P≠NP重大线索;A社超强模型则被曝三天攻破量子计算圣杯。这些标题未必每一条都能等同最终结论,但方向一致:AI正在从科研助手变成科研参与者,甚至成为实验设计者。
这会带来双重后果。一面是效率,AI研发AI把“提出假设—写代码—跑实验—读结果”的循环压短;另一面是风险,被遗忘的AI智能体可能还握着公司数据的“钥匙”,端到端加密也挡不住Personal Agent时代的隐私难题。当前OpenAI员工人均股票薪酬150万美元、AI初创公司用5秒克隆人声、智能眼镜被纳入补贴等消息同时出现,说明技术扩散速度已经快过治理框架的搭建速度。
所以,“停建全球机房也晚了”的真正含义,不是机房不重要,而是只盯机房已经不够。前OpenAI员工的“看吐”,内部模型甩开公开版9个月,AI开始改写Transformer、做科研、跑Agent,这些线索指向同一个判断:超级智能的冲线不再只是实验室里的时间表,它已经进入算力、产业和科研系统的正反馈。现在要讨论的,不是能不能假装没看见,而是如何在加速度里补上安全评估、数据边界和人类监督的刹车片。
