面试官:生产环境 Agent 如何评估性能、成本和稳定性,核心指标有哪些?

当前大模型Agent加速落地各行业生产场景,不少团队仍沿用传统大模型的“准确率”单一指标衡量Agent表现,往往上线后出现成本失控、响应缓慢、执行越界等各类问题。生产环境的Agent是具备多轮交互、工具调用、状态管理能力的复杂系统,其评估需要覆盖全链路执行过程,而非仅看最终输出结果。
生产环境Agent评估为什么不能只看准确率?
传统大模型评测以单轮问答为核心,只要最终输出符合标准答案即可判定为合格,但Agent的核心价值是帮用户完成复杂任务,执行过程的好坏直接决定落地价值。比如代码修复Agent最终答对了Bug原因,但中间调用了8次大模型、耗时3分钟,或是该调用代码检索工具时直接瞎编代码,这类“结果正确但过程糟糕”的情况,仅靠准确率完全无法识别。此外,Agent还可能出现执行越界、敏感数据泄露、被提示注入绕过规则等隐蔽风险,这些都会直接影响业务安全,必须纳入评估体系。
生产级Agent评估的三大核心维度拆解
生产级Agent的评估需要覆盖性能、成本、稳定性三大核心维度,每个维度对应可落地的量化指标:
- 性能维度:核心指标包括端到端延迟(用户发起请求到获取最终结果的时长,直接决定用户体验)、单步推理延迟、工具调用耗时、多步任务完成率、任务执行轮次(完成同等任务所需交互轮次越少效率越高)、计划一致性(Agent执行过程是否和初始规划匹配,避免乱走流程)、探索效率(信息不足时是否能快速找到有效路径,避免无效调用)。这些细粒度过程指标能直接反映Agent的执行效率,避免“结果对但过程烂”的问题。
- 成本维度:核心指标包括单任务平均调用成本(完成一次任务消耗的token总费用、工具调用费用总和)、大模型调用次数、无效工具调用占比(不该调用的工具被误调用的比例,直接造成额外成本)、错误重试带来的额外成本、幻觉导致的无效交互成本。成本是Agent落地商业化的重要门槛,很多Agent功能达标但无法大规模推广,核心就是成本失控。
- 稳定性维度:核心指标包括任务成功率(正常完成用户需求的比例)、异常场景兼容率(工具故障、需求模糊、信息不足等场景下不崩溃、能降级处理的比例)、错误率(包括幻觉错误、工具调用参数错误、逻辑错误等)、安全违规率(越权操作、敏感数据泄露、被提示注入、执行高风险操作等违规事件的发生比例)、SLA可用性(服务可正常响应的比例,比如99.9%的请求不报错)。稳定性直接决定Agent能否在生产环境长期运行,尤其是企业级Agent,一次越权操作就可能造成重大损失。
离线+在线双评测体系拦住Agent上线风险
生产级Agent的评估不能只靠上线后验证,需要构建离线+在线结合的全流程评测体系,提前拦截风险:
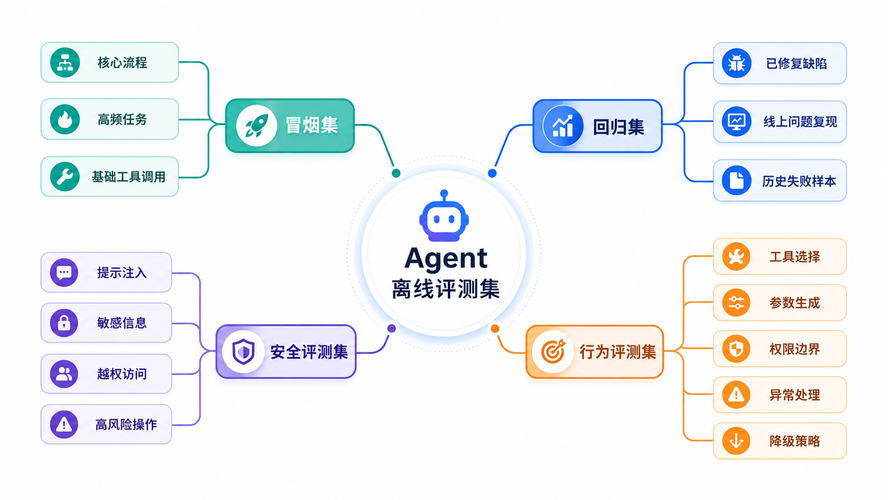
首先是离线评测,在上线前完成基础能力校验:需要构建三类评测集,一是结果质量评测集,覆盖常见业务场景,验证最终输出的准确性、完整性、是否符合用户意图;二是行为评测集,专门测试Agent的执行逻辑,比如信息不足时是否会追问、需要查证时是否会先检索、工具失败时是否会降级、需要用户确认时是否会暂停等待,避免Agent乱走流程;三是安全评测集,覆盖权限校验、敏感数据脱敏、提示注入防御、高风险操作二次确认等场景,确保Agent不会越界。离线评测可采用“强模型作为裁判+人工抽检”结合的方式,效率更高,同时要和历史基线版本对比,避免新版本能力倒退。
其次是在线评测,上线后是真实考场:真实用户的场景远比离线评测集复杂,需要重点跟踪任务实际完成率(比如代码Agent修复Bug的成功率、客服Agent解决用户问题的比例、数据分析Agent生成可用报表的比例)、用户投诉率、实际端到端延迟、线上错误率等业务相关指标,这些指标比单纯的回答准确率更贴近业务价值。
最后是失败样本回流机制:将线上出现的失败案例、异常案例同步回流到离线评测集,不断补充评测覆盖度,和传统软件的回归测试逻辑一致,Agent的回归不仅要测结果,还要测过程,通过持续迭代让Agent越来越稳定。
面试回答可直接套用的核心逻辑
面试时回答这类问题,可以先点明核心前提:“Agent评测和传统LLM评测的本质区别是,LLM测的是单轮输出的准确率,Agent测的是整个任务链路的完成度,不仅要看结果好不好,还要看过程稳不稳、成本高不高。” 然后分维度列举核心指标,再结合双评测体系和回流机制说明落地方法,最后可以结合实际场景举例,比如“我之前做的电商客服Agent,核心评估指标就是任务完成率、端到端延迟、单任务成本、安全违规率,通过离线+在线评测迭代,最终把任务完成率从70%提升到92%,单任务成本下降了40%”,让回答更有说服力。