深度解读:智谱为什么要在 Infra 层搞 RSI?

2026年9月,匿名模型“Ox-Alpha”登陆OpenCode、OpenRouter平台,上线一周即成为双平台调用量最高的模型,6天token调用量突破62万亿。随后智谱确认,该模型即基于十万张国产AI加速器集群运行的GLM-5.3-Flash,其背后最核心的技术变量,正是首次在Infra(基础设施)层落地的RSI(递归自我改进)框架。
十万张国产芯片集群:两周跑通生产级推理服务的硬仗
此次部署是国内首次大模型全量跑通十万张国产芯片集群的公开案例,此前行业缺少成熟经验参考。智谱团队面临多重挑战:国产芯片显存容量、互联带宽相对受限,新模型架构适配、100万token长上下文支持、多模态请求处理等需求叠加,且国产AI加速器软件生态仍在发育阶段,部分算子支持不足,大量技术资料需要工程团队自行探索。更棘手的是十万张卡量级带来的硬件稳定性问题,集群中每天都可能有数百张卡出现硬件故障、网络掉线或数据丢包。
传统来看,将大模型从新硬件首次跑通推进到稳定承载生产流量的推理服务,需要经验丰富的基础设施工程师团队花费数周甚至数月才能完成。但智谱透露,从第一次全量跑通到全部真实生产流量切至新集群,仅用了短短两周,且端到端吞吐量直接提升3.2倍。面对硬件生态的不完美,智谱通过软件优化给硬件“打补丁”,不仅让大模型顺利跑通,更实现了性能的跨越式提升。
稠密反馈闭环:把资深工程师的“工程直觉”量化给AI
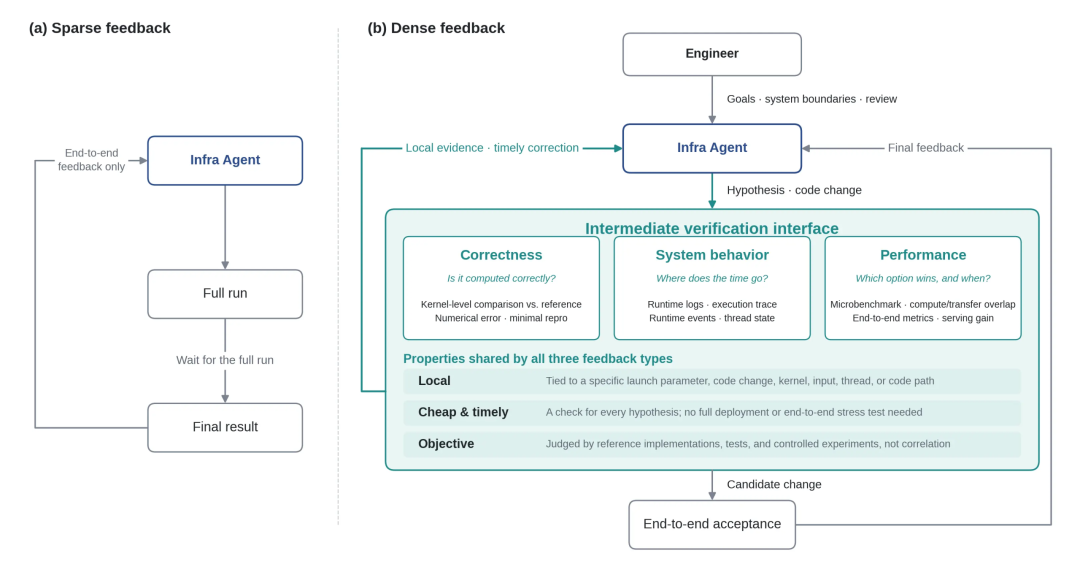
传统推理系统优化长期受“稀疏反馈”问题困扰:系统仅会抛出“吞吐量下降20%”这类端到端结果,却无法告知问题出在底层代码、内存调度还是数据传输,也无法归因是哪次改动引发了性能退化。若让AI自主排障,每次修改后都需要数小时跑完整套测试,试错成本极高,探索过程极其缓慢。唐杰指出,这本质是强化学习领域的“稀疏奖励和信用分配”难题:AI要等全部动作做完才能拿到“好”或“坏”的信号,却无法将结果归因到具体步骤,探索效率极低。
智谱RSI框架的核心,是构建三层可归因的稠密反馈机制,把资深Infra工程师“说不清但管用”的工程直觉转化为AI可调用的量化逻辑:正确性反馈回答“算对了吗”,通过参考实现和误差容限判断计算精度;系统行为反馈回答“时间花在哪了”,通过执行时间线和运行时事件揭示计算、等待、通信的时序关系;性能反馈回答“哪个方案更好”,通过受控实验和可比指标判断优化路径的优劣。
在此基础上,智谱还搭建了AI优化模板库:团队让AI读遍SGLang、Flash Linear Attention、DeepGEMM等开源项目中高手手写的内核,提炼出通用优化骨架。当Agent遇到匹配场景时,会直接套用对应思路重构代码,跑小规模测试验证效果,有效方案会反哺模板库,形成能力复利。在此次GLM-5.3-Flash的优化中,Agent不仅自主定位了KDA上下文并行路径中因TF32舍入误差累积导致的长上下文精度漂移问题,还解决了KV传输并发瓶颈、解码内核冗余计算等多项资深工程师需要耗时许久才能排查的难题。
从“卖工具”到“卖效率”:算力受限下的技术主动权争夺
智谱过去凭借强悍的Coding能力被称为“国内版Claude”,瓜分了国内大部分Coding工具市场,但2026年以来将大量精力投向底层Infra建设,核心判断是:在算力受到外部严格限制的情况下,中国AGI能否取得突破,关键不在拥有多少芯片,而在于能否通过软件更高效地调动和利用算力。
此次Infra层RSI的落地,本质上是智谱希望建立“底层解耦”能力:让AI能够自主适配不同硬件生态,跨越硬件之间的兼容障碍,把“国产算力不好用”的行业难题,转变为“由AI自动挖掘硬件极限”的技术主动权。在智谱的规划中,未来大厂之间的代际差距,将由“模型参与构建自身系统的深度”决定——谁能率先跑通“模型训练-Infra优化”的闭环,谁就能在物理算力受限的情况下,通过能力复利实现非线性的超车。
尚未抵达递归自我改进:人类仍守住决策与风险红线
尽管此次实践已经展现出了RSI的早期形态,但智谱明确表示,距离真正的递归自我改进仍有很远距离。当前Infra Agent的能力边界仍由人类划定:选择优化目标、设定系统边界、判断业务风险,全部由人类工程师完成,Agent仅在工程层面承担诊断、执行、验证的流程化工作,Infra系统的进化仍是“人类把关+AI高速迭代”的流水线模式。
唐杰指出,当前Infra Agent卡住的场景很少是写不出代码,而是无法在稀疏反馈下快速归因问题。而此次稠密反馈闭环的落地,已经让AI的排障能力深入算子精度层,跨越了语言边界,成功优化的经验也正在以前所未有的速度形成复利。两周、三倍、十万卡这些数字证明,Infra层的技术迭代速度不会因为主观期待而放缓,而“模型优化系统,系统承载模型”的循环,才刚刚开始。