
seedrouter是什么
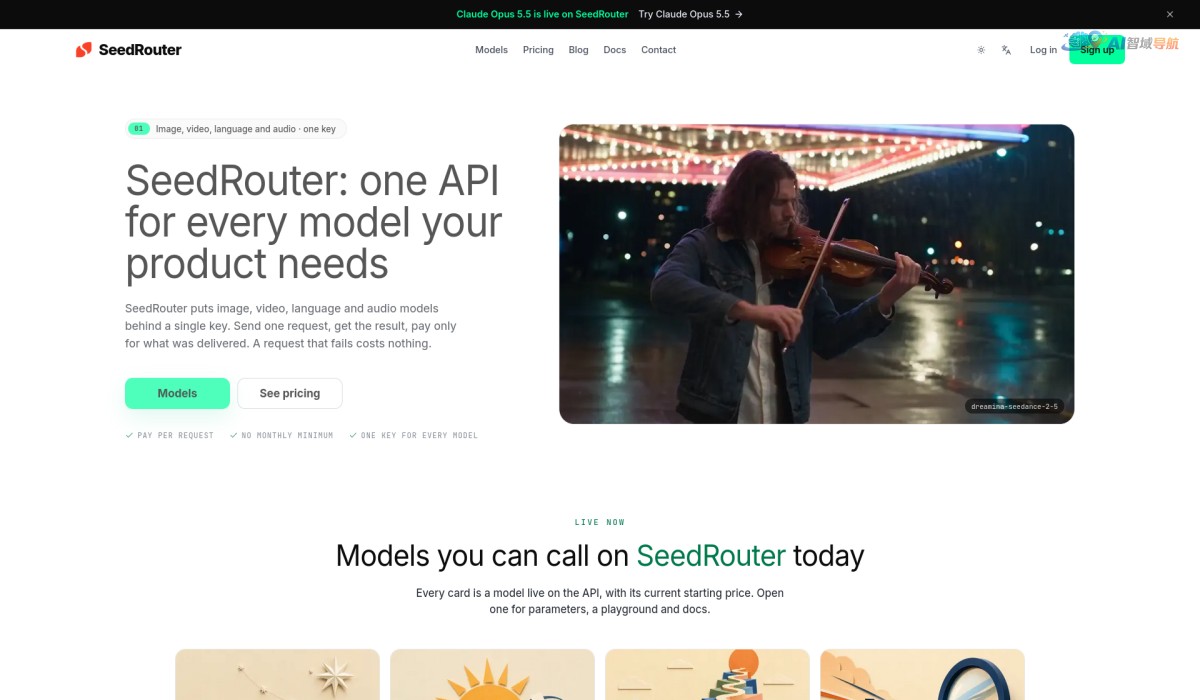
seedrouter 定位为“多模态 AI 模型 API 网关”,旨在解决开发者需要同时对接多种模型时的复杂性问题。它通过一个统一接口,将图像生成/理解、视频分析、自然语言处理、语音识别与合成等不同模态的模型能力整合在一起。你无需分别对接各个模型供应商,只需使用 seedrouter 的标准化 API 格式,即可按需切换底层模型,大幅降低集成成本与维护负担。平台尤其适合需要跨模态能力组合的 AI 应用,例如图文问答、视频摘要、语音交互等场景。
核心优势
- 单一接口,多模型接入:统一鉴权、统一请求格式、统一返回结构,替换模型时不改动业务逻辑。
- 模态覆盖广:支持图像(生成、编辑、理解)、视频(理解、剪辑)、语言(对话、文档处理)、音频(识别、合成)。
- 灵活路由与降级:可根据预设策略自动选择模型,并在某个模型不可用时自动切换备用模型,提升稳定性。
核心功能模块
seedrouter 针对不同模态提供了清晰的功能分组,方便开发者按需调用。
| 模态 | 典型能力 | 适用场景 |
|---|---|---|
| 图像 | 文生图、图生图、视觉问答、OCR | 广告设计、内容审核、文档解析 |
| 视频 | 视频内容理解、镜头摘要、关键帧提取 | 视频检索、审核、剪辑辅助 |
| 语言 | 文本对话、指令遵循、结构化输出 | 客服机器人、知识库问答、代码生成 |
| 音频 | 语音转文字、文字转语音、情感识别 | 会议记录、有声内容生成、语音助手 |
每个功能模块都提供统一的请求参数设计,例如 model 字段指定模型名称,input 字段包含对应模态的内容,parameters 字段控制生成参数。同时,平台提供了详尽的错误码与调试日志,方便快速定位问题。
快速接入与使用流程
从注册到正式调用,seedrouter 的流程设计追求轻量直接。以下是标准的接入步骤:
-
创建账号并获取 API Key
在控制台注册后,创建项目并生成专属密钥,所有请求均需携带该密钥进行鉴权。 -
选择合适的模型
浏览模型广场,根据任务类型和预算挑选模型。每个模型页面都展示了支持的输入格式、速率限制和计费方式。 -
调用统一 API
使用任何支持 HTTP 的编程语言发送请求。下面是一个概念性的请求示例(非真实地址):POST /v1/completions { "model": "vision-model-x", "input": { "image": "base64编码或URL", "prompt": "描述这张图片" }, "parameters": { "temperature": 0.2 } } -
处理响应与监控用量
响应中直接返回结构化结果,同时控制台实时展示调用次数、延迟和费用,方便进行成本监控。
适用场景与开发建议
seedrouter 特别适合以下几类团队:
- AI 应用创业者:快速验证多模态想法,无需在早期绑定单一模型供应商。
- 企业开发组:统一管理多个业务线的模型调用,便于计费分摊与权限治理。
- 个人开发者:用低成本体验多种前沿模型,降低学习与实验门槛。
在使用时,建议重点关注 timeout 与 max_retries 参数设置,因为视频类模型响应时间通常显著长于文本模型。另外,平台支持为不同模型设置单独的超时策略,可有效避免因单次慢请求阻塞整体流程。若需要稳定的生产环境,请提前配置备用模型并开启自动降级开关。