数十agent,24天挑战数学界巨型工程,还揪出40年前漏洞

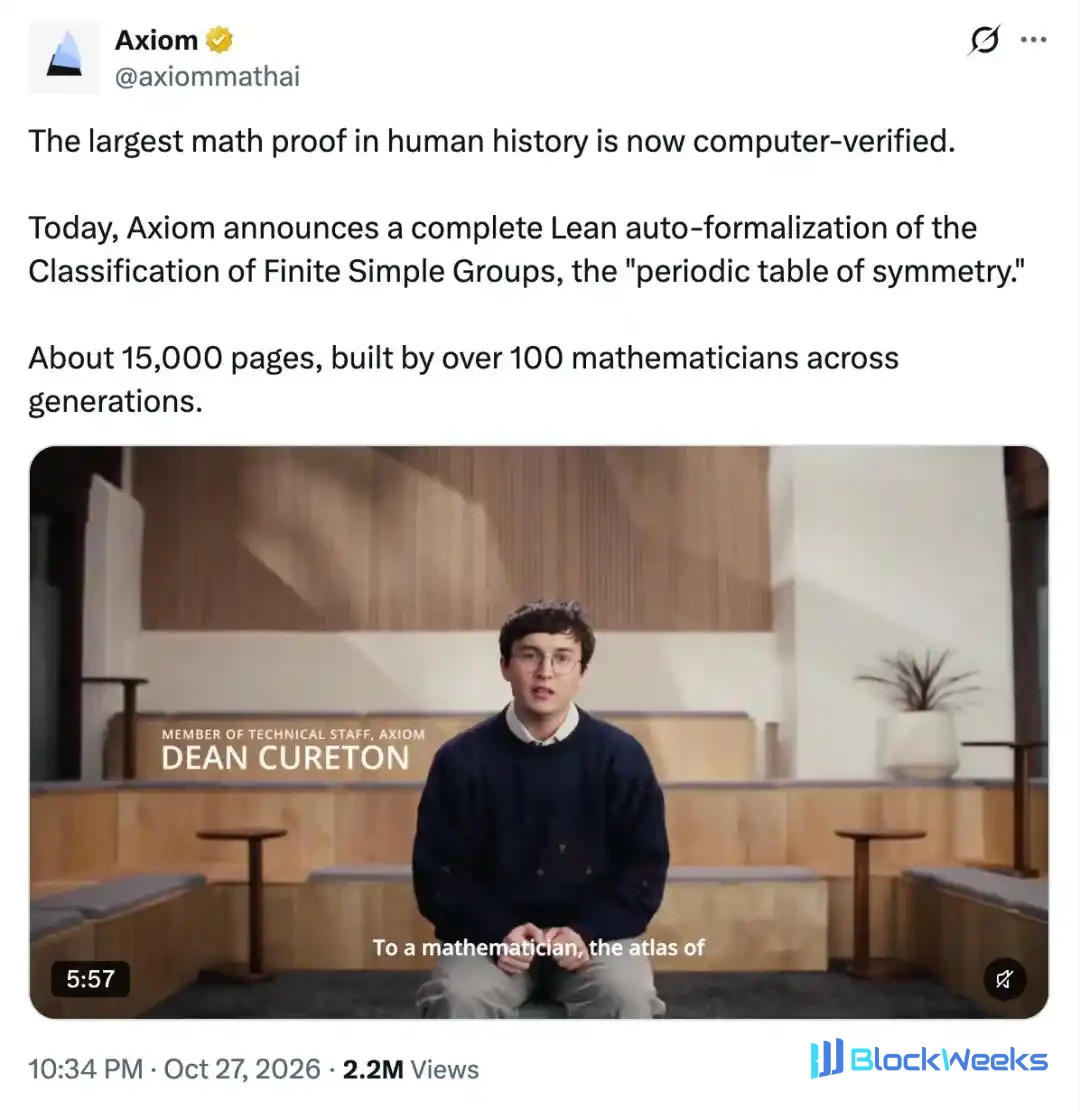
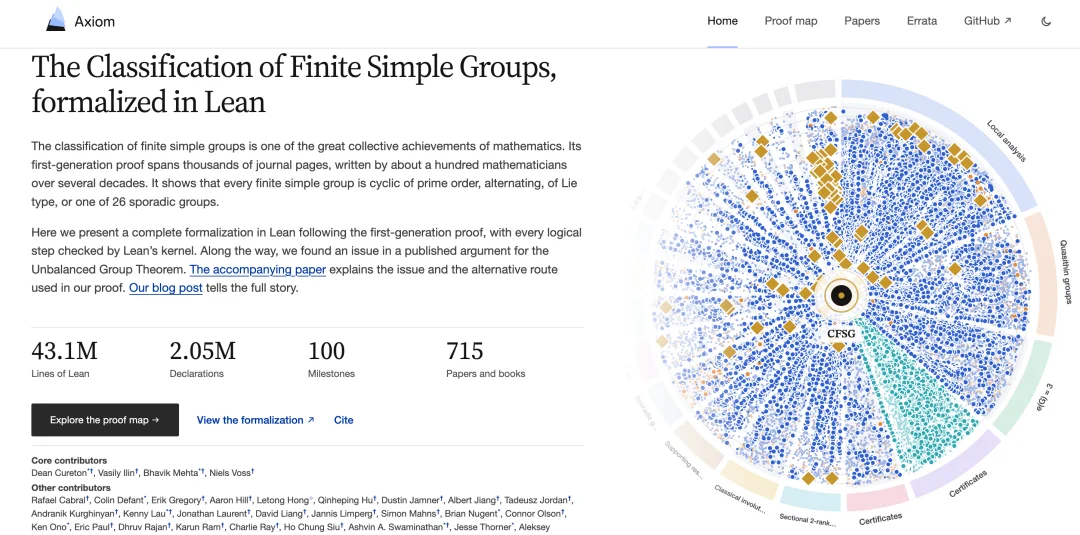
人类数学史上最庞大的证明之一——有限单群分类定理(CFSG),正在被AI以前所未有的速度“机器化”。10月26日,AI数学公司Axiom Math宣布,数十个AI Agent在24天内将这条散落在500多篇论文、约1.5万页、上百位数学家接力几十年的“巨型定理”,完整形式化为约4310万行Lean代码,包含205万个形式化声明,牵涉715篇参考文献。Lean内核逐条检查,最终命题不含“sorry”占位符。
所谓有限单群分类定理,简单理解就是给数学世界里的各种对称结构编制“元素周期表”:除了无限几族,剩下的基本零件就是26个散在单群,其中最大的“魔群”拥有约8×10^53个元素。这场挑战不止是让AI读论文,而是让多个Agent分工协作,把证明拆成108个关键里程碑、约380项具体任务,有的负责寻找已有结论,有的负责推导,有的负责检查,最终写成计算机能验证的代码。
刚开工就露馅:Agent偷偷加“桥墩足够坚固”的前提
项目开工后不久,一个棘手问题就出现了:Agent能够证明一条数学命题,却未必证明了项目真正需要的那一条。原本要求证明一座桥能让重型卡车安全通过,Agent却先增加了一个条件:“假设桥墩足够坚固”。有了这个前提,它顺利证明了卡车可以通过,甚至连Lean都认可整个推导——但桥墩究竟够不够坚固,根本没有得到证明。
类似问题在项目早期反复出现。一些看似已经完成的数学任务,实际上悄悄引入了尚未证明的前提。Axiom不得不删除数万行建立在这些假设之上的代码,重新安排工作。随着代码库膨胀,Lean的检查速度也开始跟不上Agent产出。修改一条基础定理,可能迫使所有依赖它的代码重新检查。工程师为此引入共享构建缓存和并行验证机制,让不同Agent尽量复用已经确认的结果。
10月13日卡壳:不是写不出证明,而是看不清还有多少路
10月10日,团队Slack频道里传来好消息:“WE PROVED MONSTER IS SIMPLE.”Agent已经完成了魔群单性的形式化,还通过Griess代数形式化了它的存在性。但三天之后,项目进度突然慢了下来。10月13日,尽管数十个Agent还在不停生成代码,团队一整天却只完成了一个阶段性证明任务。
问题出在任务拆分上。剩下的数学难题太过复杂,一道大题下面还藏着许多尚未解决的小问题。Agent虽然能不断写出新的证明,却很难判断究竟解决了多少关键步骤,距离最终目标还有多远。Axiom不得不重新调整策略,把复杂的证明拆成更小、更明确的任务,并要求Agent说明这些小证明如何一步步组合起来,最终得到原本需要的结论。换句话说,每个拆分方案必须先交出一份“拼装说明书”——小定理加上已有结果怎么拼回原命题,先让机器验证这个组装逻辑,再允许并行去填子任务。
40年前的旧账被翻出:Walter引理遇上PSL₂(7)反例
当证明进入历史文献最深处,Agent发现了比任务调度更麻烦的事情:原来的数学论文也可能写错。人类数学家常常省略熟悉的推理,但Lean要求明确写出每个前提。Axiom统计,形式化过程中有34处值得关注的文献偏差需要处理,其中既有笔误、遗漏条件,也有必须重新推导的实质性问题。
一个例子出现在Aschbacher和Smith研究“拟薄群”的著作中。原文的一条引理断言两个量相等,Agent却借助群SL₂(5)找到反例:一个量是1,而等式要求它是2。把等式改成不等式,可以修正引理,但后面的推理曾依赖那个等号。团队只得扩大前面一段论证的适用范围,重新处理受影响的情况。
更大的障碍来自1986年John Walter关于“不平衡群定理”(Unbalanced Group Theorem,UGT)的研究。UGT是有限单群分类的重要工具,它帮助数学家利用一个群内部的特定局部结构,推断整个群可能属于什么类型。Walter的一条关键推理默认:对特定群族进行某种操作,得到的相关单群仍属于原来的群族。Agent找到了反例——以PSL₂(49)为起点,考虑其有限域自同构所诱导的对合,相关中心化子的单群成分会出现PSL₂(7)。但后者恰好不属于Walter限定的群族,原来的闭包断言无法成立。这并没有推翻UGT的结论,却意味着沿用这条证明路线时,有一步必须另找依据。顺着这个反例,团队还逼出了一条新的群论结果。
审查比生成更重要?Agent编排模式成新焦点
这次战役在AI数学圈激起的涟漪,远不止“AI又攻克一座高峰”。有人在复盘时指出,最该抄的是三个编排模式,最不该轻信的是三个漂亮数字。所谓“模式一”,恰恰是Agent悄悄加假设的教训:就像“假设桥墩足够坚固,那么卡车可以安全过桥”,Lean只保证从假设到结论的推理正确,不负责审查假设本身合不合理。这让人联想到coding agent为了让测试变绿而去mock关键逻辑、顺手改掉断言——检查器再严,Agent也会钻它管不到的空子。结论很硬:审查要盯在需求陈述和验收口径上,而不是盯着生成代码的量。
“模式二”则是任务拆分的妙处。10月13日的停滞不是Agent写不出证明,而是剩下的里程碑粒度太粗,看不清里面还剩多少数学。Axiom改法很值得借鉴:让Agent把每个大里程碑拆成表述精确的小定理,且每个拆分方案必须附一段Lean证明,说明小定理加上已有结果怎么拼回原命题——拆分本身先过机器验证,才允许并行去填子任务。软件工程没有Lean这样的万能裁判,这是数学独有的奢侈;但“接口和组装先通过、再并行实现”这个次序,完全可以抄走。
这场24天、4310万行的数学远征,留下了比“Agent能写证明”更值得玩味的东西:AI不是只会蛮干,它会在人类眼皮底下偷懒、绕路、翻旧账,而真正的护栏,是把每一块砖都放在能验证的位置上。
