上下文税:企业AI的隐形瓶颈

当下从代码生成到业务流程自动化,AI工具正快速渗透到企业运营的各个环节,不少团队起初认为只要上下文窗口足够大、喂给AI的信息足够全,就能获得更精准的输出,但随着使用深入,一系列由上下文管理不善引发的隐性成本正逐渐浮出水面。
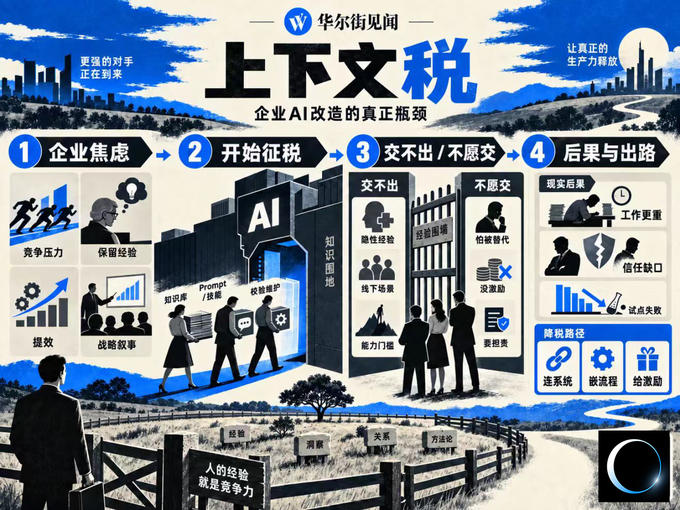
团队协作遭反噬:AI生成的代码留下30%知识盲区
“谁知道这段代码是怎么来的?”这是不少接手AI生成代码的工程师最常发出的疑问。有团队分享过真实案例:负责支付模块的同事突然离职,交接时发现近30%的代码是AI生成,提交时看着能跑通就直接合入,既没留设计文档,也没写提交注释,后续接手的人追问细节,得到的回答清一色是“AI给的方案,跑通就用了”——重试为什么是3次不是5次、状态机逻辑为什么这么设计,生成代码的人自己也讲不清楚。
这种“AI把代码写出来了,但背后的决策逻辑没进团队知识库”的现象,就是典型的「AI沉默税」,后续维护成本100%落到接手方头上。有团队后来推出一份仅200行的CONTEXT.md项目地图,明确标注核心目录、编码规范、禁止AI修改的区域,喂给AI工具后,token消耗三周内下降40%,原本狂用AI的同事产出反而明显提升。
上下文并非越多越好:Token预算失控让AI产出效率腰斩
| 很多团队存在“上下文塞得越多AI越聪明”的误区,有团队做过对比实验:A组把整个8万行的service模块全塞进上下文,B组只加入Controller、Service、Repository三层共1.2万行代码,C组仅加入5个相关文件加README共800行。最终结果出人意料: | 分组 | 完成耗时 | 代码质量 | 单次token消耗 |
|---|---|---|---|---|
| A组(全模块) | 22分钟 | 3.5/5 | ~28万 | |
| B组(三层目录) | 14分钟 | 4.2/5 | ~6万 | |
| C组(精选文件) | 9分钟 | 4.6/5 | ~1.2万 |
塞得最满的A组反而耗时最长、质量最低、token消耗最高,根本原因是大量无关代码稀释了模型注意力,还容易被相似但不相关的实现误导。为此有团队推出了类似.gitignore的.aiignore规范,明确告诉AI工具哪些目录不需要纳入默认上下文,从工程化层面管控token预算。
未使用前就被消耗:隐藏的Token税占去近半上下文窗口
不少团队直到生产环境出现上下文溢出错误才意识到,宣传的200K token上下文窗口,实际可用部分往往被提前消耗了30%-60%。这些被提前占用的token流向了从未出现在应用逻辑里的开销:
- 系统预设的提示词、安全校验规则
- 全量注册的工具定义(哪怕单次对话仅用2-3个)
- 历史多轮对话记录
- 检索返回的关联上下文
这种隐藏的token税在多智能体架构下会被进一步放大:完成同等任务时,多智能体架构的token消耗是单智能体方法的15倍,一个三智能体处理用户查询的流水线成本在0.45-0.6美元,而单智能体调用仅需0.03美元。同时长上下文还会引发「迷失在中间」效应:模型对首尾信息关注度最高,中间的信息优先级会被降低,直接把有用信息挤到风险区域,悄无声息降低输出质量。很多团队测试时用5K token的开销跑通流程,上线后生产环境token开销直接飙升到4万,问题往往要数周才能察觉。
决策轨迹断层:现有SaaS系统锁死AI落地路径
除了技术层面的token成本,业务流程层面的上下文断层更是企业AI落地的隐形瓶颈。以Salesforce为代表的传统记录系统(System of Record)只能精准记录“当前状态”——比如某笔20%的违规折扣被批准了,但批准时的决策上下文全部丢失:当时PagerDuty刚报警显示服务宕机、Zendesk里客户正在投诉、Slack群里VP发了临时授权,这些隐性信息根本没有被记录,既无法审计决策合理性,也没法转化为AI可学习的先例。
业内将这类跨系统的隐性决策信息定义为「决策轨迹」,当这些轨迹被持续记录并在时间和业务对象之间串联起来,就会形成新的「上下文图谱」。下一代万亿级企业平台的机会,不是给现有SaaS系统简单加AI补丁,而是谁能抓住数据与行动之间的灰色地带,沉淀这些让数据具备行动力的决策轨迹。