实测智象HiDream-O1-Video视频模型:嘻哈说唱、NBA绝杀,视频生成开始理解真实世界

9月15日,智象未来(HiDream.ai)正式发布首个原生全模态视频生成模型HiDream-O1-Video-1.0(简称HD-V1),该模型采用智象自研原生全模态架构,支持文本、图片、视频等多模态输入,可一键生成5-20秒1080p高保真视频,标志着智象自今年4月发布的HiDream-O1原生全模态世界模型架构完成全赛道布局。
智象推出首款原生全模态视频生成模型,全模态矩阵闭环成型
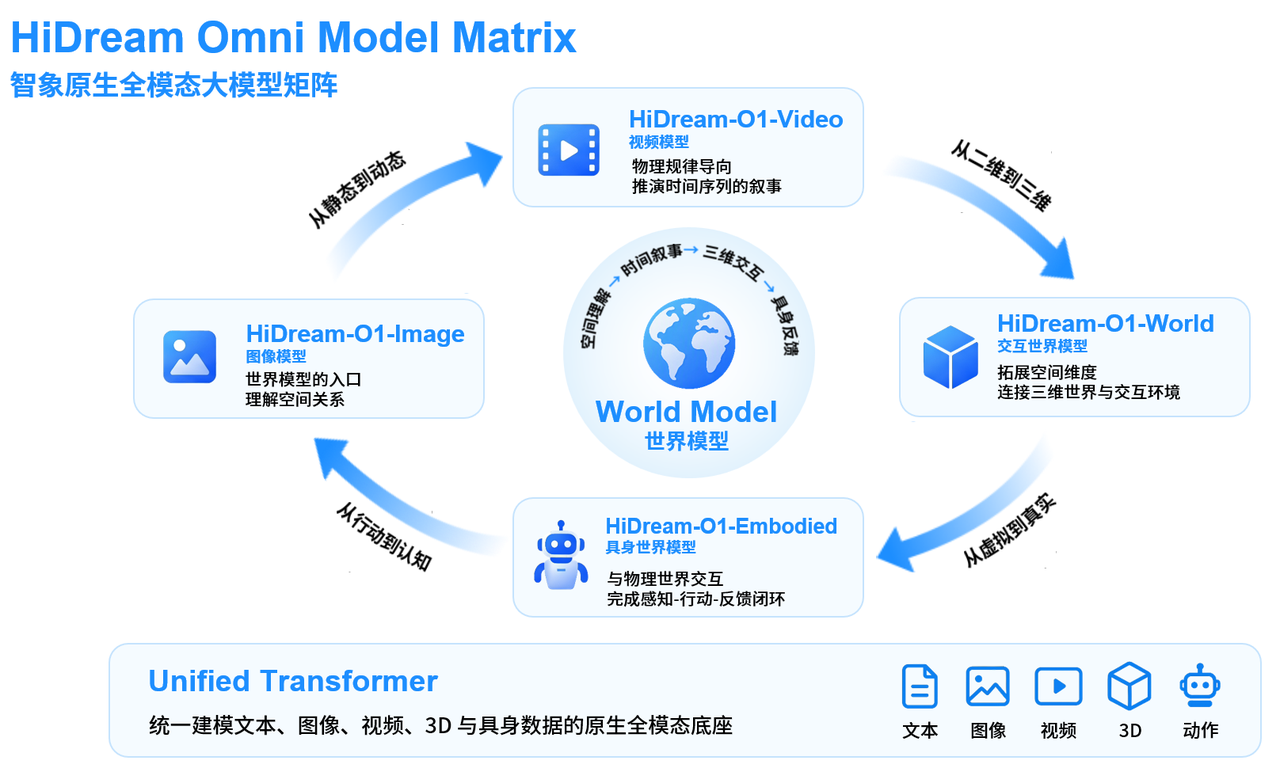
自今年4月HiDream-O1原生全模态世界模型架构发布以来,智象已陆续推出覆盖多赛道的模型家族:
- 图像生成模型HiDream-O1-Image商用1.5版本在Artificial Analysis文生图榜单斩获中国第一、全球第二,开源版本位列全球第二;
- 交互式世界模型HiDream-O1-World位列行业首个交互式世界模型基准WBench综合总榜第一;
- 具身世界模型HiDream-O1-Embodied先后在RoboColiseum扰动适应、空间推理子榜单登顶。
此次视频模型发布后,图像、视频、3D交互与具身动作在统一原生世界模型中交汇共生,业内首个原生全模态世界模型闭环正式成型。
从“听得懂”到“演得真”:意图与物理规律理解成为核心突破点
传统视频生成的痛点并非“画不出来”,而是“听不懂需求”,用户碎片化、口语化、模糊化的输入极易导致意图漏解、镜头跳戏、人物漂移等问题。HD-V1前置多模态意图理解模块,可对用户需求进行结构化规划,统筹镜头时长、场景地点、画面内容、角色动作表情、景别构图、运镜方式、台词与背景音效等全要素,基于“先理解、再规划、后生成”的技术路径避免生成内容“跑偏”。
模型同时将重力、惯性、碰撞、形变、材质、光影、空间连续性等物理规律纳入生成逻辑,让物体运动、角色动作与环境反馈符合真实世界运行规则。为让生成内容更贴合人的真实感知,HD-V1在后训练阶段采用Diffusion Reinforcement Learning技术,设计与人工认知对齐的多模态Reward模型,对音视频内容从画面到声音、从局部到整体进行统一评估,针对性优化高保真画质、叙事连贯性与人物一致性等核心指标。
区别于传统模型需用户在提示词中固定时长的逻辑,HD-V1可根据事件展开逻辑、动作完成周期自主规划生成时长,让时长服务叙事而非内容适配时长。实测嘻哈说唱场景中,人物嘴型、节奏与说唱韵律完全对齐;NBA绝杀场景中,篮球出手轨迹、球员跑动动作、观众欢呼节奏均符合真实物理逻辑与叙事张力。
音画原生一体破解行业通病,生成内容逼近真实拍摄质感
当前多数AI视频模型采用“先画画面后配音效”的后期拼接路线,音画不同步是普遍通病。HD-V1采用原生全模态架构,对文本、视频、音频信号进行联合建模,三者相互约束对齐:画面运动牵引声音节奏,台词音效反哺镜头情绪,文本条件贯穿生成全程。镜头切换时环境声与配乐自然过渡,人物开口时口型、气口与情绪同频,物理动作触发时拟音效果与撞击反馈贴合真实因果。以乒乓球弹跳场景为例,模型生成的乒乓球掉落节奏、声音高低变化均符合现实物理规律。
两项国际权威榜单验证实力,中国视频生成模型跻身全球第一梯队
发布同期HD-V1首次参与两项国际独立模型评测:在Artificial Analysis Image to Video Leaderboard(With Audio)榜单斩获全球第四,在Arena.ai Image-to-Video盲测榜单位列全球第八,跻身全球视频生成模型第一梯队。智象未来CTO姚霆表示,视频生成的代际进化核心是模型对创作者意图与真实世界规律的理解,而非单纯的像素提升与时长延长,此次榜单成绩是对智象原生全模态技术路线的直接验证。