行业最新趋势显示,将大模型推理的KV Cache缓存交由CPU托管,可大幅降低重复计算开销,提升推理效率,已成为AI优化领域的热门技术方向。
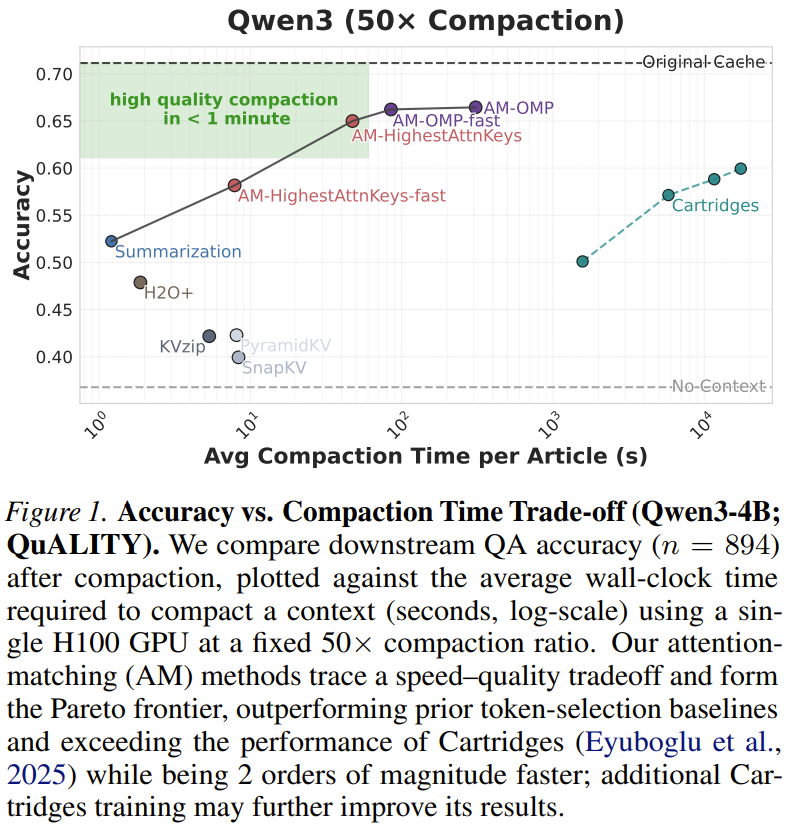
MIT提出Attention Matching技术,将大模型KV缓存压缩50倍且几乎不掉精度,有望彻底改变大模型推理的高显存困境。