
TinyFish是什么
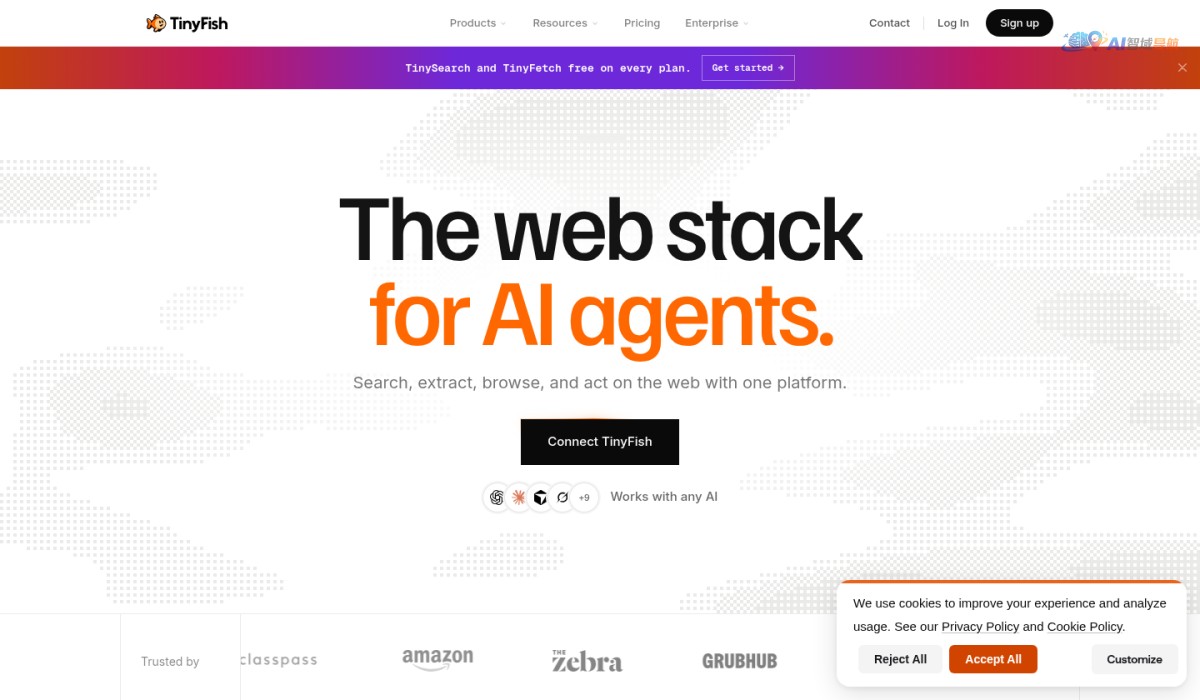
TinyFish的定位不是供人直接使用的浏览器,而是智能体访问和利用网页的底层设施。它把网页相关动作拆分为搜索、抓取、操作等可调用能力,让AI智能体先找到信息,再读取内容,必要时在页面上完成点击、填写等交互,从而把“访问网页”纳入任务执行闭环。
对开发者而言,TinyFish的价值在于将网页访问能力基础设施化,减少重复建设,把精力放在任务编排、结果校验和业务逻辑上。
核心功能
| 能力方向 | 主要作用 | 对智能体的意义 |
|---|---|---|
| 网页搜索 | 根据查询定位候选页面 | 缩小信息范围,辅助筛选 |
| 网页抓取 | 读取并解析页面内容 | 获得可处理的结构化信息 |
| 网页操作 | 执行点击、填写、导航等动作 | 完成多步骤页面任务 |
| 结构化输出 | 整理结果并降低噪声 | 便于调用、串联和二次处理 |
典型使用流程
- 明确任务目标和所需信息,设定搜索关键词或目标页面类型。
- 调用搜索能力获取候选结果,筛选相关且可信的页面。
- 调用抓取能力读取页面内容,提取正文、标题和关键字段。
- 若任务需要交互,调用操作能力完成点击、填写、提交等步骤。
- 汇总结果并进行校验,将结构化信息返回给智能体或上层应用。
适用场景与价值
- 信息检索与调研:帮助智能体快速定位并读取所需资料。
- 内容抽取与监控:从页面中提取关键信息,支持持续观察和整理。
- 网页流程自动化:在页面中执行交互动作,推进任务完成。
- 多智能体协作:作为网页工具层,为不同智能体提供统一网页访问能力。
TinyFish让智能体具备从搜索到抓取再到操作的连续能力,提升任务闭环程度,同时以结构化结果降低集成和二次处理成本。
使用边界与注意
- 页面内容动态变化,抓取和搜索结果需要校验,并设置重试或兜底策略。
- 网页操作应遵守权限和合规要求,避免越权执行动作。
- 复杂页面可能存在解析失败或交互异常,需要错误处理和人工复核机制。
- 抓取结果应结合来源、时效和上下文判断,不宜直接视为绝对准确。
