逃离具身数采:40元接单20元雇人、合格率50%、利润为负

李星浩从华盛顿大学计算机工程系毕业回国刚满一年,已有多段AI原生产品创业经历。2026年2月,NVIDIA发布EgoScale和DreamDojo两篇论文,展示用人类第一视角数据训练具身模型的成果。有从业者向「电厂」形容,这让“给人带上Sensor,用回收的数据训练机器人”成为市场共识。几乎同一时间,“具身模型训练存在千万小时级数据缺口”成为不少具身企业对外发声的常见口径。李星浩抓住这个机会,投身具身数采,试图用校园众包组织学生采集第一视角数据。但首轮采集提交后,机器人公司甲方只给出50%的有效率。支付学生的佣金已经吞噬全部利润空间,甚至不足以覆盖前期组织和流程成本。他最终终止项目,“逃离”了这门看起来需求旺盛的生意。
李星浩把40元时薪拆成20元佣金
作为一级分包商的大厂,初步给李星浩开出的价格是每小时40多元,最终按机器人公司判定的有效时长结算。李星浩则向参与采集的校园学生众包承诺每小时20元佣金,基本持平最低小时收入标准,按学生在场地内的实际时长结算。每个学生的日兼职时长一般为3小时。中间的价差,原本被李星浩设计成利润来源。
按单日计算,他的账本是:单日有效小时数×40元-学生人数×3小时×20元=利润。2026年麦当劳的时薪是20.5元,20元佣金恰好卡在最低小时收入标准附近,用来吸引学生参与。李星浩的设想是,用起码持平麦当劳时薪的佣金吸引用户采集,最终发展出一个遍布全球的去中心化团队。曾有“懂行”的分包商向他直白指出,这是一个一定会赔本的价格。李星浩很快意识到,游戏规则比想象中残酷。
首轮数据只换来50%有效率
校园项目完成首轮采集并提交数据后,机器人公司甲方仅为李星浩团队提交的数据开出了50%的有效率。这意味着,单是支付给学生的佣金就已经吞噬了他预留的所有利润空间。若按学生实际时长支付,而甲方只按有效时长结算,李星浩面对的是双重挤压:学生干满3小时,他就要支付3小时佣金;甲方验收时,可能只认其中一半。组织成本、设备调配、流程管理、前期投入都还没有算进去。
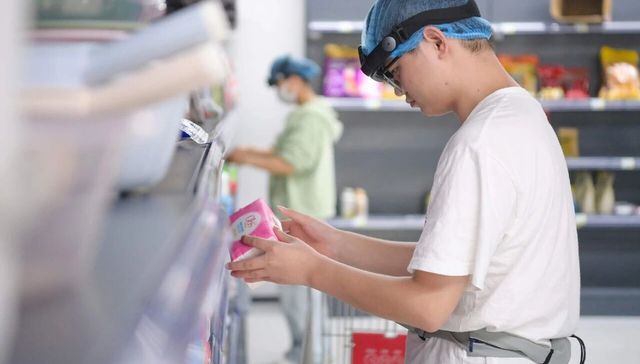
这也是李星浩终止项目的直接原因。他的创业设想被打破:原本想用20元时薪的众包网络,链接分散的Ego数采员,填补机器人公司需要的数据缺口;现实却是,二包向上游没有议价权,向下又要按时长支付佣金,验收标准却掌握在机器人公司手里。合格率50%不是一个孤立的数字,它直接改写了这门生意的利润公式。支付学生的佣金已经吞噬全部利润空间,甚至不足以覆盖前期付出的组织和流程成本。
120元发包价一路滑到30元
在李星浩感知中,那家终端机器人公司给一级分包商开出的每小时成品数据收购价在80-100元区间,远超过向自己报价的40元。但作为二包,他并没有议价权。多位二包向「电厂」提及,由于入场的人越来越多,以及数采设备覆盖率提升,数采价格在逐渐下滑。
Ray回顾,团队做四目数据比较多,五月底刚开始时见过每小时120元的发包价,到8月基本稳定在30-60元区间。原本每小时60元的报价,下滑到50元、55元。墨然在自动驾驶数据标注行业有多年从业经验,并在9月转向具身数采。他提供了更长时间跨度的观察:数采报价整体在往下降,今年初光轮智能的报价曾给到约100元每小时,但现在市面上这样的价格很少见了。老台则称,去年每小时能卖200多元的数据,今年只能卖100多元。
价格下滑并非只发生在Ego数据。上述具身数据服务公司创始人告诉「定焦One」,原本对外定价300元/小时的Ego Centric数据,甚至会被压价到几十元。另一名受访者给出的成本账是:采集取中间值,成本大概40元一小时,标注成本也算40元一小时,总成本大概80元;但最终卖给机器人公司,一小时120元已经是“见过最便宜的”,大多数集中在每小时200-300元。问题在于,层层分包之后,价格并不总是流向真正干活的人。
村里大姨戴PICO切菜,时薪5元还有人跑路
具身数据采集的链条正在变长。机器人公司通常将数据采集任务发布给分包商,后者再将订单转包给更下沉的团队,由他们组织人员、设备和具体场景完成采集,这一流程称为“放单”。在该数据采集服务商接触的项目中,上游拿到百元级订单后,分包给服务公司的价格降至70-90元/小时,再向下拆分,结算到一线采集员时仅剩40-15元/小时。这些数字来自不同项目,不能简单视为同一订单的固定分成,但层层压价的现象被多名受访者反复提及。
更下沉的场景已经进入村庄。一位数据代理商透露,一个头部数据采集公司融资金额几十亿元,然后在山东、河南一些地方搞“进村采数据”,让一个村的老太太、大姨戴着PICO的VR设备做切菜、做饭等任务,一小时一单给5块钱。离谱的是,有一线人员反馈,组织数据采集的中间商最后直接跑路,连这点劳务费都没结。灵御智能联合创始人兼CEO金戈估算,在中国采集无本体数据,即使采用低成本方案,人力、设备、存储和传输等成本合计,每小时仍需20元至40元。对于每小时仅售几元的数据,采购方需要核查其是否存在重复销售、私留副本或其他来源问题。王健将部分中间商比作数据“粮商”:终端买家需要十万小时乃至百万小时级数据,供应商从分散采集点收货,经过去重、加工后统一打包交付;由于能够消化海量数据的买家有限,谁掌握订单,谁就在很大程度上掌握分包和定价权。
百万小时缺口挡不住负利润
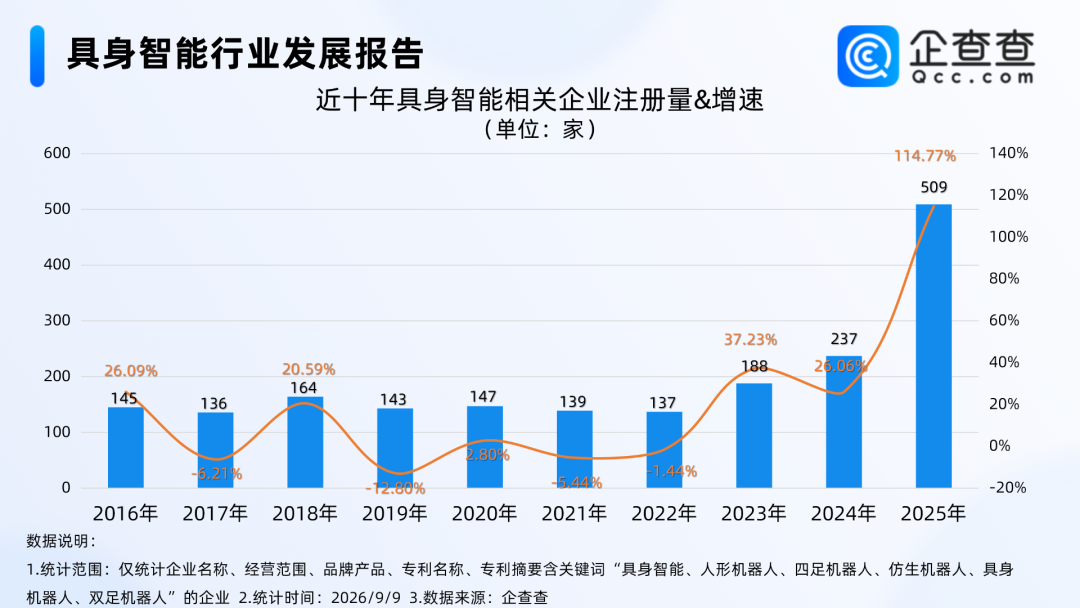
缺口看上去仍然巨大。据贵州省大数据局今年7月披露,当前我国真实场景合规数据存量约50万小时,而商业化落地需要数千万小时,缺口超过99%。但缺口并不自动等于利润。数据有效率低、同质化严重、数采公司之间竞争内卷,导致价格越来越低。国内数据生产商平均毛利约为20%-30%,海外市场毛利可达30%-50%,可对二包和一线组织者来说,20元佣金、50%有效率和不断下滑的发包价,足以把账本压成负数。
变化也在发生。9月初OpenAI发布GPT-6 Astra后,社交媒体上出现大量用Astra控制机械臂做各种任务的测试,一些通用大模型公司开始采购具身数据。一家成立一年半左右的具身数据服务公司,最近两周接到的数据采购订单超过此前两个月的量。DeepSeek也被曝筹备具身智能相关业务和投资。但订单爆单并不意味着所有数采环节都能分到利润。验收标准正在从“交了多少小时”转向“机器人多学会了什么”,国家数据局近期在行业高质量数据集建设链主工作座谈会上提出“以需定供、以用促建、以评提质”。当机器人公司追问数据有没有合法清晰授权、客户是否真正在用、能不能持续复购和回款,仅靠复制数据、压低人力价格、做高账面订单的生意,空间只会越来越小。
李星浩的项目终止,只是这场数采淘金热中的一个切面。人类向AI售卖真实劳动数据,让机器人变得更智能,这些机器人以后很可能再来取代人类。如果这种不安和焦虑逐渐放大,谁还愿意为机器人提供“养料”?对李星浩们来说,40元接单、20元雇人、50%合格率的账本已经给出答案:在具身智能的宏大叙事里,最先被挤出去的,可能不是数据需求,而是没有议价权、还要替验收风险买单的二包。
