Token效能提升120%!这家国产AI存储厂商拿下多项“全球第一”,凭什么?

近期,AI大模型产业进入落地深水区,存储系统作为算力链路的关键环节,其读写效率、协同能力直接决定大模型训练与推理的性价比,不少企业普遍面临Token调用成本高企、读写延迟大、数据合规风险高等痛点。一家国产AI存储厂商凭借全栈技术优化,不仅实现了Token效能提升120%的跨越式增长,更拿下了多项全球基准测试的第一,引发行业高度关注。
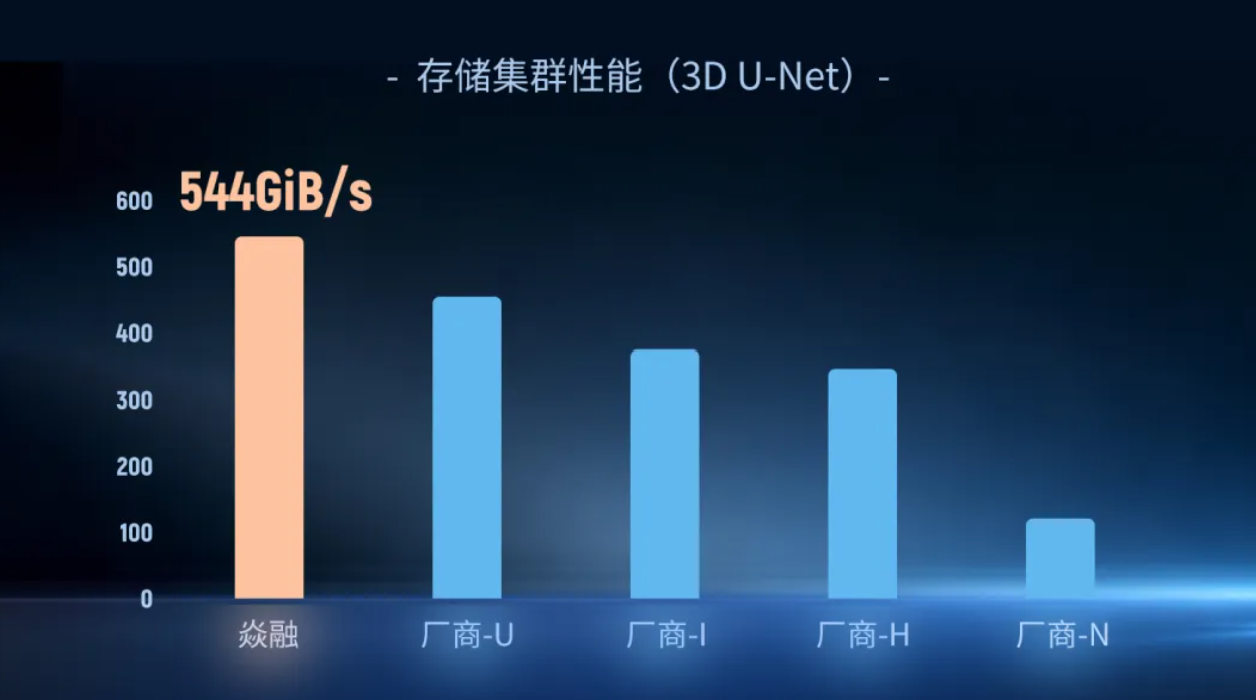
三节点带宽刷新全球纪录,啃下大模型训练存储硬骨头
大模型训练需要持续从存储系统读取TB级的海量参数与训练数据,传统分布式存储方案在多节点集群场景下普遍存在带宽不足、读写延迟高的问题,极易成为算力释放的瓶颈。本次该厂商通过存储架构的底层重构,实现了三节点带宽的全球权威测试纪录刷新,大幅提升了高并发场景下的数据读写效率,为后续的Token效能提升打下了坚实的硬件基础。
全栈协同+多级缓存优化,Token效能提升120%落地
该厂商并未采用单点技术优化思路,而是走全栈协同路线:以华为OceanStor A系列高性能存储为数据底座,深度融合华为UCM推理记忆数据管理技术,搭配中科弘云智算互联网云服务平台HyperCN的能力,通过KV Cache多级缓存管理、秒级算力调度、分钟级大模型推理部署以及全流程AI工具链,实现智能算力的高效输送至业务一线。
实测数据显示,相较于零散拼凑多厂商软硬件的传统项目,该厂商的全栈方案词元产出效能(相同场景下单位算力日均Token调用量)提升超过20%,针对特定大模型推理场景的优化更是实现了Token效能提升120%的突破,大幅降低了跨产品兼容带来的算力损耗。截至2026年12月,AI Agent赛道企业Manus上线至今已处理超过147万亿个tokens,对存储系统的读写效率、稳定性提出了极高要求,该厂商的方案恰好适配这类高负载场景的需求。
全栈国产化适配成熟,多项全球第一实至名归
随着国产AI芯片市场占有率逐步提升,国产AI芯片与国产大模型的协同适配正从“单点突破”走向“联合体推进”。IDC调研数据显示,当前政务行业新建智算项目已100%采用全栈国产化方案,大型银行机构的核心业务系统逐步完成国产化适配,能源、制造等行业的国产化替代进程也在不断加速。
该厂商依托国产技术栈的深度适配优势,在多个全球权威AI存储基准测试中拿下第一,不仅验证了其技术实力的全球领先性,也标志着基于“国芯+国模”的全栈国产化解决方案已迈入实质性规模化部署周期。当前推理算力已占据智能算力的六成,其中企业自建智算云贡献的线下推理算力占比超过34%,政务、金融、能源等强监管行业的核心业务推理需求正不断通过物理隔离或逻辑强隔离实现线下部署,该厂商的国产化方案恰好契合了这一市场趋势。
三大核心价值凸显,破解企业AI算力落地难题
Token效能的提升直接为企业带来了可感知的落地价值,核心体现在三个方面:
- 成本端:随着Token计费模式普及,