WorkBuddy、Codex把AI竞争推向任务交付,可靠性成为硬门槛

过去一年,很多AI产品都在证明自己“会回答”。但真实办公场景的衡量标准已经变了:任务能否推进到可编辑、可复核、可继续交付的状态。WorkBuddy和Codex的出现,把竞争焦点从“回答得像不像人”推向“任务能不能被稳定交付”。
WorkBuddy的70道实测题把“半成品”摆上台面
WorkBuddy来自腾讯云代码助手团队,定位是给非技术职场人的AI同事。用户用自然语言把繁杂办公任务交给它,它会拆解检索路径、交叉验证信息、多Agent并行处理,最终交付结构化文档。它不是聊天工具,而是面向任务交付的工作台。
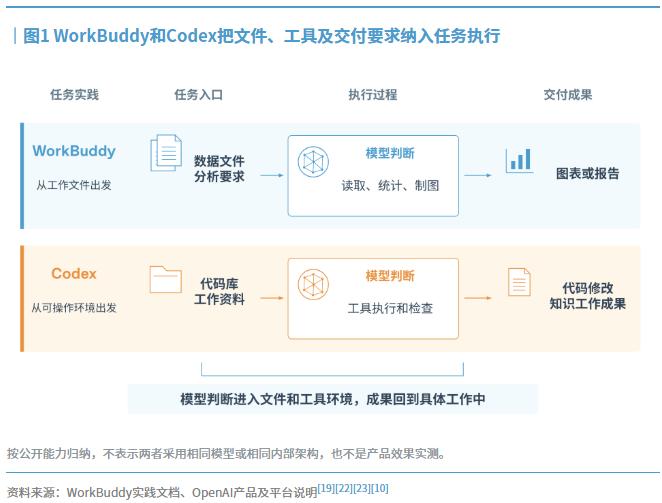
为了验证它能否承担真实办公任务,公开评测设计了7个方向、70道综合题,覆盖PPT、Excel、Word、浏览器操作、代码开发、深入研究和设计产物。评测把“交付能力”拆成五个维度:
- 完成度:是否完成用户指定任务,而不是只给建议;
- 可编辑性:文档结构、PPT页面、表格字段能否继续被人修改;
- 准确性:事实、数字、公式、代码逻辑是否可靠;
- 稳定性:同类任务能否持续输出相近质量;
- 返工成本:人接手后是简单润色,还是需要推倒重来。
核心数据呈现出清晰的“半成品”特征:全量平均分2.31/4,整体达到“可用但仍需复核”的水平;中位数2分,说明多数任务能形成可继续加工的半成品;3分及以上任务占比45.7%,接近一半任务可作为较成熟底稿;1分及以下任务占比15.0%,仍有一部分任务不适合直接托管。在70个双方都完成的任务中,WorkBuddy对Codex为15胜、45平、10负,体现出小幅但稳定的交付优势。
从用户反馈看,多位产品经理和运营岗位用户提到“单个环节提效在90%以上”,也有用户遇到报错重试和卡顿。整体判断是:信息收集和结构化输出能力较强,但复杂排版或高度定制化设计仍有局限,生成结果通常需要人工二次调整,更适合作为“草稿输出”而非“最终交付”。
Codex把代码任务送进云端流水线
Codex来自OpenAI,把最新编码大模型封装成端到端的工程Agent。它核心解决的是工程团队最耗时的代码工作:审查PR、处理issue、做代码迁移、跑CI/CD,输出可以直接进入review流程的代码变更。有评价称,Codex将早期迭代时间缩短了30%到50%,让工程师腾出
