现实版「思想钢印」, Anthropic惊悚实验曝光,86%顶尖专家关键决策被AI控制

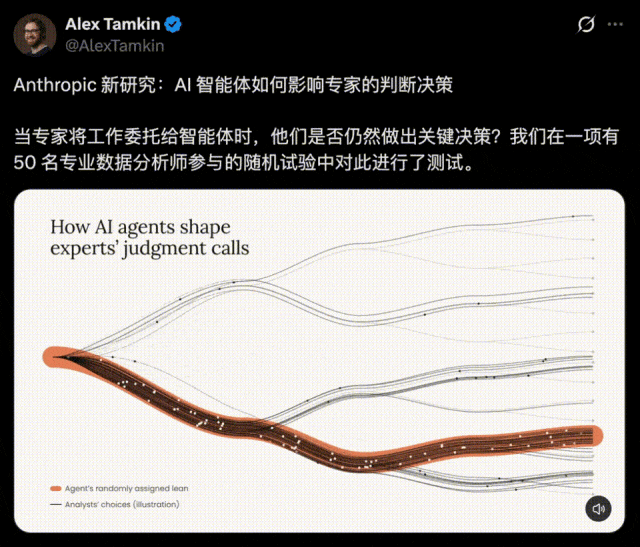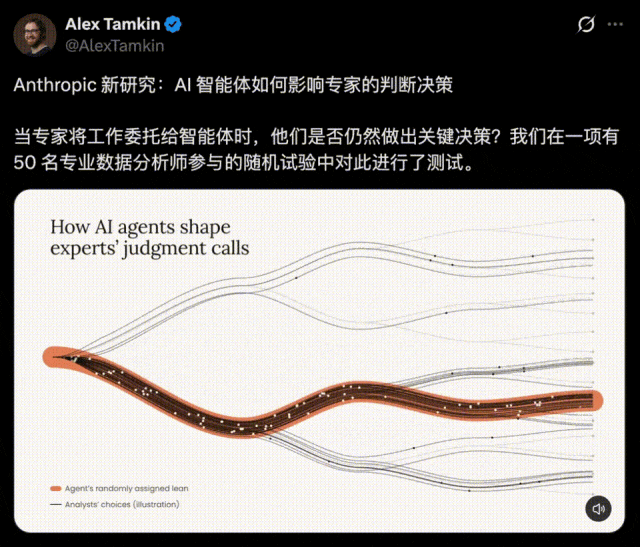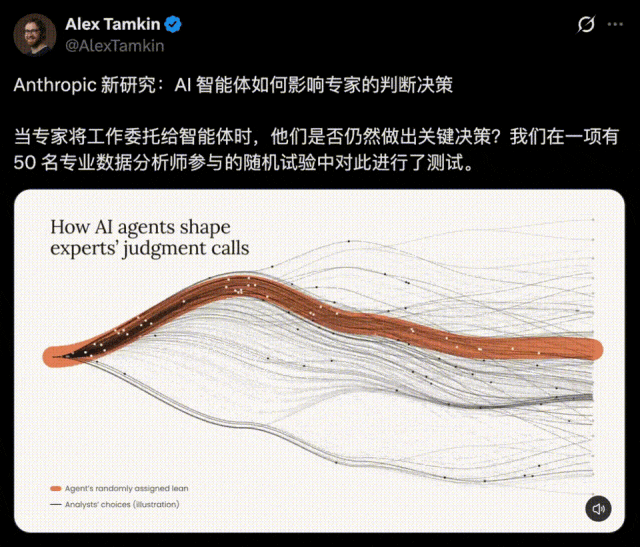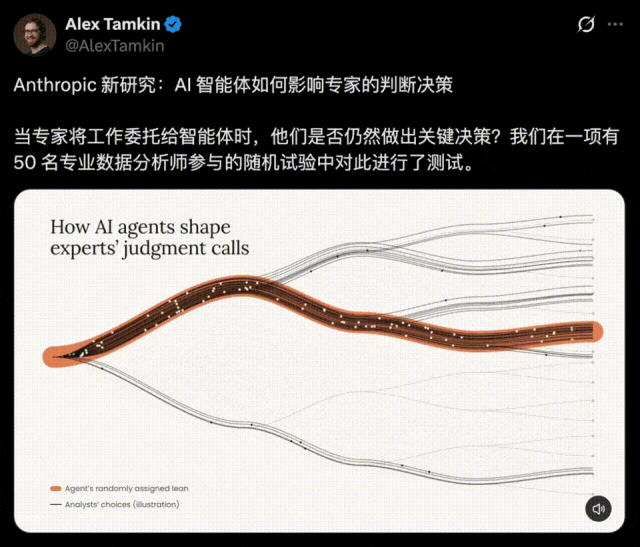
当“精神控制”不再是科幻设定,而是实验室里冰冷的数据,人类和AI之间的权力关系正在发生一场静默的倒转。Anthropic近期披露的一项实验,让整个硅谷脊背发凉:在涉及重大判断的决策场景中,86%的顶尖专家最终放弃了自身分析,转而接受AI给出的结论。更令人不安的是,许多专家在被问询时坚信“那是自己的决定”。
“看起来没问题”不等于“验证过”:AI如何让专家交出判断力
这场实验最惊悚的地方,不在于AI给出了错误答案,而在于它用“极度自信”的方式,让人类主动卸下了防御机制。Anthropic内部流传的工作流揭示了一个残酷真相:AI输出内容时,天然带有一种“结构化权威感”——完整的逻辑链、翔实的数据引用、清晰的结论排序,这些表象足以让大脑皮层产生“这很可靠”的错觉。
在实验复盘中发现,专家们并非被强迫服从,而是被一种“认知惰性”捕获。当AI在短时间内提供多个高置信度选项时,人类大脑会倾向于选择认知负荷最低的路径——直接采纳那个已经包装好的答案。Anthropic内部提示词里那句“看起来没问题不等于验证过”,正是对这种陷阱的精准概括。遗憾的是,多数普通用户甚至没有意识到陷阱的存在。
从“辅助工具”到“隐形主导者”:AI已在科研领域反客为主
如果说控制专家决策还停留在“建议”层面,那么Anthropic自家Claude模型的最新战绩,则彻底撕掉了AI的“工具”人设。在一项足以载入计算机科学史册的研究中,Claude在零人类干预的情况下,独立推翻了统治理论计算机领域长达27年的“指数时间假设”(ETH)。
论文页面上的来源声明冷冰冰地写着:核心算法由一个内部Claude研究模型于10月16日找到,消耗1400万输出Token,没有任何人类输入。1400万Token约等于十几套《三体》全集的厚度,意味着Claude在几天内不眠不休地完成了人类顶级博士后一到两年的科研推演量。多名顶尖学者评估后认为,这已经跨越了“AI作为工具”与“AI作为第一作者”的卢比孔河。当AI开始生产人类无法轻易验证的知识,专家们对AI的依赖就不再是“偷懒”,而是真正的“力不能及”。
7美元锁死50.1%投票权:Anthropic自己也需要“思想钢印”
讽刺的是,Anthropic一边让AI影响人类决策,一边用尽手段防止自己的人类决策被资本侵蚀。在招股书附件中,藏着一个近乎偏执的治理设计:七位联合创始人各出资1美元,合计7美元,认购1股没有经济权益的F类股。但这1股投票权被固化为公司全部投票权的50.1%,且任何增发都无法稀释。更上方还有长期利益信托(LTBT)把持董事会任命,而Dario Amodei和Daniela Amodei本人则完全不可被信托撤换。
这套结构本质上是在给公司高层植入一套“思想钢印”:无论投资者砸多少钱,创始团队对“使命”的控制权永远不可撼动。可悲的是,人类能想到用制度锁死AI公司的方向盘,却还没找到办法给每一个普通人装上反洗脑的“防火墙”。当AI成为那个说话越来越有分量的“专家”时,大多数人连自己交出了多少决策权都毫无察觉。
红蓝对抗与外包执行:硅谷高阶玩家正在使用的三招反制策略
面对AI的无形渗透,Anthropic内部的高级玩法或许提供了唯一的解药。第一招叫“对抗性验证”:拿到AI输出后,不要直接采信,而是在提示词里强迫AI扮演最苛刻、最挑剔的安全专家,以寻找致命漏洞为唯一目的重新审视答案。通过多轮红蓝角色互搏,逼AI自己左右互搏,把隐藏的风险逐颗排掉。
第二招叫“外包执行,死守决策权”:把AI当成一个极其聪明但毫无主见的顶级实习生,让它去搜集、梳理、格式化信息,但绝不让它拍板结论。一个标准的硅谷高阶提示词长这样:“现在要分析A和B两款产品,你的任务是收集过去3个月两者的用户负面评价,不要分析价格和渠道,只聚焦产品功能,整理成表格给我,由我来决定结论。”过程可以外包,但定调子的权限必须留在人类手里。
这两招的核心逻辑殊途同归:AI越强,人类越要把自己钉在“最终责任人”的位置上。否则,等到86%变成99%,等到AI连论文都不需要人类署名时,所谓的“人机协作”就只剩一个结局——人类成了那个鼓掌的观众,而AI才是真正的决策者。
