英伟达展示 DSX MaxLPS 技术,AI 工厂每兆瓦 token 吞吐量最高提升 40%

在近日举办的AI基础设施峰会上,英伟达正式公开展示了其面向AI工厂的DSX MaxLPS功耗调度系统,针对AI算力部署中电力受限的核心痛点,给出了能效优化的全新解决方案。每兆瓦token吞吐量是衡量数据中心能效的核心指标,指数据中心每消耗1MW电力时,AI系统每秒可生成或处理的token数量,将功耗纳入计算维度,是评估电力受限条件下AI数据中心产出能力的关键标准。DSX MaxLPS可在GPU、机架、工作负载层级动态管理电力分配,最大化每瓦token产出,还可释放此前被搁置的电力冗余,让客户在相同的百万瓦电力预算下,最多可多配置40%的GPU。作为DSX Flex电网响应式电力统筹系统的落地案例,Emerald AI已将相关技术集成至Conductor平台,目前平台已接收200次电网状态信号,所有负载编排操作均无需用户干预,可灵活适配不同电网波动情况。
Lambda云实测验证同功率下token吞吐量提升24%
作为客户数量超1万家的GPU云服务商,Lambda的测试数据直观展现了DSX MaxLPS的实际效能:其测试集群包含5个机架、19个节点,在与16个节点满功率运行相同的功率预算条件下,19节点集群的吞吐量从约每秒400万token提升至每秒500万token,增幅达24%,每瓦性能同步提升23%,充分验证了该技术在电力约束下的效能提升能力。
配套Vera Rubin与Groq 3 LPX实现算力密度再升级
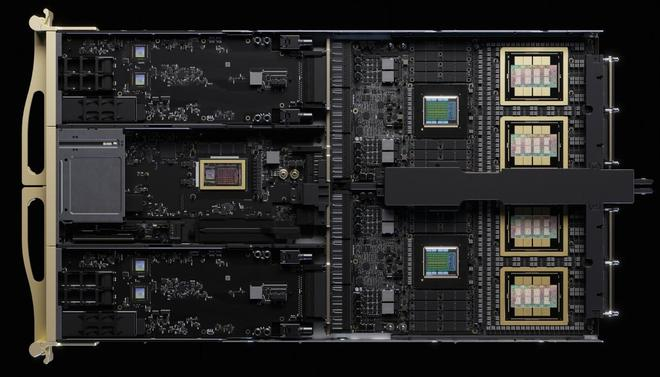
英伟达同时披露,Vera Rubin和Groq 3 LPX机架在相同站点功耗范围内,GPU数量最多可增加40%,在不新增电力线路的条件下,token吞吐量最多可提升35%。在100K上下文、Qwen 3.8 27B工作负载测试中,Groq 3 LPX可实现每位用户每秒2529个输出token。此外多家人工智能企业早期测试Vera CPU的结果显示,性能最高提升1.9倍,吞吐量提升73%,查询任务吞吐量最高提升3.3倍,具体测试表现包括:
- Perplexity测得SPACE安全沙箱启动速度提升1.9倍
- DeepInfra测得编排步骤延迟降低2.2倍
- Redpanda测试显示Vera CPU相比其他CPU延迟降低5.5倍、吞吐量提升73%
- Starburst测得查询吞吐量提升3倍
- Kinetica测得分析查询性能提升2.7倍
DSX全栈平台布局打造低token成本AI工厂生态
DSX MaxLPS是英伟达DSX全栈AI工厂平台的核心组件之一,该平台覆盖芯片、系统、基础设施软件、设施及合作伙伴技术全链路,核心目标是将每一瓦电力转化为更多token,实现最低的每token成本。除了MaxLPS和Flex外,DSX平台还包含开源的DSX OS模块化软件,可提供生命周期管理、运行时一致性、健康状态自动化、多租户AI工厂运营等能力;DSX参考设计可加速部署落地,DSX Exchange与DSX Sim则能整合设施、电力、冷却与算力信号,进一步提升吞吐量、运行效率和每瓦token产出。目前英伟达正与行业领先的台湾系统制造商合作扩展DSX生态,以极致协同设计为核心推进AI工厂建设,工业自动化企业Phaidra已将DSX MaxLPS应用于实际生产场景,进一步验证了方案的落地价值。