一位诺奖学者对AI版权案的终极提问:十年后,谁还愿意写那些被白嫖的真话?

当法学界还在争论AI生成内容是否构成侵权、美国司法部忙着审视大模型时代的竞争格局时,诺贝尔经济学奖得主约瑟夫·斯蒂格利茨把问题拉回到了更底层的逻辑:如果“合理使用”成为科技巨头无偿吞噬原创内容的万能通行证,信息生态会不会在十年内彻底崩塌?这个问题并非杞人忧天。从张家港法院对“幻之翼”AI图片的定性,到杭州互联网法院在“奥特曼案”中对训练端侵权的暧昧态度,再到MIT因AI造假撤稿风波而被迫重建学术诚信机制,一条清晰的链条正在浮现——当白嫖成为制度性安排,真话的生产者正在被系统性挤出。
斯蒂格利茨的追问:信息生态会不会因“合理使用”而崩塌
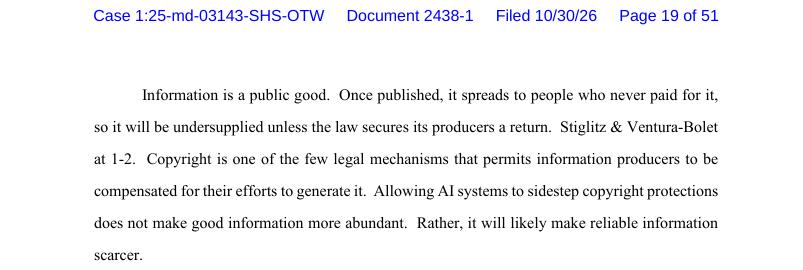
在关于AI版权的一系列讨论中,主流叙事长期被“侵权认定”和“市场竞争”两个框架占据。法学家们争论AI生成图片是否具有独创性,反垄断执法者关注大模型公司是否滥用市场支配地位,但斯蒂格利茨的视角截然不同:他把版权制度看作信息生态的激励基础设施,而非单纯的法律技术问题。按照他的逻辑,版权保护的本质不是给创作者发福利,而是确保社会有持续生产高质量信息的动力。如果AI公司可以以“合理使用”为由,大规模、商业化地吞食受版权保护的作品来训练模型,而又不必向创作者支付任何对价,那么创作者的预期收益将趋近于零。短期看,消费者似乎享受了更便宜的AI服务;长期看,愿意投入数年甚至数十年去写一本严肃著作、做一篇深度调查报道的人会越来越少。斯蒂格利茨的提问之所以被称为“终极”,是因为它跳出了个案胜负,直指制度激励的根基:十年后,谁还愿意写那些被白嫖的真话?
这一追问在美国司法部与法学界的讨论中已有回声。中国社会科学院法学研究所研究员李明德指出,当前国内学界和法院更多关注AI输出端是否侵权,而对前端训练阶段使用他人作品是否侵权“有所忽略”。杭州互联网法院在“奥特曼案”中倾向于认定模型训练中使用他人作品不构成著作权侵权,李明德对此明确表示质疑:“人工智能训练中对于他人作品的使用属于商业性使用。如果将商业性使用受到著作权法保护的作品认定为不侵权,则著作权法保护作品、鼓励创新的宗旨将在很大程度上失去意义。”
张家港法院的“幻之翼”判决:输入几句提示词不算创作
在输出端,司法实践正在收紧对AI生成内容“作品属性”的认定。张家港市人民法院审理的“幻之翼透明艺术椅”案提供了一个标志性样本。原告丰某某主张自己希望创作具有果冻质感、玻璃般透明的蝴蝶形状座椅图片,但在Midjourney软件中仅输入了简单提示词并设置参数,且无法提供创作过程中相应的流程图等原始记录。法院认为,难以体现其从最初构思到最终选定的整个过程进行了独创性的智力投入,因此案涉图片不符合作品的构成要件,不能认定为作品。
有评论指出,该判决进一步凸显了AI作品的“智力投入”在司法认定中的核心地位。法院通过细化“独创性”标准,强调举证责任和可控性,表明司法对AI生成内容的态度从鼓励创作的包容性探索转向审慎规范。换句话说,仅仅敲几句提示词、调几个参数,并不足以让AI输出物自动获得版权保护。这一逻辑与斯蒂格利茨的担忧形成微妙呼应:如果输入端可以免费白嫖,输出端又轻易赋予版权,那么真正的创作者反而被夹在中间——他们的作品被用来训练模型,模型使用者却可能凭借“ prompt 工程”获得新的版权垄断。
奥特曼案的分歧:技术中立不再是侵权借口
平台责任的认定同样在经历剧烈摇摆。广州互联网法院和杭州互联网法院对“奥特曼AI生成图片侵权案”的判决存在明显差异,折射出司法对AI技术介入程度的差异化评价逻辑。广州互联网法院强调平台对生成内容的技术控制力是责任认定的关键,若技术介入程度高且直接获利,则需突破“技术中立”原则;杭州互联网法院则创新性提出“分阶段责任”,明确平台对用户输入内容无审查义务,但对输出内容需承担合理注意义务。
两地的判决差异并非简单的同案不同判,而是暴露了一个更深层的制度困境:当AI平台的技术能力足以对输出内容进行过滤和干预时,“技术中立”还能不能作为免责挡箭牌?李明德的观点更为尖锐,他认为应当更多地关注前端训练是否侵权,而非仅仅纠缠输出端。如果训练阶段大规模使用受版权保护的作品被认定为不侵权,那么输出端的注意义务再严格,也不过是在下游修修补补,上游的激励扭曲并未得到纠正。
MIT撤稿风波:当AI连“真话”的生产过程都能伪造
版权问题之外,AI对“真话”生产机制的侵蚀还有另一条暗线:学术诚信。2025年,麻省理工学院经济学院官网发布《确保准确的研究记录》声明,表示对一项由博士生托纳-罗杰斯主导、涉及千余名材料科学家AI使用情况的研究“数据来源、可靠性、有效性及研究结论的真实性均缺乏信心”。该论文此前曾得到诺奖得主阿西莫格鲁和业界资深学者奥托的背书,阿西莫格鲁甚至在访谈中谈及若研究情况在整个经济体复现,将大幅影响他过去的研究主张。然而质疑声很快汹涌而至:一个博士二年级学生如何获得数百亿美元公司的高度敏感数据?哪家公司拥有超过1000名材料科学家且从2022年就开始设置随机对照试验?所有1018名科学家如何在每一个类别中都报告具有统计学意义的显著结果?
更令人不安的是,有学者质疑论文参考文献“根本没有出版信息,只是一堆从网上抓取的东西”,其中一个引用竟是“Bostock, J. 2022. 《一位困惑的化学家对AlphaFold 2的评价》”。这些“马脚”之多,让人不得不怀疑数据是否由AI工具辅助编造。MIT校方在声明中虽以隐私为由未披露审查结果,但明确表示对研究真实性缺乏信心。阿西莫格鲁和奥托随后主动向学校纪律委员会和经济学院说明情况,称“MIT的研究诚信至关重要”。这起事件与MIT校长萨莉·科恩布鲁斯2026年8月发布的公开信形成呼应:当AI可以快速交出看起来像答案的东西,大学如何判断一个人真正学到了什么?公开信提出将评估拉回真实的人和完整过程——解释、辩论、动手建造,并诚实说明如何使用AI。这实际上是在试图重建“真话”的生产流程,而非仅仅检测成品。
用AI的人取代不用AI的人,但谁来保护被白嫖的原创者
西门子CEO博乐仁的判断被广泛引用:“AI不会取代人类,会用AI的人却能取代不会用AI的人。”这句话在职场语境下有其合理性,但在版权与创作语境下,它掩盖了一个关键的不对称:会用AI的人之所以能取代不会用AI的人,部分原因在于AI模型的训练数据来自大量原创者的无偿贡献。如果这种“白嫖”被制度化为“合理使用”,那么被取代的将不只是不会用AI的人,还包括那些原本愿意生产高质量信息的人。
中国政法大学数据法治研究院教授张凌寒提出,是否赋予AI著作权与虚拟财产的法律保护问题类似,可以参考洛克的劳动赋权理论,或证实有一定的支配性和排他性。在制度探索上,可以细化“AI辅助创作”的认定标准,明确用户利用AI工具创作时,何种程度的智力投入可被视为具有独创性。但这仍然只是输出端的修补。真正需要回答的是斯蒂格利茨那个更朴素的问题:如果训练端可以免费使用一切受版权保护的作品,输出端再精细地分配版权,整个信息生态的激励链条还能不能转得动?
与此同时,AI短剧的魔幻现实提供了另一个注脚:网友们痛骂AI短剧辣眼降智,却扎堆入场赚钱,“骂得越狠,赚得越多”。当低成本AI内容大量涌入市场,优质原创内容的相对回报被进一步稀释。斯蒂格利茨的追问因此不是抽象的道德说教,而是对制度设计者的直接警告:版权规则如果只保护“表达形式”而不保护“生产激励”,最终被摧毁的不是某一家公司的商业模式,而是整个社会说真话、写深度的能力。十年后,当AI已经能替学生写代码、替老师出作业、替记者生成通稿、替学者编造数据,那些还愿意花力气写“被白嫖的真话”的人,靠什么活下去?
