震撼,谷歌破解了RSI?AI靠「做梦」学会无限进化

近半个月AI圈被一桩悬案搅得沸沸扬扬:谷歌疑似跑通困扰学界数十年的递归自我改进(RSI)技术,相关线索从突现的API截图、紧急收回的内部密钥到反常的模型迭代节奏逐一浮出水面,而刚刚公开的重磅论文,终于揭开了谷歌这条独特RSI路线的全貌。
谷歌API突现神秘RSI模型 泄密事件先掀舆论波澜
事件导火索始于9月11日X平台上一条看似普通的祝贺帖,账号lyra发文向DeepMind道贺,句中刻意大写的三个字母拼在一起刚好是“RSI”,同时放出的谷歌生成式语言API返回截图中,出现了一款名为「rsi-model-liverl-le」的神秘模型,参数规格显示输入上限104万token,输出上限65536token。消息发酵后,谷歌紧急收回了一批可访问上千个模型检查点的内部API密钥,全程未对截图真伪作出任何回应。尽管截图无法被第三方独立验证,也有声音质疑可能是内部测试代号或恶作剧,但它之所以能短时间内传遍AI圈,正是因为和谷歌后续公开的RSI相关论文内容高度契合。
Dream-RSI核心思路公开 AI靠“历史做梦”实现策略自进化
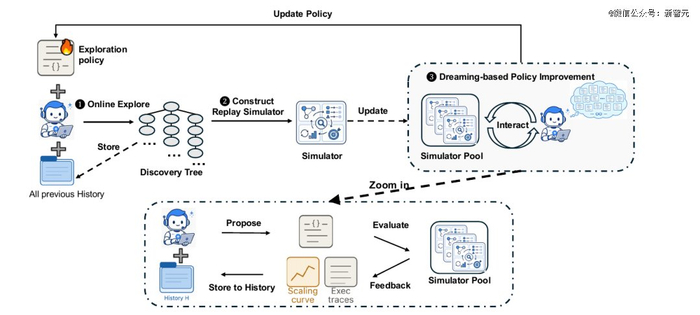
谷歌联合Google DeepMind、马里兰大学及弗吉尼亚大学发表的这篇论文,首次披露了名为Dream-RSI的RSI实现路径:无需修改大模型底层权重,Gemini 3.1 Pro、3.7 Flash等现成模型均可套用。核心逻辑是将AI真实探索过程中的每一步记录存储为“发现树”,这棵发现树就是AI的“梦境世界”——AI无需在现实中反复运行高成本的探索实验,就能在历史形成的发现树中虚拟推演新的探索策略,找到更优方案后再回到真实环境落地,新产生的探索记录又会进一步扩充发现树的规模,形成循环。
论文列出了多项亮眼效果数据:
- 算法优化任务中,主流进化搜索系统需要跑51200代,Dream-RSI仅调用317次就达到同等水平;
- 圆填充问题直接追平谷歌自家AlphaEvolveV2的最强纪录;
- GPU内核优化任务中,VGG16、LayerNorm达到同等性能时生成次数分别暴降2.43倍、1.79倍,ConvDiv、ConvMax在相近计算预算下性能分别提升2.09倍、1.44倍。
论文还披露了一个反直觉的结论:人类给AI总结经验、指明方向塞进Prompt引导探索,效果反而比不干预更差——总结出的“经验”很容易变成偏见,让AI过早集中在少数看似正确的方向,损失探索的多样性。论文一作是马里兰大学二年级博士生Tong Zheng,今年夏天才以学生研究员身份进入谷歌,身后是17人的作者团,包含DeepMind研究员与讲席教授。
谷歌近期反常动作接连落地 RSI迭代飞轮已启动
这次泄密事件并非孤立信号,谷歌近期一系列反常动作早已透出端倪。谷歌联合创始人谢尔盖·布林近期直接搬进山景城总部改造的微厨房当战时指挥中心,U型桌子围坐着DeepMind负责人,谷歌CEO劈柴哥每周多次到场开会,绕开公司层层官僚流程集中资源攻坚RSI。
此前发布的Gemini 3.8Flash和Cyber版本也暗藏线索:官方博客中提到“模型的进展由长时间运行的智能体循环加速,循环用来递归评估、精炼底层模型”,翻译过来就是谷歌已经用AI智能体实现自动评估、优化大模型本身。更反常的是迭代节奏:3.7Flash上线才三周,3.8Flash就接踵而至,传统AI研发一轮训练、评估、调优最少需要一个季度,需要大量研究员、标注人员手动测评,三周一次的迭代速度靠人力根本无法支撑。新版模型成绩同样亮眼:3.8Flash推理基准拿到54.9%,专门做漏洞挖掘的Cyber版本真实漏洞挖掘成功率突破70%。DeepMind研究员姚顺宇点评,这对于模型只是一小步,但对RSI来说是巨大飞跃;另一位研究递归改进的研究员判断,这正是RSI飞轮产生复利效应的特征。此外AnthropicCEO也公开表态,RSI已经在整个行业发生,连自家内部也出现了这类现象。