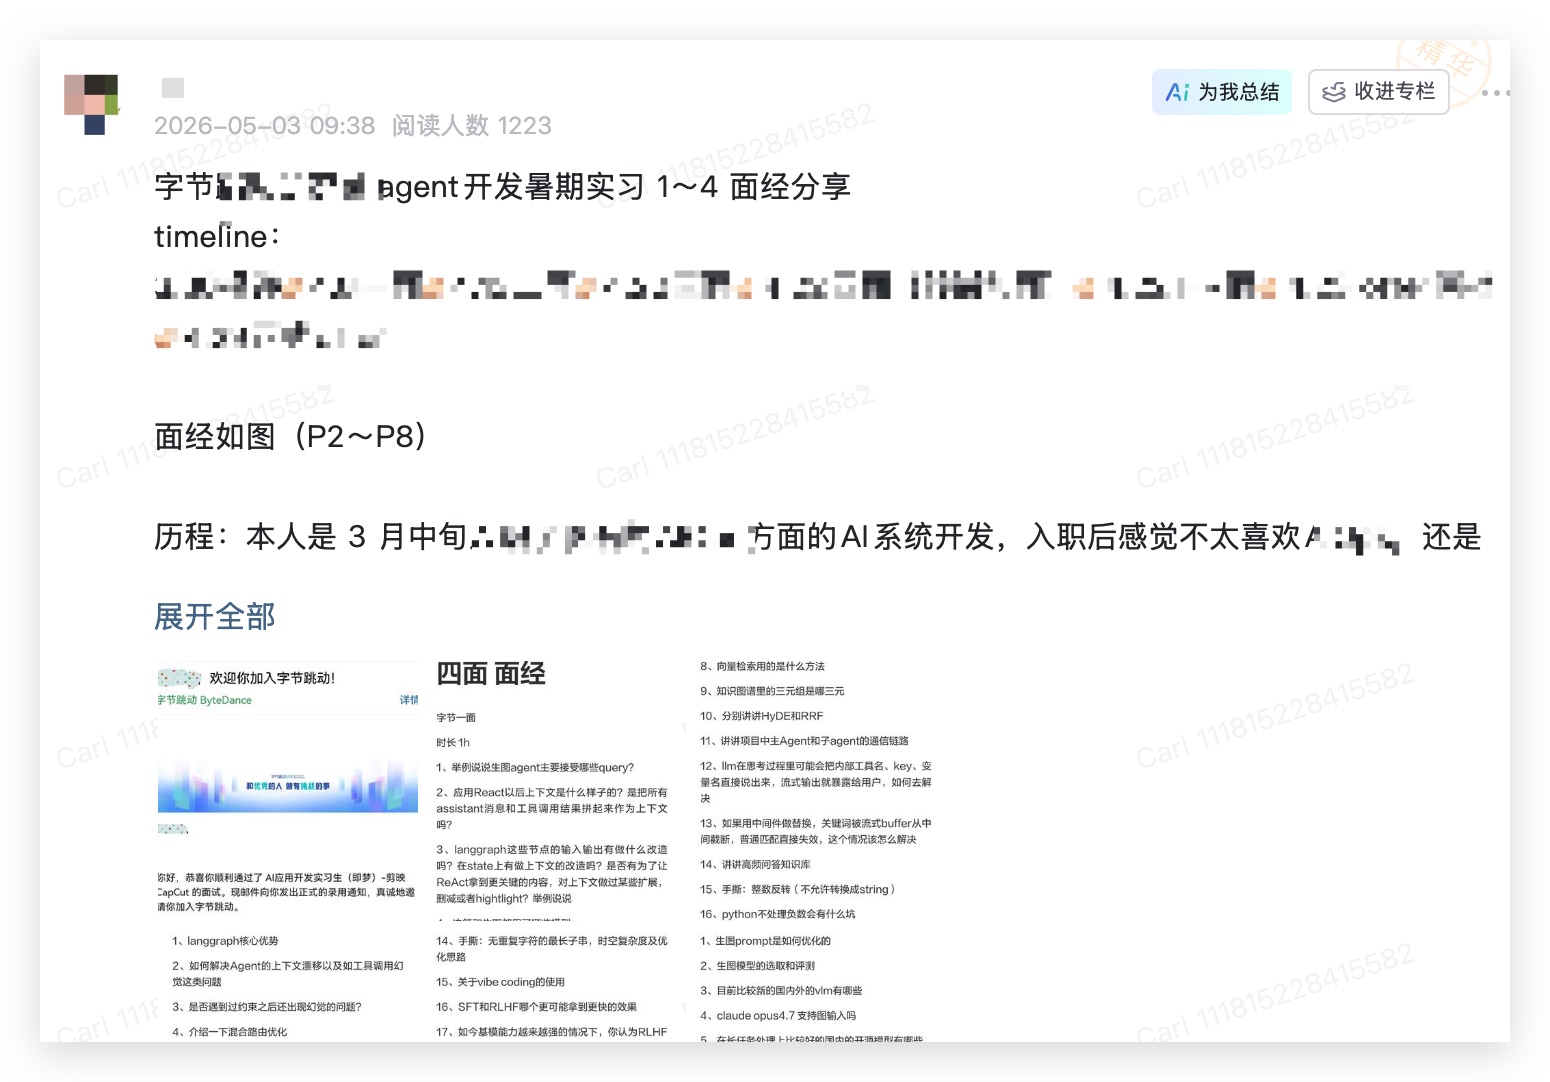
字节二面:"你说skill之间传数据,直接在skill里指定就行——那两个任务并发跑,数据串了怎么办?"

近日,一场AI Agent岗位的二面提问在技术社区引发广泛讨论——当多个Skill(专业技能包)并发运行时,此前开发者常说的“直接在Skill里指定传数据”的方案,为何会出现数据串了的情况?这一问题不仅戳中了当前Skill普及过程中的核心痛点,也折射出AI Agent工作流设计的底层逻辑。
多Skill并发成常态,数据串扰从偶发变高频
随着Agent Skills成为跨AI工具的通用规格,无论是Claude Code、Cursor还是Hermes、Gemini CLI都支持通过SKILL.md文件加载定制化工作流,开发者已经习惯在同一个对话中同时调用多个Skill完成复杂任务,比如一边跑数据分析Skill处理报表,一边调用内容创作Skill生成文案,再启动代码审查Skill校验逻辑。这种情况下,如果Skill之间传数据没有做隔离,很容易出现三类冲突:一是多个Skill的触发条件高度重合、指令逻辑重叠,AI自主判断时可能同时加载两个互相矛盾的Skill,输出结果互相干扰;二是并发运行的Skill如果直接读写同一个全局变量、同一个文件路径,读写操作的时间差就会导致数据被覆盖、串改;三是如果Skill调用subagent(子代理)时直接传递全量内容而非路径,不仅会快速占满子代理的上下文窗口,还可能因为内容传递的顺序错乱导致数据混淆。
业内已跑通“路径隔离+流水线编排”双解法
针对数据串扰问题,当前社区已经沉淀出两类成熟的解决方案:
- 路径隔离式传参:要求Skill与subagent之间、不同并发的Skill之间只传递文件路径,不直接传递内容,每个执行单元自行读取对应路径的文件、处理完成后将结果写入指定路径并仅返回路径信息。比如需要同时跑3个写作Agent处理不同提纲时,给每个Agent分配独立的输入、输出路径,即使并行执行也不会互相干扰,还能大幅降低上下文消耗。部分复杂Skill还会内置subagent调用逻辑,只需给子代理传递文件路径,让其自行读取处理,进一步降低数据串扰的概率。
- 流水线式串行编排:如果任务逻辑有先后依赖,就通过设计Skill调用顺序规避并发冲突,比如先调用创意Skill生成初稿,再调用法务审核Skill把关,最后调用格式调整Skill输出最终结果,让不同领域的Skill各司其职,避免同时加载逻辑冲突的Skill。此外还可以通过动态路由机制,先由Router识别用户意图,再精准调用对应的Skill,从源头减少不必要的Skill加载。
跨平台Skill生态普及,冲突防控成开发标配
不同于GPT、Gem的独立入口模式,Skill支持在同一个对话中灵活调用多个能力,这也是其核心优势,但随着Skill生态从Claude延伸到所有主流AI工具,跨平台、跨版本的Skill冲突防控已经成为开发必备技能。一方面,开发者需要给每个Skill设置足够具体、有区分度的触发条件,避免描述过于泛化导致AI判断失误;另一方面,企业内部可以参考代码库的管理模式搭建Skill Registry(技能注册中心),统一管理内部Skill的版本,避免不同版本的Skill逻辑冲突。此外,像Hermes这类支持Self-Improving(自改进)的Skill系统,还能根据用户的使用反馈自动优化Skill的执行逻辑,进一步降低冲突概率。当然也要注意Skill的适用边界,其最适合的场景是「流程清晰、重复发生、有固定输出格式」的任务,而对于太开放、需要大量临场判断的任务,直接和AI对话反而灵活性更高。同时Skill的维护成本也需要纳入考量:一旦工作流、输出格式发生变化,就需要及时更新Skill文件,否则AI会按照旧逻辑执行,反而引发更多问题。
面试题背后:Skill开发的正向实践逻辑
这场字节二面的提问,实际上考察的是开发者对Skill运行机制的深度理解,而非简单的功能使用。从当前社区的实践来看,合格的Skill开发者需要掌握几个核心原则:一是尽量减少SKILL.md里的平铺信息,通过引用外部文档的方式降低上下文负担,让Agent更聚焦;二是明确Skill的调用边界,需要并发执行的Task尽量通过subagent拆分,各自独立运行,有依赖关系的Task通过串行编排完成;三是做好Skill的迭代维护,及时根据实际使用反馈调整执行逻辑。这些实践经验,也正是当前AI Agent开发领域正在快速沉淀的标准范式。